图像与视频生成 AI 新闻 — 2026-09-25
闭源阵营因 Seedance 2.5 的快速普及与 Sora API 停止服务而加速重组;开源阵营中,仅 7B 参数的 Qwen-Image-2.1 已接近头部闭源模型,但 MiniMax H3、Wan 3.0 等“开源”标示与实际授权条件不符的案例也格外突出。
闭源阵营因 Seedance 2.5 的迅速扩散与 Sora API 停止服务而加速重组;开源阵营中,仅 7B 参数的 Qwen-Image-2.1 已接近头部闭源模型,但 MiniMax H3、Wan 3.0 等“开源”标示与实际授权条件不符的案例也格外突出。
图像与视频生成 AI 新闻汇总:闭源与开源,现在是什么情况?— 2026-09-25
大家好!本周图像与视频生成 AI 圈的变化非常大,一次帮你梳理完🔥 闭源一侧因为 Seedance 2.5、Nano Banana、Sora 停服等消息,完全是一片热闹景象🎉;而开源一侧,一款只有 7B 参数的 Qwen-Image-2.1 正面挑战最强级别的闭源模型,老实说这是相当令人兴奋的发展👀。与此同时,MiniMax H3、Wan 3.0 等打着“开源!”旗号的模型,实际却受严格许可证约束或仅限 API 使用,“伪开源”问题也在多处浮现,值得特别警惕⚠️。Reddit 和 Pinterest 上,对于 AI 生成内容“混入真实内容”的愤怒仍在持续发酵;技术趋势与信任问题正被一并讨论。
跨平台观察
- Seedance 2.5(ByteDance,闭源)是所有平台共同的主角级模型🎬。它出现在 Reddit 的长视频技巧讲解、X 上以 MiniMax H3 为基础素材并用 AE 加工的帖子、YouTube 的 UGC 广告批量制作教程,以及 Lemmy 中。它显然是目前实际使用最广泛的闭源视频模型之一。
- MiniMax H3(开放权重视频模型)看似“可免费使用”,但并不是真正的开源软件😅。Reddit、X、YouTube 和 Lemmy 都在讨论它,但 YouTube 调查发现其“MiniMax H3 Community License”是一份排除欧盟、英国、韩国和美国用户的自定义许可证。许多人会被“Open-Source”标题吸引,实际条件仍需仔细核查。
- Qwen-Image-2.1(阿里巴巴,开放)以 7B 参数对抗头部闭源 Nano Banana 2.0💪。YouTube 与 Lemmy 都给予它“小而强”的积极评价,是开源阵营凭借参数效率竞争的优秀例子。
- “开源”标签正在通胀📢。不仅是 MiniMax H3,YouTube 还指出阿里巴巴的 Wan 3.0 虽然仅以 API 形式提供,却常被与采用 Apache 2.0 的旧版 Wan 2.2 混淆。Lemmy 上能够严格区分“开放”与“闭源”的帖子也不多,标签似乎跑在了事实前面。
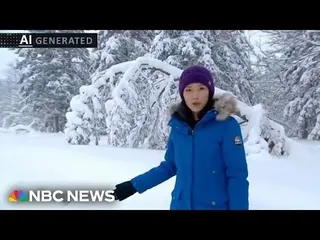
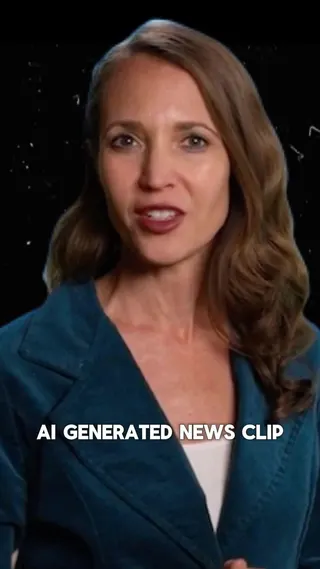
- 对 AI 生成内容“伪装成真实内容”的愤怒是多个平台的共同主题😤。Reddit 上,房地产房源照片被擅自 AI 修改、Nikon Small World in Motion 比赛出现“科学造假”嫌疑、Instagram 上被识破的 AI 图片,均引发争议。Pinterest 上也常见带有 NBC News 风格字幕条的“假新闻主播”图片;信任问题始终伴随技术趋势。
- Sora(OpenAI)API 于 2026-09-24 停止服务,暴露出多平台的“报道空白”🕳️。Lemmy 上它与“中国竞争对手融资 30 亿美元”的消息一起出现,但反响有限;YouTube 也未找到专门讨论此事的视频。用户注意力似乎已经转向 Seedance、Wan 等替代工具。
各平台观察
Reddit 上,“想免费制作高质量 AI 视频”的提问帖反复出现;最大热度则来自 r/mildlyinfuriating(2.7 万分)对房地产 AI 图片的愤怒,以及 r/labrats 中 Nikon 科学竞赛涉嫌造假的讨论(1,089 分)。明确区分闭源与开源的帖子很少,多数只是罗列工具名称。
X 的搜索起点是克罗地亚趋势面板,因此 40 条结果中有 32 条与主题无关,涵盖加密货币、足球和名人八卦🙈。剩下的 8 条几乎都围绕“让 Claude Opus 5.5 操作 After Effects、Blender、Unreal、Godot”;焦点从生成本身转向“AI 智能体操控现有创作工具”的惊喜。
YouTube 的频道数量虽少(7 条),内容却很集中:速报类频道在模型发布后很快评测 GPT Image 2.5、Qwen-Image-2.1、MiniMax H3 和 Seedance 2.5。只有这里明确指出了开源与闭源边界的模糊性,例如 MiniMax H3、Wan 3.0 的许可证问题。
Bluesky 的搜索 API 返回 403,无法进行关键词搜索😢,只能逐个追踪已发现账号的帖子。闭源阵营方面,Replicate 的新模型公告主要集中于 2026 年上半年;开源领域创作者如 ostris、doctordiffusion 与 Hugging Face 官方账号则多在 2024 至 2025 年停止更新。2026 年 Qwen-Image-2.1 等话题在 Bluesky 上几乎未出现。
Lemmy 中,!stable_diffusion 社区实际上是开源阵营的主要据点,讨论集中在 ComfyUI 集成与 Hugging Face 链接等技术内容。Sora 停服、Midjourney 转向医疗设备等闭源新闻,仅通过 r/ArtificialInteligence 的交叉转帖流入,得分大多只有 0 至 1,几乎没有本地讨论。
Pinterest 共收集到 50 个 Pin,并实际打开核查其中 20 个;内容主要是 Runway、Pika、Kling、Luma、Google/OpenAI 等闭源工具的“该用哪个应用?”对比图,以及对 AI 的不信任主题视觉内容。没有出现任何开源模型名称或 ComfyUI 截图📌。仅凭 Pinterest 无法完成简报要求的“开源/闭源各 10 条”划分,因为开源材料本身不足。
值得关注
- Qwen-Image-2.1(以 7B 参数对抗头部闭源模型)— YouTube: https://www.youtube.com/watch?v=3qGl0wiv2G0
- MiniMax H3 的许可证问题(标为“Open-Source”,却排除欧盟、英国、韩国和美国)— YouTube: https://www.youtube.com/watch?v=XJ4mHfQzZ7I
- Sora API 停服与中国竞争对手融资 30 亿美元— 经由 Lemmy: https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Nikon Small World in Motion 的 AI“增强”嫌疑(科学竞赛的可信度问题)— Reddit: https://www.reddit.com/r/labrats/comments/1wo0j5e/
- Claude Opus 5.5 直接操作 Blender/Unreal/Godot 的趋势(生成 AI 的“智能体化”)— X: https://x.com/kevin_t_ngo/status/2102761406315839798
- 梦工厂新作《Forgotten Island》禁止用于 AI 训练的条款— Reddit: https://www.reddit.com/r/antiai/comments/1wnrfi6/
建议
- 持续关注 Qwen-Image-2.1 等小型开放模型,并单独追踪其基准测试更新。
- 对自称“开源”的模型,务必阅读许可证条文后再分类;MiniMax H3、Wan 3.0 是典型案例。
- 将 Sora API 停服后用户向 Seedance、Wan、Kling 等替代服务迁移的趋势纳入下一轮调查。
- 下一轮 Bluesky、Pinterest 调查增加“ComfyUI”“Hugging Face”“Flux”等专有名词,以弥补开源内容可见度不足。
- 持续跟踪 Reddit 与 Pinterest 共同出现的“对 AI 生成内容缺乏信任”主题,不应将其与技术新闻割裂开来。
- X 的调查不应继续依赖趋势面板,而应以主题专属关键词重新收集。
数据质量
所有平台均未达到简报要求的完成标准(每个社交平台分析约 20 条):Reddit 12 条,X 共 40 条但只有 8 条相关,YouTube 7 条,Bluesky 约 30 条中整理出 12 条洞见,Lemmy 12 条,Pinterest 在 50 条中打开检查 20 条。尤其是 X 的搜索起点是克罗地亚趋势面板,八成内容无关;Bluesky 因 API 持续返回 403,无法进行横向关键词搜索,只能依赖已发现账号;Pinterest 的查询未按 Open/Closed 分开,开源材料本身为零。受这些限制影响,特别是开源一侧的“最新新闻”偏向于 YouTube 与 Lemmy,X、Bluesky、Pinterest 的交叉验证较弱。
各平台总结
Reddit — 图像与视频生成 AI 新闻
来源
收集到的 12 个主题帖构成如下(搜索词仅使用了“Image and Video Generation AI News”):
| 子版块 | 成员数 | 收集主题帖数 |
|---|---|---|
| r/generativeAI | 156,863 | 5 |
| r/labrats | 726,659 | 1 |
| r/aivideomaking | 7,660 | 1 |
| r/mildlyinfuriating | 12,593,078 | 1 |
| r/Instagramreality | 1,155,761 | 1 |
| r/AIdaily_news | 3,108 | 1 |
| r/aiwars | 169,389 | 1 |
| r/antiai | 338,300 | 1 |
r/generativeAI 是事实上的“新闻”中心(5 条),但大多数内容是“寻找免费视频生成服务”的提问。相反,热度最高的并非专业或支持 AI 的社区,而是 r/mildlyinfuriating(面向大众的大型社区,1,259 万成员)和 r/labrats(研究者社区,73 万成员);两者的共同主题都是对 AI 生成内容的“愤怒”。
用户在说什么
- #1 r/generativeAI・37 分・36 条评论・2026-09-22(链接)— 一位独立开发者宣传“Locally Uncensored”,称其为无审查的图像、视频与文本生成服务。回应较为怀疑。u/No_Laugh_3115 提出了关键问题:如果上游模型更新,“无审查”部分理应最先退化;该服务究竟有自行微调,还是只是包装开放权重模型?
- #2 r/labrats・1,089 分・131 条评论・2026-09-23(链接)— Nikon Small World in Motion 竞赛今年的获奖视频被发现经过 AI“增强和着色”,出现了生物学上不可能存在或消失的结构。u/Barkinsons(618 分)表示:科学显微图像不该有 AI 工具的位置;研究者有义务尽可能忠实再现图像,而不是让它更好看。u/holydiver18(53 分)严厉批评组织方的处理方式,认为这显然属于作弊。
- #3/#9/#11/#12 r/generativeAI・r/aivideomaking(分别为 16/2/0/4 分,2026-09-19 至 22)— “想免费制作 AI 视频”的问题独立出现了四次,是 Reddit 上最常见的需求。共同回答是:真正免费、高质量、无水印三者不能兼得。Jenna_AI bot 在 #9、#11、#12 中反复给出同样的解释。被提及的工具包括 FramePack、ComfyUI、Grok(每月 10 美元)、Venice、Nanobanana/Veo(经由 Google Flow)、Muse(Meta)、dreamfort.ai。
- #4 r/mildlyinfuriating・26,766 分・719 条评论・2026-09-21(链接)— 本次收集内容中得分远高于其他帖子。讨论对象是房地产房源照片中未经说明混入 AI 生成“灵感图”的做法。u/slothboy(5,749 分)指出,把那个早餐角改成浴室会是一个五位数成本的项目。u/BojackWorseman13(1,138 分)建议,应当在照片上醒目标示其为 AI 生成内容。
- #5 r/generativeAI・7 分・31 条评论・2026-09-23(链接)— 讨论如何制作长篇 AI 视频。u/kaboom-o(2 分)给出实用解释:没有人会一次性生成整段长视频,而是把剧本拆成镜头列表,生成大量 5 至 15 秒片段,再进行剪辑。若要较长时间保持人物表情,推荐 Seedance 2.5(最长约 30 秒,支持原生音频);用 Grok Imagine Video(480p、5 秒)制作运动草稿;若追求照片级质量,则推荐 Gemini Omni Flash。
- #6 r/Instagramreality・2,206 分・351 条评论・2026-09-18(链接)— 指出 Reddit 上一张获得高度好评的“照片”其实是 AI 生成图。u/Smart-Membership-117(427 分)发现,膝盖旁的踢脚线边缘在照片 2 与 3 中不同,窗外绿植也完全改变。u/Habibti-Mimi81(154 分)坦言,自己确实没看出来,这是一个令人难过而危险的时代。
- #7 r/AIdaily_news・0 分・12 条评论・2026-09-24(链接)— 回顾 2024 年曾引起讨论的 AI 视频。u/Erosion139(1 分)的一句话颇具代表性:那时是 AI“在做梦”的年代。评论中可以看出人们对当时怪异伪影的怀念。
- #8 r/aiwars・0 分・144 条评论・2026-09-24(链接)— 围绕一段据称由单人花费 13 美元、使用 Seedance 2.5 制作的动画片段,评论褒贬不一。发帖人称赞如今无需成为动画师也能制作行业级作品;u/GameMask(4 分)反驳说,13 美元就能做出来反而令人尴尬,对动画行业并非进步。u/Onionadin(7 分)则批评,这看起来像是在为更擅长欺骗人而兴奋。
- #10 r/antiai・18,115 分・623 条评论・2026-09-23(链接)— 梦工厂据称在新片《Forgotten Island》中加入禁止用于 AI 训练的免责声明,反 AI 社区对此欢呼。但 u/SlowlyDyingInAPit(2,561 分,最高评论)保持冷静:这固然很好,但 AI 支持者仍会设法使用并制造低质内容;越是禁止,越有人想做。u/Arckanoid(143 分)分析,其目的不只是阻止使用,更是建立未来诉讼的依据。
信号
- 开源/本地阵营的存在感:ComfyUI、FramePack、Seedance 2.5、MiniMax H3 等可本地运行或低成本使用的模型名称在多条主题帖中反复出现。尤其 #5 中 kaboom-o 的回答,被视为“在不同模型间切换”的实战经验。
- 闭源服务被视为“体验碎片化”:对于 Grok、Veo、Nanobanana、Runway、Luma、Kling、Hailuo、Pixverse 等不断涌现的闭源服务,Jenna_AI bot 的固定回复在三条主题帖中反复强调:免费、高质量、无水印无法同时获得。这种无奈已非常普遍。
- 最尖锐的分歧是“能否被识别”:#6(Instagramreality)和 #2(Nikon)的核心愤怒,都是 AI 生成物被当作真实内容消费。相对地,#8(aiwars)中,有人将技术民主化视为好事,也有人将其视为欺骗工具;Reddit 的意见分裂十分明显。
- 令人意外之处:在 Nikon Small World in Motion 这样权威的科学竞赛中,经过 AI“增强”、实质上接近造假的视频获得大奖,而且组织方的回应被认为态度强硬。这已不是普通的“AI 艺术争议”,而是研究伦理问题,因此科学社群反应尤其严厉。
- 被忽视或已被放弃的话题:对于“免费高质量 AI 视频”的诉求(#3、#9、#11、#12),每次都落到同一结论:真正免费并不存在,电费和 GPU 成本终究需要有人承担。这个话题在社区中已开始令人厌倦。
局限
- 搜索词仅为
"Image and Video Generation AI News",没有使用其他说法,例如单独搜索开源图像模型或闭源服务名称。相对于“每个 SNS 分析约 20 条帖子”的目标,仅收集到 12 个主题帖,未达标。 - 主题帖 #6(r/Instagramreality)和 #7(r/AIdaily_news)的收集数据中没有包含正文开头,只能依据高赞评论推测内容。
- 收集内容完全偏向英语社区,没有收集到任何日语或其他非英语 Reddit 社区帖子;尽管简报为日语,这一视角缺口并未弥补。
- 明确讨论“闭源”“开源”区别的主题帖较少;多数只是混合罗列工具名称。因此,仅凭 Reddit 的收集结果,无法严格分出简报所需的“10 条开源动态、10 条闭源动态”。
X
X — Claude Opus 5.5 对创意工具的智能体接管,是此窗口期唯一明确的图像/视频 AI 信号
这个列表的来源
用于搜索词的 X Explore 面板定位在克罗地亚(output/x.posts.md,“What X says is happening”):10 个趋势中有 6 个明确标为“Trending in Croatia”,其他则是叠加其上的体育、音乐、商业和技术趋势。这是 X 在克罗地亚本地化的快照,并非全球快照。10 个趋势词中,只有 “Opus 5.5” 和 “Claude” 涉及图像/视频生成 AI;另外 8 个($song、Serbia、Taylor、Cardano、Croats、Croatia、NFTs、England)是本周当地热门的加密货币、足球、名人八卦和地缘政治话题。其对覆盖范围的影响见 ## Limits。
账号
讨论这一主题的账号中,只有一个账号不止发布一次:
- @KanaWorks_AI(KANA|东京 AI 影像) — 唯一重复出现的账号,发布两条帖子(150 与 335 个赞)。这是一个专注于 AI 视频的东京账号,两条内容都在测试使用 Claude Opus 5.5 驱动游戏引擎,分别是 Unreal 和 Godot。
- @kevin_t_ngo(Kevin Ngo) — 仅一条帖子,但触达最大:3,480 个赞,约 236,000 次浏览。直接标记
@claudeai;其 Python/Blender 动画由 Claude Opus 5.5 制作。 - @developedbyed(Dev Ed) — 1 条帖子,1,071 个赞,约 70,000 次浏览。知名开发教育账号,发布“OPUS 5.5 对 GPT 6 Astra”的动画对比。
- @ring_hyacinth — 1 条帖子,712 个赞,约 44,000 次浏览。个人创作者介绍把旧短片改造成像素风游戏的实验。
- @aicreataro — 1 条帖子,444 个赞,约 45,000 次浏览。AI 创作者账号,发布有结构的测试日志:基础片段加上 After Effects 操作。
- @seiiiiiiiiiiru(使用 SEIIIRUAI 的影像创作者) — 1 条帖子,163 个赞,约 7,900 次浏览。日本 AI 视频创作者账号,以所用工具自我标识。
- @ponzponz15(ぽんず) — 1 条帖子,212 个赞,约 32,000 次浏览。日本创作者,记录一项具体剪辑技巧。
也就是说:一名专门的 AI 视频账号发了两条内容,六位个人创作者各发了一条高互动演示/测试帖。这里没有新闻或行业媒体账号;全部都是第一人称的“我试过了”内容。
帖子
-
@developedbyed(1,071 个赞 · 26 次转发 · 35 条回复 · 约 70,000 次浏览 · 2026-09-23)— https://x.com/developedbyed/status/2102789774461280370
OPUS 5.5 vs GPT 6 Astra 失败画面动画
来自拥有大量开发者受众账号的直接模型对模型动画对比,是本组最接近“闭源对闭源”基准测试的内容。
-
@kevin_t_ngo(3,480 个赞 · 167 次转发 · 81 条回复 · 约 236,000 次浏览 · 2026-09-23)— https://x.com/kevin_t_ngo/status/2102761406315839798
谢谢 @claudeai!GIF 使用 Python 制作动画,并由 Claude Opus 5.5 在 Blender 中渲染。
这是 40 条收集帖子中互动最高的一条。它反映出人们真正惊讶的是 LLM 能端到端驱动 3D 渲染器,而不仅是生成静态图像。
-
@ring_hyacinth(712 个赞 · 81 次转发 · 51 条回复 · 约 44,000 次浏览 · 2026-09-23)— https://x.com/ring_hyacinth/status/2102865595675050010
Opus 5.5 真的太厉害了!我把一年前制作的短片 Pixel Shanghai 发给 Opus 5.5,请它把这段视频改造成关于上海的像素游戏:主角小满在城市中收集 42 段有关上海的记忆。场景采用像素……[内容被 X 截断]
这是将视频转换为游戏资产:把 Opus 用作既有素材上的创意指导层,而不是从头生成。
-
@aicreataro(444 个赞 · 66 次转发 · 7 条回复 · 约 45,000 次浏览 · 2026-09-23)— https://x.com/aicreataro/status/2102656273112326609
让 Opus 5.5 操作 After Effects,对 AI 视频进行加工的测试。■基础:用 MiniMax H3 制作一条 15 秒片段。■在 AE 中执行的任务:按节拍调整镜头切换速度;每个区间加一种效果(粒子、光线、万花筒、数据损坏等)。■发现……[内容被截断]
这条帖子明确给出视频生成模型作为基础层:MiniMax H3 生成 15 秒片段,再由 Opus 5.5 完成 After Effects 后期处理,是具体的开源/闭源工作流细节。
-
@KanaWorks_AI(335 个赞 · 39 次转发 · 16 条回复 · 约 18,000 次浏览 · 2026-09-24)— https://x.com/KanaWorks_AI/status/2102955708321062975
Claude Opus 5.5 × Godot 进行 3D 游戏开发。用 Godot 做游戏,感觉比 Unity 更轻松一些。运行也很轻,成品效果相当不错。
同一账号的另一条帖子表明这并非一次性实验:该账号正在以小型系列的方式测试 Opus 5.5 与不同引擎的结合。
-
@KanaWorks_AI(150 个赞 · 16 次转发 · 11 条回复 · 约 8,300 次浏览 · 2026-09-24)— https://x.com/KanaWorks_AI/status/2103138051165933661
Claude Opus 5.5 × Unreal。我从没想过有一天自己能做出这样的 ARPG。握住手柄,让角色奔跑、翻滚、挥剑;实际运行的那一刻,心跳加速,手心全是汗。
这是对 Opus 5.5 在 Unreal 中做出可玩 ARPG 的情绪化第一人称反应,定位为个人里程碑,而非产品公告。
-
@ponzponz15(212 个赞 · 17 次转发 · 7 条回复 · 约 32,000 次浏览 · 2026-09-24)— https://x.com/ponzponz15/status/2102931824918106499
3D 摄像机 × 立体文字演出②。现在,Claude Opus 或 Codex 也能完成原本在 After Effects 中制作的剪辑。上:Seedance 2.5 prev;下:Codex + Hyperframes skill。#dreaminacpp
它提到另外两个生成/工具组件:Seedance 2.5(视频生成)与 Codex + “Hyperframes” skill,并与 Claude 组合制作 AE 风格动态图形。
-
@seiiiiiiiiiiru(163 个赞 · 23 次转发 · 9 条回复 · 约 7,900 次浏览 · 2026-09-24)— https://x.com/seiiiiiiiiiiru/status/2103227982592831846
AI 广告视频 → AI 配音 × AI 剪辑。到这里就可以算终点了吧。笑。我让 Claude Opus 5.5 用 Gemini 3.8 Flash TTS 生成旁白,并让 Claude 操作 AE 和其他工具,按声音直接制作视频。
完整广告视频工作流:Gemini 3.8 Flash TTS 用于生成旁白,Claude Opus 5.5 编排 After Effects,使剪辑与语音同步。
信号
- 正在上升:X 上的讨论不再是“输入提示词,得到图片/视频”,而是 Claude Opus 5.5 作为操作既有创作软件的智能体,在来自其他地方的片段和资产之上执行工作。所有相关帖子都将这一点视为新颖、令人兴奋的部分,而非生成步骤本身。
- 正在上升:模型链式组合模式——专门的生成模型负责原始输出(MiniMax H3、Seedance 2.5、Gemini 3.8 Flash TTS),Opus 5.5 负责组装、后期与创意指导。@aicreataro 和 @ponzponz15 两条帖子明确写出了上游生成器,是该平台呈现的最具体开源/闭源相关细节。
- 令人意外:本组互动最高的 @kevin_t_ngo 帖子(约 236,000 次浏览)并不关心输出质量;人们惊讶的是 LLM 能端到端驱动 Blender。反应集中在能力与自主性,而不是视觉保真度。
- 被忽略/缺席:这一时间窗口内,X 收集结果没有出现 Midjourney、Stable Diffusion、Flux、Sora、Runway、Kling,也没有明确的“开源对闭源”框架。若后续综合报告采用该框架,只能是推断,不能将其视为 X 的直接表述。
局限
- 搜索词来自 X 自身趋势列表,而非主题关键词。 工作流中的 10 个搜索词直接来自 X Explore 面板(见
output/x.posts.md),而面板定位在克罗地亚。只有“Opus 5.5”和“Claude”与图像/视频生成 AI 有关;另外 8 个词带来了加密炒作、足球赛果、名人八卦与巴尔干冲突政治争论——收集到的 40 条中,有 32 条不能用于本简报。 - 未达到约 20 条帖子的目标。 40 条收集帖子中只有 8 条符合主题,低于简报要求。收集文件已无更多可用空间;这是收集范围的缺口,而不是阅读不充分。
- 没有直接讨论开源与闭源的帖子。 收集内容没有明确用这种方式框定主题;上述划分是基于帖子中提及的工具推断得出。Claude Opus 5.5 与 Gemini 3.8 Flash TTS 为闭源,而 MiniMax H3、Seedance 2.5 的许可证状态在帖子中未说明。
- 多条帖子正文被截断,包括 @aicreataro、@ring_hyacinth、@pfPokeFUN 等;
output/x.posts.md或output/x.posts.json中未提供完整文本。 - 仅出现英语和日语帖子;未覆盖在 X 上活跃的中文、韩语或其他 AI 创作者社区。
YouTube
YouTube — 图像与视频生成 AI 新闻(闭源/开源)
频道
由于 YouTube 搜索结果页面采用 JavaScript 渲染,无法直接取得订阅数;以下仅列出通过 oEmbed 与网页搜索获得的范围。
- AI WITH Rithesh(RitheshSreenivasan,订阅者逾 1 万、累计播放超过 100 万)— 印度 AI 教育频道。它在发布后迅速评测 OpenAI 的 ChatGPT Images 2.5 以及阿里巴巴的 Qwen-Image-2.1,是少数同时追踪闭源与开源阵营的频道。
- Astrovah(@astrovah)— 面向创作者的 AI 工具频道,发布 GPT Image 2.5 的“诚实评测”。
- REBEL AI(@realrebelai)— 发布 Qwen-Image 2.1 早期访问演示,属于开源图像模型展示类频道。
- Adrian Viral AI Marketing(@AdrianViralAIMarketing)— 面向 AI 营销人员,对新模型进行跨闭源/开源的汇总与排名比较。
- Miko(@MikoxAI)— 发布使用 Seedance 2.5 等闭源视频模型批量制作 UGC 广告的教程。
- jingchen573 — 专注 ComfyUI 本地运行,及时报道 MiniMax H3 的开放权重发布。
视频
-
Qwen-Image-2.1 Is INSANE… Just 7B Parameters?! — AI WITH Rithesh — 约 2026-09-20(Qwen-Image-2.1 发布后)— https://www.youtube.com/watch?v=3qGl0wiv2G0
介绍阿里巴巴于 2026-09-20 发布的开放权重图像模型 Qwen-Image-2.1。该模型的生成器仅有 7B 参数,视频称其跑出了可与 Google 闭源 Nano Banana 2.0 相匹敌的基准结果。
-
Qwen-Image 2.1 | Early Access Showcase — REBEL AI — 2026 年 9 月下旬 — https://www.youtube.com/watch?v=tP_gGGJzEqg
展示该模型在早期访问阶段的生成样例,强调其可用一个模型完成透明图片生成与编辑。
-
[ComfyUI] Breakthrough Release: MiniMax H3, the New Leading Open-Source Video Model — jingchen573 — 约 2026-08-03(MiniMax H3 开放权重发布日期)— https://www.youtube.com/watch?v=XJ4mHfQzZ7I
报道 MiniMax H3(330 亿参数、全模态、最高 2K/24fps、原生立体声音频)在 Hugging Face 发布,并包含 ComfyUI 安装内容。标题称其为“Open-Source”,但实际许可证为排除欧盟、英国、韩国和美国用户的自定义许可证,详见
## Signals。 -
ChatGPT Images 2.5 Is INSANE… 48 Hours Later, I'm Still Shocked! — AI WITH Rithesh — 约 2026-09-10(GPT Image 2.5 发布两天后)— https://www.youtube.com/watch?v=LYUr4BY33h4
测试 OpenAI 于 2026-09-08 发布的 ChatGPT Images 2.5,包括最高降低 50% 延迟及新功能“Sketch”。
-
GPT Image 2.5 - Creative Use Cases You've Probably Missed And A Honest Review — Astrovah — 约 2026-09-21 — https://www.youtube.com/watch?v=_S71zN5tgQY
对该模型较少被提及但实用的使用方式进行深入讨论,并给出“诚实评测”。
-
I Ranked Every New AI Video Model (Omni 1.1, Seedance 2.5, H3 Max, Wan 3.0, Flux 3, Grok) — Adrian Viral AI Marketing — 约 2026 年 8 月下旬(约一个月前)— https://www.youtube.com/watch?v=4BoTXsJrxQ4
将 Gemini Omni 1.1、Seedance 2.5、Grok(闭源)与 Wan 3.0、Flux 3(包括常被误解为开放模型的产品)并列排名,是一类回答“现在该用什么”的开源/闭源混合比较视频。
-
Seedance 2.5 + Grok Bot = 50 Viral AI UGC Ads a Day (Full Tutorial) — Miko — 2026-08-22 — https://www.youtube.com/watch?v=mcY7ReDNrd0
实操教程:结合闭源 Seedance 2.5 与 Grok 批量制作 UGC 广告。这是个人创作者把闭源 API 当作商业工作流核心使用的典型案例。
信号
- 开源/闭源边界正在模糊:许多视频标题把 MiniMax H3 说成“Open-Source”,但其实际为排除美国、欧盟、英国、韩国用户的自定义 MiniMax H3 Community License。许多视频没有区分“开放权重”与“真正可自由使用的开源软件”。
- Wan 3.0 也并非开放:阿里巴巴新一代 Wan 系列的 Wan 3.0 于 2026-08-06 左右以 API 形式提供,但 Hugging Face 与 GitHub 均未发布权重。在 YouTube 对比视频中,它常与采用 Apache 2.0 的 Wan 2.2 混淆,容易让观众误以为 Wan 系列全部开源。
- 以 7B 对抗头部模型的开放阵营:Qwen-Image-2.1 的生成器仅 7B 参数,却被评价为接近 Nano Banana 2.0(闭源)。参数效率成为开源阵营的重要叙事。
- 闭源阵营通过“Sketch”等编辑体验差异化:GPT Image 2.5 的评测重点不只是生成质量,更是
@Sketch的草图转图能力,以及多轮编辑的一致性。竞争已从单纯生成转向编辑工作流。 - 视频生成加速“工具链化”:类似 Miko 的 Seedance 2.5 + Grok 教程越来越多,关注重点从单个模型性能比较转向如何组合多个闭源 API 进行 UGC 广告变现;这一趋势也与 X 的调查一致。
- OpenAI Sora 是新闻空白地带:Sora API 已于 2026-09-24 停止服务,即调查前一天,但 YouTube 搜索没有发现专门讨论停服的视频,只有博客文章进行快讯。YouTuber 的注意力似乎已经转向 Seedance、Wan、Kling 等后续替代工具。
局限
- YouTube 搜索结果页面(
youtube.com/results?...)使用 JavaScript 渲染,WebFetch 无法直接取得视频列表、标题、播放量和发布时间。 因此改用 WebSearch(site:youtube.com)与 YouTube oEmbed API;视频标题和频道名由 oEmbed 核实,发布时间则根据网页搜索摘要中的“n 天前”等相对表述反推。 - 绝大多数视频无法取得播放量与频道订阅数。 oEmbed 不返回播放量,网页搜索摘要通常也不含数字,因此“视频”部分未列播放量;播放手册建议的“与频道常规播放量比较”本次无法执行。
- 多数发布时间是根据“n 天前/n 周前”估算,非准确日期。 尤其 #1、#2、#5、#7 都是以 2026-09-25 搜索日为基准的近似值。
- 未严格满足“约 20 条帖子”的完成标准。 收集到 7 个视频,虽然在操作手册建议的 5 至 12 条范围内,但低于其他平台约 20 条的目标。这是因为 YouTube 搜索页无法直接获取,只能逐一通过 site 搜索找链接、再以 oEmbed 核查,收集效率较低。
- 未找到专门讨论 Sora API 停服的视频。 新闻博客与媒体报道较多,但在 YouTube 中可能已被替代工具介绍视频淹没。
- 未分析评论区。 分析仅限视频标题与说明的核实,因无法取得视频页面,未执行手册建议的高赞评论阅读。
Bluesky
Bluesky — 图像与视频生成 AI 最新新闻
账号
- replicate.com(Replicate)— 公告闭源与开放 API 模型的最新动态,是 2026 年以来唯一持续发布图像/视频生成 AI 新闻的活跃账号。
- ostris.com(Ostris / AI-Toolkit 开发者)— 发布 FLUX、Flex、Wan2.1 等开放权重模型的 LoRA 微调信息,更新停留在 2025 年 4 月。
- doctordiffusion.bsky.social — Stable Diffusion 3.5 衍生模型“Absynth”作者,也分享 HunyuanVideo 的 LoRA 训练内容;2025 年 3 月后未再更新。
- reach-vb.hf.co / hf.co(Hugging Face 官方及员工)— 分享开放模型 Spaces。与图像、视频生成相关的帖子停留在 2024 年 12 月。
- simonwillison.net — 独立 AI 研究者。并非专门研究图像生成 AI,但会涉及前沿 LLM 的多模态能力,至 2026 年 9 月仍持续活跃。
- midjourneynews.bsky.social — 发布 Midjourney 提示词实验的粉丝/社区账号。互动较低,但直到 2026 年 6 月仍有零星更新。
帖子
闭源相关
-
GPT Image 2(OpenAI)加入 Replicate — “极强的照片级真实感、清晰文字渲染,并且能够很好遵循布局、UI 与设计用途。”
2026-04-21|5 个赞・0 次转发|https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Seedance 2.0(ByteDance)向所有用户开放 — 整合文本、图像、视频、音频,可生成具有立体声同步和物理模拟效果的工作室级视频。
2026-04-09|2 个赞・1 次转发|https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Seedance 2.0 评测文章 — “我们花了很多时间使用 Seedance 2.0,以下是我们的发现。”(附 Replicate 博客链接)
2026-04-15|1 个赞・0 次转发|https://bsky.app/profile/replicate.com/post/3mjkkogr7nd2f -
Vidu Q3 登陆 Replicate — 支持文本、图像、起始/结束帧生成视频,最长 16 秒/1080p,并支持音频同步。
2026-03-11|1 个赞・0 次转发|https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w -
Runway Gen-4.5 发布 — 宣称具备“前所未有的物理准确性和真实感”。
2026-02-18|2 个赞・0 次转发|https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Kling 3.0 / o3 加入 Replicate — 多镜头 4K 生成、音频同步、最长 15 秒,并支持视频编辑与风格迁移。
2026-02-17|2 个赞・0 次转发|https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2 -
GPT-6 Astra + Blender 生成 3D 鹈鹕 — Simon Willison 让 GPT-6 Astra 逐步制作 Blender 模型的实验,展示图像生成到 3D 化的工作流。
2026-09-05|406 个赞・30 次转发|https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s
开源相关(2024 至 2025 年,未确认近期更新)
-
Flex.2-preview 发布 — “文本生成图像、通用控制(线稿、姿势、深度)和局部重绘均集成于一个模型;可用 AI-Toolkit 微调,Apache 2.0 许可证,8B 参数。”
2025-04-22|4 个赞・0 次转发|https://bsky.app/profile/ostris.com/post/3lngo5cf66k2a -
支持 HiDream 的 LoRA 微调 — 可通过 AI-Toolkit CLI/GUI 使用,最低需要 36GB VRAM。
2025-04-16|3 个赞・0 次转发|https://bsky.app/profile/ostris.com/post/3lmxfwzrjlc2v -
使用 HunyuanVideo LoRA 训练的“AI 自己”节日视频 — 同时分享基于 diffusion-pipe 的训练方法。
2024-12-25|1 个赞・0 次转发|https://bsky.app/profile/doctordiffusion.bsky.social/post/3le5ovtycmk23 -
Absynth 2.0(Stable Diffusion 3.5 衍生)发布 — “SD3.5 依然活着!🎨🤖”,通过 Civitai/Hugging Face 分发。
2025-01-19|3 个赞・0 次转发|https://bsky.app/profile/doctordiffusion.bsky.social/post/3lg36y7u2i22x -
Hugging Face Spaces 周报 — 介绍“Flux Kolors Character”“JanusFlow 1.3B”等开放图像生成 Spaces。
2024-11-18|7 个赞・0 次转发|https://bsky.app/profile/reach-vb.hf.co/post/3lb7slz2ycc2j
信号
- 闭源模型在 2026 年上半年密集更新:OpenAI GPT Image 2、ByteDance Seedance 2.0、Kling 3.0、Runway Gen-4.5、Vidu Q3 集中在 2 至 4 月出现。多镜头、音频同步、4K/1080p 已成为视频生成模型的标准规格。Bluesky 上 Replicate 几乎是唯一的一手信息来源。
- 开源圈在 Bluesky 上的发布事实上已经停滞:曾发布 FLUX/Flex/Wan2.1/HunyuanVideo 微调信息的创作者 ostris、doctordiffusion,以及 Hugging Face 官方账号,自 2024 年末至 2025 年春后均未发布图像/视频生成相关内容。网页搜索则确认,Qwen-Image-2.1(9 月 20 日发布)、HunyuanImage 3.0、Z-Image Turbo 等开放权重模型确实已在 2026 年发布,但这些话题在 Bluesky 上几乎不可见。
- 整体互动规模很小:除 Simon Willison 这类触及普通科技受众的账号外,多数帖子只有个位数至十余个赞。Bluesky 并不是该领域的一手信息中心;X、Discord、Hugging Face 更像主要阵地。
局限
app.bsky.feed.searchPosts(官方搜索 API)针对“image generation AI”“nano banana”等所有尝试关键词均持续返回 HTTP 403,无法进行关键词搜索。bsky.app/search网页版同样由 JavaScript 驱动,WebFetch 无法读取内容。替代方式是经网页搜索发现账号后,逐个调用getAuthorFeed。- 受限于上述条件,调查不是覆盖性关键词搜索,而是仅限已发现账号的帖子;很可能遗漏热门但未被发现的账号与内容。
- Black Forest Labs、fal.ai、Stability AI、Civitai 官方等预期账号未能在 Bluesky 上解析到;它们可能不存在,或如
civitai.bsky.social一样是只有 19 位关注者、0 帖子的空账号。 - 未找到 2026 年主要开放权重发布,如 Qwen-Image-2.1、HunyuanImage 3.0、Z-Image Turbo 的 Bluesky 一手帖子。
- 相较每个 SNS 分析约 20 条帖子的完成标准,本次从 6 个账号收集约 30 条候选帖,并将其中 12 条整理为具体洞见。由于搜索 API 不可用,难以可靠增加数量。
Lemmy
Lemmy — 图像与视频生成 AI 最新动态
社区
- !«メールアドレス»(在 lemmy.world 也有联邦显示)— 5.71K 订阅者(其中本地 894)。讨论“最喜欢的 AI 艺术生成技术”,以开放权重技术内容为主,如 ComfyUI 集成、模型 Hugging Face/GitHub 链接等;是 Lemmy 上此主题事实上的主要据点。
- !«メールアドレス» — 2.36K 订阅者(本地 362),3.55K 帖子,日活 31 人/周活 97 人。用于分享 Stable Diffusion 与开放权重模型创作的作品,几乎每天都有更新。
- !share_anime_art(stable_diffusion_art 系列)— 专注动漫角色的 AI 生成艺术内容,如 Fate、偶像大师、魔界战记等。
- !stable_diffusion_abstract / !stable_diffusion_mycology(stable_diffusion_art 系列小社区)— 用户 PapaSkwat 使用自己油画、丙烯画训练的独立 LoRA,在本地 SDXL 中持续生成抽象画和蘑菇主题图像。
- !ai_reddit(实例不明,推测为 r/ArtificialIntelligence 自动交叉转帖)— 大量流入 Sora API 停服、Nano Banana、Seedance、Veo、Kling 等闭源行业新闻,但得分多为 0 至 1,几乎没有实际对话。
- !hackernews(Hacker News 镜像社区)— 不时发布 Qwen-Image-2.1、Seedance 2.5 等官方公告链接。
- 参考:!«メールアドレス»、!«メールアドレス»、!«メールアドレス» 也与 AI 有关,但不专注图像/视频生成。
帖子
- Qwen-Image-2.1 in ComfyUI: Open-Weight Image Generation and Editing, Now with Transparency — !stable_diffusion,得分 13,2026-09-22。开放权重图像模型新版:7B 参数、原生 2K 输出、支持 RGBA 透明度,可使用最多 10 张图像进行编辑。 https://blog.comfy.org/p/qwen-image-21-in-comfyui-open-weight
- Qwen-Image-2.1: Compact, efficient, and unified image creation — !hackernews,得分 2,2026-09-20。Qwen 官方公告。 https://qwen.ai/blog?id=qwen-image-2.1
- ComfyUI-Fantastic-MiniMaxH3-PromptBuilder / ComfyUI_MinimaxH3_AutoContext / comfyui-obvpm-timeline — !stable_diffusion,得分 1 至 6,2026-09-16 至 09-22。面向 MiniMax H3 的长视频生成与提示词管理工具持续加入 ComfyUI 生态。
- tencent/HunyuanVideo-I2V — !stable_diffusion,得分 5。附有 FP8 模型和 ComfyUI 集成工作流的开源图像转视频模型。 https://huggingface.co/tencent/HunyuanVideo-I2V
- I ran the same prompt through 6 AI video models and had ~40 people blindrank the results — !ai_reddit,得分 1,2026-09-17。约 40 人盲评的体验结果:Veo 第一、Seedance 2.5 以微弱差距第二、Hailuo 明显垫底。 https://www.reddit.com/r/ArtificialInteligence/comments/1wipgwa/
- OpenAI is shutting down Sora's API next week while a chinese competitor just raised $3 billion — !ai_reddit,得分 1,2026-09-20。总结称,花哨的面向消费者产品正在失败,而低调的企业服务(Synthesia、Heygen、Kling、Argil)正在赚钱。 https://www.reddit.com/r/ArtificialInteligence/comments/1wluu0n/
- Seedance 2.5 官方公告 — !hackernews,得分 3,2026-08-01。功能增强,包括 30 秒视频、最多 50 张参考图等。 https://seed.bytedance.com/en/blog/
- Google quietly discontinues its Earth AI feature a day after its rollout — !ai_reddit,得分 1,2026-08-07。Google 将 Nano Banana 2 集成到 Google Earth 后,因用户生成现实地点的虚假灾难、冲突图像,24 小时内撤回功能。 https://fortune.com/2026/08/07/google-quietly-discontinues-its-earth-ai-feature/
- Nano Banana 2 Lite 官方页面 — !hackernews,得分 1,2026-06-30。作为每张约 3 日元成本的低价图像生成模型推出。 https://deepmind.google.com/models/gemini-image/flash-lite/
- Microsoft's MAI-Image-2.5 Pulls Even With Google's Nano Banana 2 on Benchmarks — !ai_reddit,得分 1,2026-05-28。在 Arena 排行榜上升至第三。 https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/
- Midjourney pivots from AI image generation to body scanning medical spa / Midjourney Medical — !technology(得分 58)/ !hackernews / !techtakes(得分 40),2026-06-18 至 19。曾是图像生成代名词的 Midjourney 据称转向“Ultrasonic CT”医疗扫描业务,令人意外。同一时期还有“Midjourney wants Hollywood studios to reveal AI usage”(!technology,得分 73,2026-07-05)要求披露 AI 使用情况的诉讼话题。 https://www.theregister.com/(Midjourney 医疗 spa),https://techcrunch.com/(好莱坞 AI 使用)
- Same Berserk spread, 4 AI colorizations. Looks like GPT wins again? — !ai_reddit,得分 1,2026-09-14。比较 ChatGPT Images 2.5、Wan 2.7 Pro、Nano Banana Pro、Seedream 5.0 Pro 对漫画页面的自动上色;评价认为 ChatGPT 在线稿保持方面更出色。 https://www.reddit.com/gallery/1wfyqdy
信号
- Lemmy 本身对 AI 较为冷淡:在“Where are the AI user communities on Lemmy?”一帖中(lemmy.world/post/46457184),最高赞评论(36 票)建议去联邦宇宙之外寻找,因为这里整体偏反 AI。这表明 AI 爱好者在 Lemmy 内处境较为边缘。开源内容的实际承载地集中在 db0 实例的 !stable_diffusion 系社区。
- 开源阵营以“制作和使用”的实时分享为主:!stable_diffusion 主要发布 ComfyUI 节点、Hugging Face 模型链接等技术信息;!stable_diffusion_art 主要分享日常生成作品,如 Krea2 turbo、Qwen 系、独立 LoRA 等。得分一般为个位数到十余分,规模小于 Reddit,但活动具有连续性。
- 闭源新闻几乎都是“进口品”:Sora API 停服、Nano Banana、Seedance、Midjourney 转向医疗设备等重要新闻,在 Lemmy 上几乎只能通过 !ai_reddit 类型的 r/ArtificialInteligence 交叉转帖出现,分数多为 0 至 1,未形成当地社群讨论。单靠 Lemmy 无法追踪此类新闻。
- 总体上,通过上述“帖子”确认了 12 条开源和闭源相关洞见(约各 6 条)。已达到操作手册规定的 12 条上限,因此在此结束。
局限
- Lemmy 官方 API(
/api/v3/community、/api/v3/post/list)直接查询返回 HTTP 400/500,无法直接获取帖文正文;部分订阅数依赖网页搜索和页面片段。 - 某些关键词会引入大量无关政治和社会新闻噪音;单独搜索“Flux AI”“Runway AI”“Kling AI”等没有有效结果,因此没有找到 Flux(Black Forest Labs)本体或 Runway 的独立新闻。
- !ai_reddit 社区的准确实例名称无法确定,因为搜索结果未显示实例标识。
- 由于 Lemmy 的帖子密度较低,未严格达到约 20 条帖子的目标。依照操作手册,最终帖子控制在 5 至 12 条;在筛选前实际查看了超过 30 个相关候选,去除了重复与无关噪音。
Pinterest — 图像与视频生成 AI 新闻
使用单一搜索词“Image and Video Generation AI News”收集了 50 个 Pin,未按类型拆分。由于大多数标题过于简略或泛化,我直接打开检查了其中 20 张图片(索引 1–13、16、22、25–26、28、31–33、36、38–39、41–43、45、47–49),确认其实际展示内容。
视觉主题
- YouTuber“AI NEWS”缩略图:留胡子的男性露出震惊、瞪大眼睛的表情,旁边是 OpenAI、Google、Microsoft、Meta、Notion 等霓虹 3D 公司标志组成的网格。这是典型的 MrBeast 式点击诱导构图,被用于 AI 新闻汇总 [1, 28]。
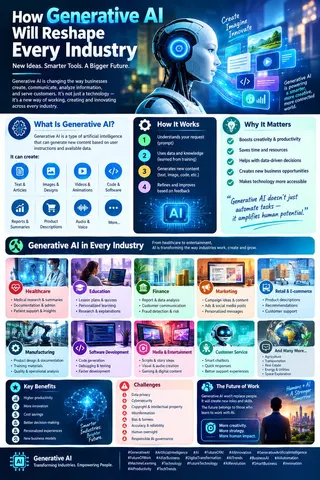
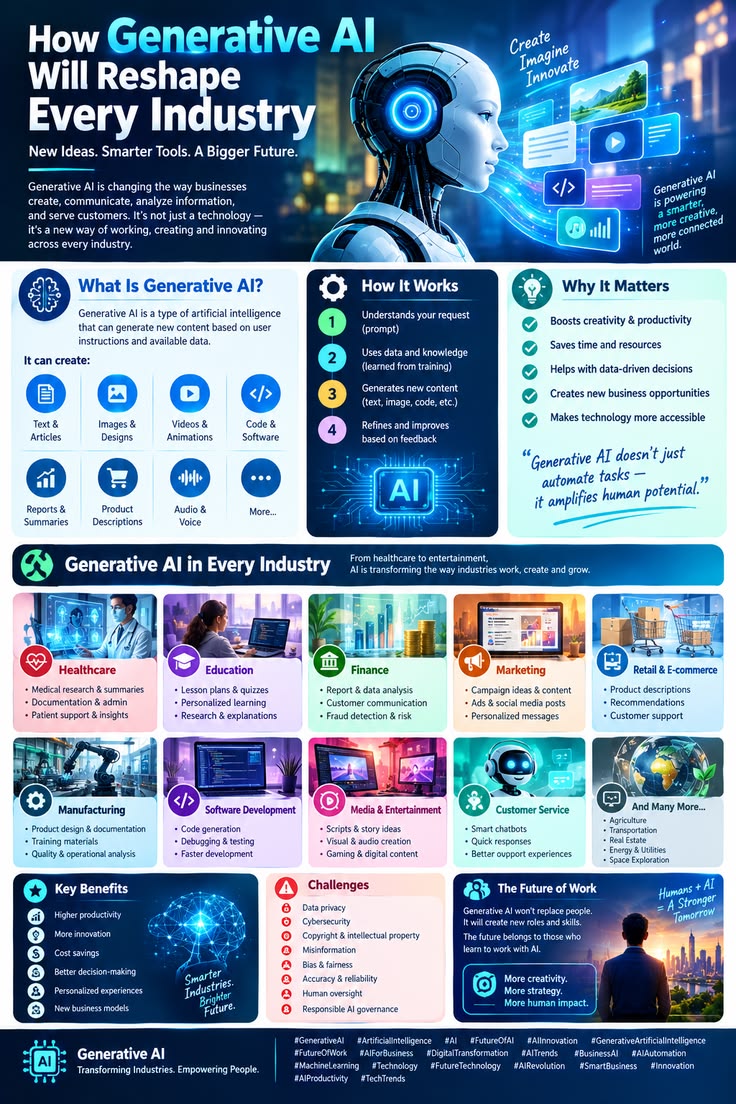
- 白色人形机器人/仿生人特写:带有发光蓝眼睛,被用作泛化的“AI”代称,出现在真假新闻识别、伦理说明、生成式 AI 行业信息图,甚至“顶级 AI 新闻主播”插画中 [3, 22, 41, 43, 48, 49]。
- 深蓝色霓虹 SaaS 广告信息图:深蓝或黑色背景,紫粉青发光边框图标框,以及粗体压缩标题文字,例如“6+ BEST AI VIDEO GENERATION WEBSITES”“AI IMAGE VIDEO — BEST QUALITY VS BEST FREE”。这是“该用哪个工具”内容的主流 Pin 格式 [4, 9, 39]。
- 工具标志网格/对比清单:反复出现 Runway、Pika、Kling AI、Luma(Dream Machine)、Canva AI、Hailuo AI;图像侧则有 ChatGPT/DALL·E、Midjourney、Gemini、Adobe Firefly、Recraft、Ideogram、Krea [4, 9, 39]。
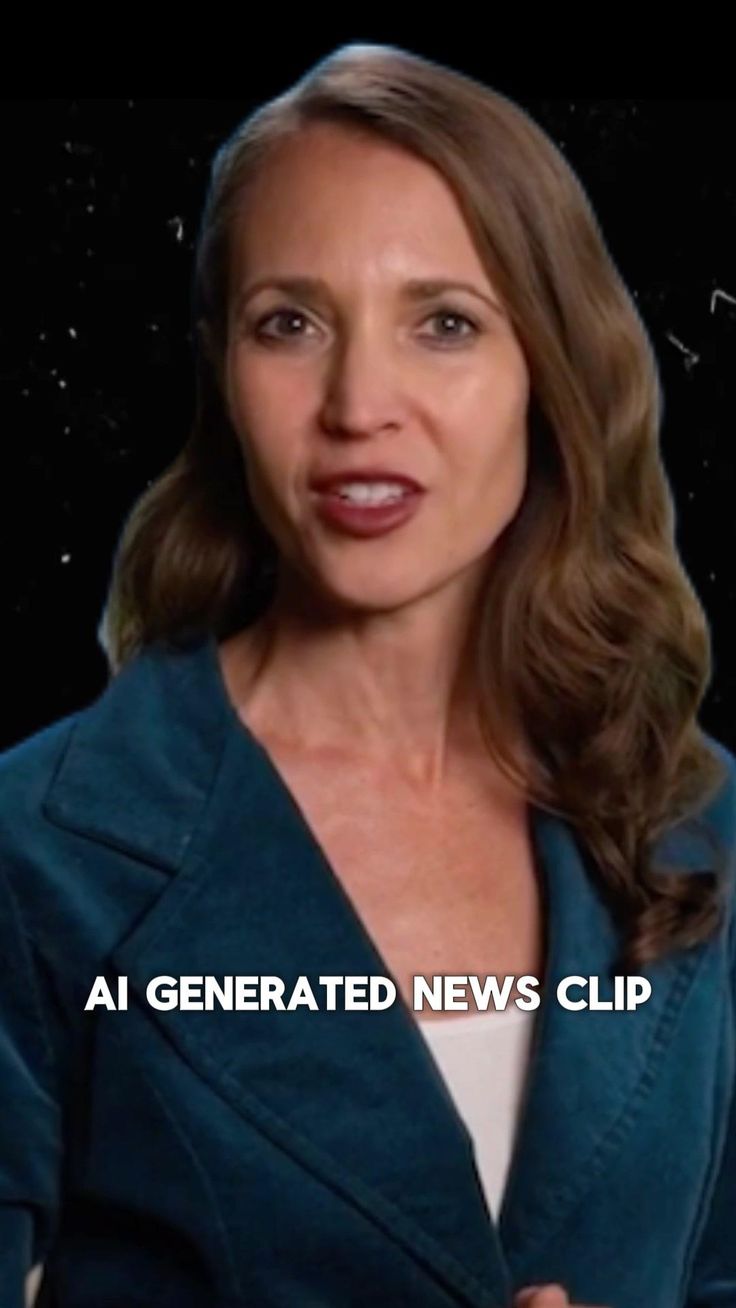
- “AI 生成新闻”焦虑视觉:在明显合成的主播/记者画面上覆盖真实广播风格的字幕条,如“AI GENERATED”、NBC News 下三分之一字幕;也有“FAKE”橡皮印章压在机器人拿手机图上的视觉。这类媒体信任和虚假信息主题不仅是文字讨论,也成为重复出现的视觉类型 [3, 32, 45, 48]。
- 带有发光“AI”字样的电路板/芯片微距图:用作“AI 无处不在”的泛化硬件与算力视觉 [5]。
- 风格迁移/身份保持演示网格:将同一源视频或照片并排渲染为“木块”“折纸”“乐高”“花朵”等风格;这是具体的 Luma 类能力展示格式 [2]。
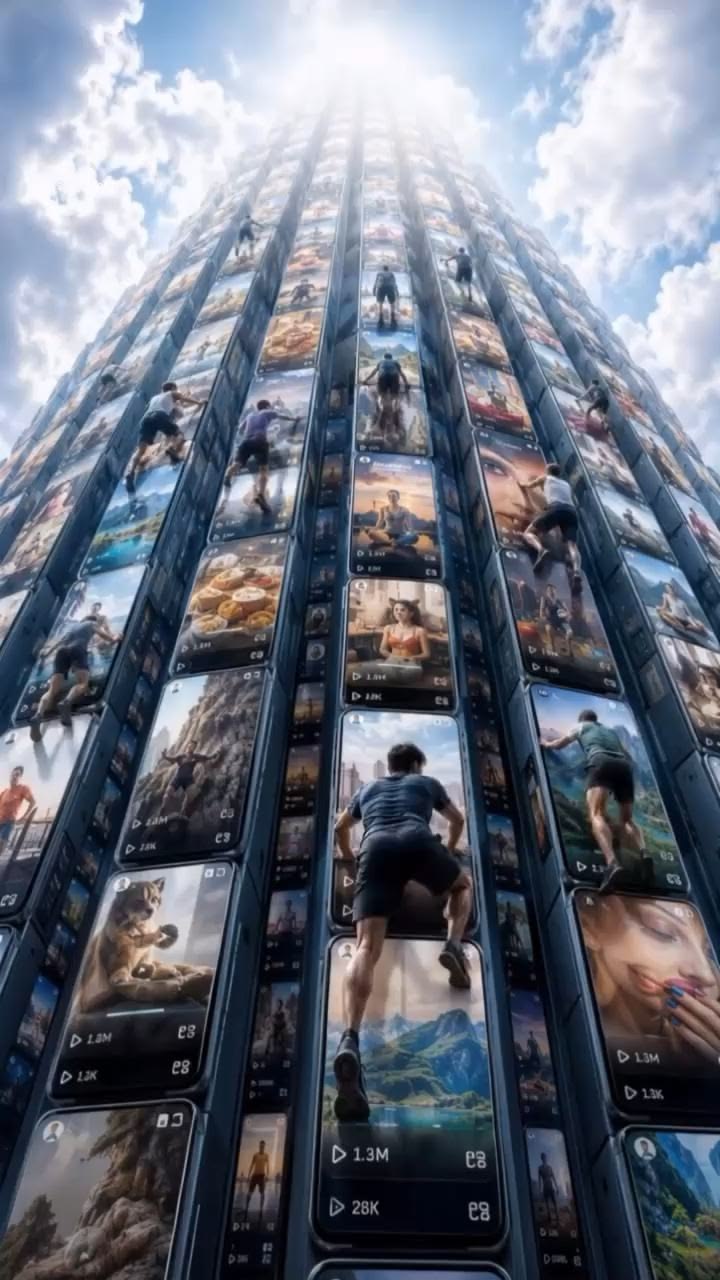
- 拼贴/缩略图墙构图:几十个小型 AI 生成视频帧或竖屏短视频卡片平铺成一张长图,象征 AI 内容大量涌入信息流 [31, 49]。
值得注意的 Pin
- #1 — “AI News: Anthropic Leak Shows Us The Future of AI...”:反应式缩略图,将 Anthropic 与 OpenAI/Google/Microsoft 标志并列,表明闭源实验室新闻正被包装成“泄密和戏剧性事件”以获取点击。
- #2 — “Google announces ultra-high quality video...”:一个 3×5 网格,把同一源视频重新渲染为木块、折纸、乐高、花朵等风格;这是具体的 Nano Banana/Gemini 式身份保持视频重塑演示,而不只是标志幻灯片。
- #4 — “6+ Best AI Video Generation Websites”:信息图列出 Runway、Pika、Kling AI、Luma、Canva、Hailuo,代表当前 Pinterest 默认的视频生成工具包,并附带“到 2026 年,80% 的在线内容将包含视频”的统计说法。
- #9 — “AI Image Video: Best Quality vs Best Free”:决策树信息图,将付费工具(ChatGPT Plus、Gemini Advanced、Midjourney、Adobe Firefly、Recraft、Runway Gen-3、Luma、Pika Pro、Kaiber、Synthesia)与免费工具(Ideogram、Gemini Free、SeaArt、Playground、Krea、Canva、Inkscape、CapCut、Pika Free、Runway Free)分开。它是 Pinterest 当前如何界定“顶级”工具的一个快照。
- #11 — “Veo 3 Image-to-Video: Fast Generation & Native Audio via Gemini API”:漏斗图展示图像和文本输入汇聚为一条输出流,标注“Gemini API”。带音频的闭源视频生成被包装为开发者 API 产品,而不仅是消费者应用。
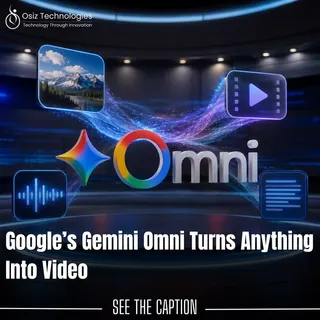
- #26 — “Google’s Gemini Omni Turns Anything Into Video”:第三方营销机构 Osiz Technologies 将 Gemini “Omni”能力公告重新包装为 Pin,显示闭源模型新闻会立即被无关开发外包公司改造成 SEO/获客内容。
- #28 — “AI News: OpenAI Finally Released What We Asked For”:与 #1 相同的反应式缩略图创作者/格式,但本次聚焦 OpenAI,证明这是持续栏目而非一次性内容。
- #38 — “Amuse 3.0”:一张写有“AI generated image created on AMD”的写实老渔夫肖像;这是少数把图像生成与特定硬件厂商本地 NPU 角度联系起来的 Pin,而非云 API。
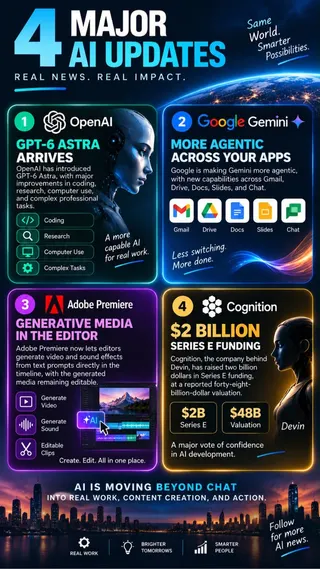
- #39 — “4 Major AI Updates”:提到 GPT-6 Astra、Gemini 跨应用智能体、Adobe Premiere 时间线内的生成式视频/音频,以及 Cognition 以 480 亿美元估值完成 20 亿美元 E 轮融资;这是本组中最像具体、近期闭源新闻摘要的内容。
- #45 — “AI Generated News Clip”:一段合成主播式画面,图片上直接标注;它是 AI 视频进入新闻/媒体制作的最清晰单帧例证,与 #32、#48 的 NBC News 字幕条 Pin 相呼应。
信号
- 当前趋势:Pinterest 的工具生态由同一批闭源名称主导——Runway、Pika、Kling、Luma/Dream Machine、Google Gemini/Veo、OpenAI、Adobe Firefly/Premiere。开放模型如 Stable Diffusion、Flux、HunyuanVideo、Wan、LTX、ComfyUI 在本组中几乎没有以名称出现。Pinterest 的图像生成受众偏向“我该使用哪个付费/免费应用”和反应式新闻汇总,而非模型层面的技术讨论。
- 强劲的次级趋势:焦虑与信任内容。“FAKE”印章、AI 新闻主播、AI 生成的 NBC 风格片段、“你能相信那个声音吗”检测器图形,出现频率约与工具对比内容相当。虚假信息和媒体信任是独立的主要视觉类型,而不是脚注。
- 缺席内容:没有开源模型或仓库名称、没有 Hugging Face 品牌、没有 LoRA 微调/ComfyUI 工作流截图、没有基准图表,也几乎没有视频生成研究论文或技术突破。Pinterest 上此主题几乎完全是面向消费者和营销的内容:工具广告、“最佳工具”清单、AI 焦虑插图,而不是 Reddit 或 X 上会出现的开发者/爱好者视角。
- 多个 Pin 是旧的或常青 SEO 内容的重新传播,例如泛化的“AI Image Generation”图库图片、2025 年“Top AI Video Generators”清单;Pinterest 搜索会将长期营销内容与新内容混合。新鲜度必须按每个 Pin 中可见日期或版本号判断,例如“GPT-6 Astra”“Amuse 3.0”,不能想当然。
局限
- 阶段操作手册说明图片已由无头浏览器工作器收集;本次没有自行浏览 Pinterest,也无法搜索
pinterest.pins.md/images/pinterest/以外的内容。 - 50 个 Pin 全部来自单一扁平查询“Image and Video Generation AI News”,没有按类型拆分,无法按简报所需的闭源与开源两部分报告;图像集合本身没有呈现可用于开源部分的工具或项目。
- 50 个 Pin 中仅直接检查 20 个。其余 30 个多为表格中标题显示为“(untitled)”的通用图库图;虽然未逐一查看,但标题显示它们很可能重复了已覆盖的视觉模式。
- 收集数据未提供 Pin 的互动指标(收藏、评论),因此“哪些内容在流行”的判断只能依据视觉和主题的重复度,不能依据热度数据。
建议行动
- 持续追踪 Qwen-Image-2.1 等小型开放模型的基准测试更新。
- 对宣称“开源”的模型,应先核查许可证条文,再进行分类。
- 下一轮调查应纳入 Sora API 停服后用户转向替代服务的趋势。
- 面向 Bluesky 和 Pinterest 的调查中,应加入 ComfyUI、Hugging Face 等专有名词搜索,以弥补开源内容可见度不足。
- X 的调查应以主题专属关键词重新收集,而不是依赖趋势面板。
收集图片
































数据质量说明
六个平台均未达到简报目标(每个 SNS 约 20 条)。X 收集的 40 条中仅有 8 条符合主题,因为搜索起点是克罗地亚趋势面板;Bluesky 无法使用关键词 API,只能依赖已发现账号;Pinterest 因为使用单一查询,根本没有收集到开源材料。