我用一张 RTX 4090 从零训练了 GPT-2:一天超越原版,还让它学会了聊天
我尝试只用家里的一张 RTX 4090,从零开始训练 GPT-2(124M)。从数据准备、预训练,到让它能聊天的指令微调(SFT),全都在自己的 PC 上完成。
先说结论:
- 预训练约 21 小时完成。 在常识推理测试 HellaSwag 上取得 30.5%,超过了原版 GPT-2 124M 的 29.4%
- SFT 不到 2 小时。 开始训练后仅 5 分钟就开始给出像对话一样的回答
- 不过内容仍然充满幻觉。它会若无其事地说“巴黎人口有 24 亿”“12+7=30”之类的话
看着 GPT-2 一点点变聪明的过程很有意思,所以把整个过程记录下来。
环境
- GPU:RTX 4090(24GB)
- CPU:i7-13700K / 内存 64GB
- OS:Windows 11(未使用 WSL,直接在 Windows 上运行)
- PyTorch 2.11 nightly(CUDA 12.8)+ triton-windows
代码采用 Karpathy 的 nanoGPT/build-nanogpt 的方式。我让 Claude Code“在这台 PC 的 GPU 上做一个一天内能完成的 GPT-2”,从架构建议、脚本编写到训练监控,都和它一起完成。
数据准备:10B token 在 12 分钟内就绪
训练数据使用 FineWeb-Edu(面向教育的高质量英文网页文本)的 10B token 版本。parquet 文件约 27GB。
一开始直接用 Hugging Face 下载,速度只有 1.7MB/s,算下来全部下载完要 4 小时以上。装上 hf_transfer 后速度达到 60~70MB/s,2GB 的文件 30 秒就能下载完。瓶颈随即转移到了分词环节,最终下载和分词合计约 12 分钟就全部准备好了。
顺带一提,最开始我把更改缓存保存位置的 HF_HOME 写在了 huggingface_hub 的 import 之后,导致设置没有生效,文件被下载到了另一个盘。这个环境变量会在 import 时读取,所以要在 import 之前设置。这是个不太起眼的坑。
训练设置
| 项目 | 内容 |
|---|---|
| 模型 | GPT-2 small(12 层、768 维,1.24 亿参数) |
| 1 步 | 约 52 万 token(16×1024,进行 32 次梯度累积) |
| 步数 | 16,000(约 8.4B token) |
| 速度 | 约 12 万 token/秒 |
| 显存 | 约 12GB |
经常会听说 Windows 下 torch.compile 跑不起来,所以要用 WSL;但在装有 triton-windows 的环境里,它可以直接运行。
如果用完全部 10B token,训练时间会超过 24 小时,所以为了控制在一天内,缩减到了 8.4B token。
还有一个小技巧:我把词表大小从 50257 向上取整为 50304(128 的倍数)。这是 Karpathy 很有名的技巧,能提升 GPU 矩阵计算速度;而它后来也以意想不到的方式帮上了聊天微调的忙。
事故:训练在 2.5 小时后停止了
查看中间进度时,发现训练已经停了。原因是 HellaSwag 的评估数据。nanoGPT 系代码会从 GitHub 的 rowanz/hellaswag 获取数据,但那里变成了 “451 Unavailable For Legal Reasons”(因法律原因无法访问)。评估触发 404 错误,训练也随之中断。
我改为从 Hugging Face 上的 Rowan/hellaswag(内容相同,共 10,042 道题)读取,并从每 500 步保存一次的检查点继续训练。同时用 try/except 包住评估逻辑,避免评估失败时中断训练。
长时间训练时,不能让评估、日志这类“本体之外”的故障把训练弄停。 这一点很重要。
结果:超过了原版 GPT-2
验证数据的 loss 如下。第一个小时快速下降,之后缓慢下降。
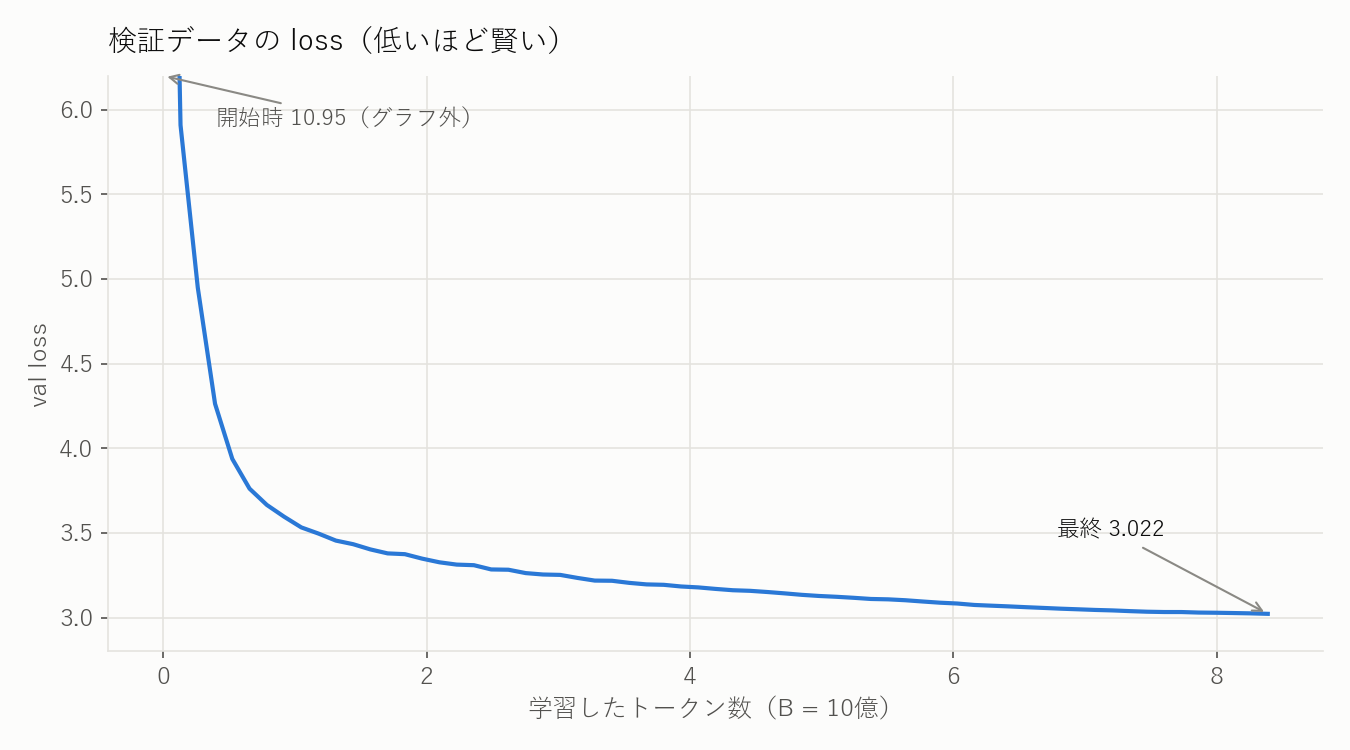
初始 loss 为 10.95,和 ln(50304)≒10.83 几乎一致。也就是说,它一开始相当于在 5 万个词中完全随机猜选。
HellaSwag 的正确率如下。
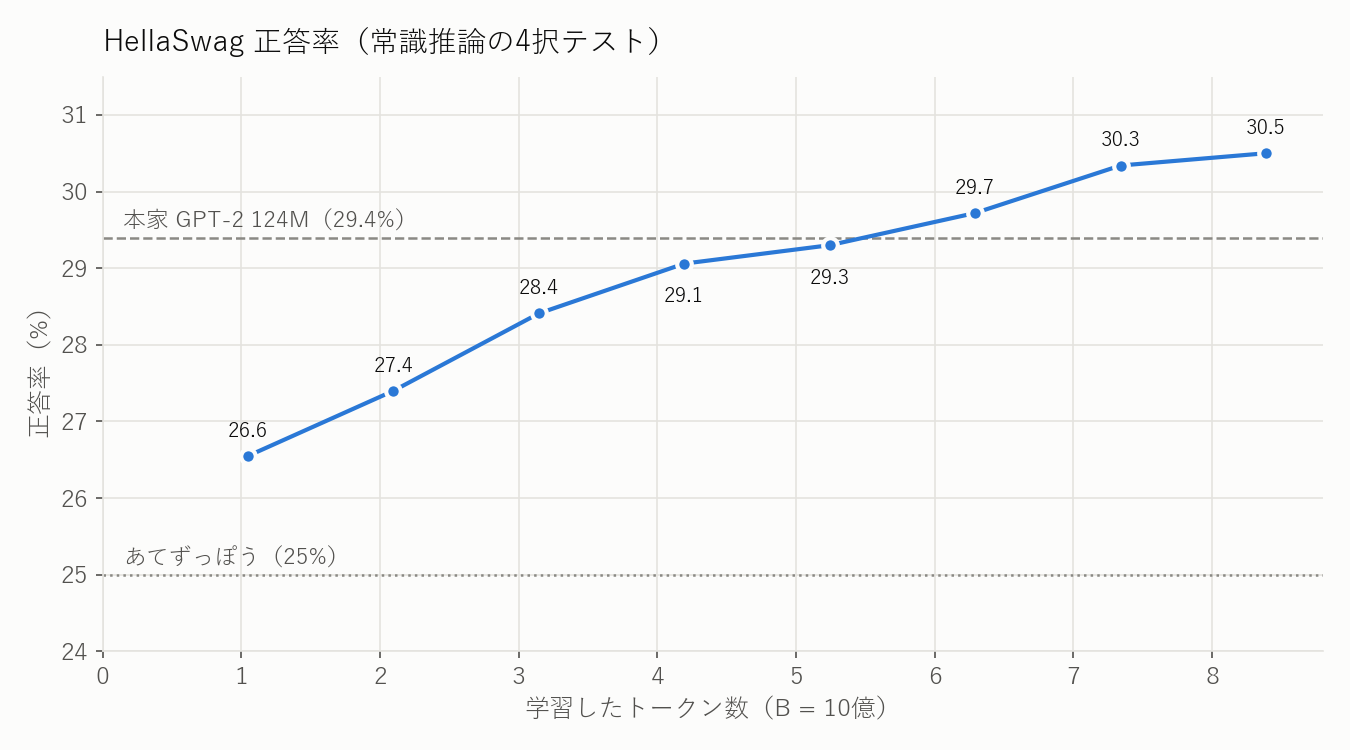
在约 6.3B token(step 12,000)时超过了原版 GPT-2 124M 的 29.4%,最终达到 30.5%。原版 GPT-2 使用 WebText 训练;这次使用了 FineWeb-Edu,我认为教育类高质量数据起到了作用。
一点点变聪明的过程
训练期间,我每小时都用相同的提示词生成文本并记录下来。这是最有意思的部分。
训练前(随机状态)
Hello, I'm a language model,CHR 351ointment Education rodents Effectiveantically emulatorprot grievance...
词语只是完全随机地排列在一起。
37 分钟后(0.26B token)
The capital of France is a capital trade market ... is often referred to as the capital city of Scotland
已经有了句子的样子。它知道这是“首都的话题”,却把法国首都说成了苏格兰首都。
约 2 小时后(0.79B token)
Photosynthesis is the process by which oxygen gas is converted into ammonia by removing the nitrogen hydroxylates (NTP).
语法已经相当自然了。与此同时,它开始堆砌术语,说出看似可信的谎言。很像幻觉的雏形。
约 2.1B token
The capital of France is Paris, and the country is also France. France makes approximately 50% of the world's steel production.
终于会说 Paris 了!……但紧接着又补了一句“法国生产了全球约 50% 的钢铁”这种虚假统计。
向完成的基础模型提问
我用 Question: ... Answer: 的格式问了它 10 个问题。
- What is the capital of France? → 罗列 (a)~(i) 的选项,开始编题集
- Who was Albert Einstein? → “1918 年 11 月 16 日出生于密苏里州圣路易斯。父亲是矿工,自己是学校教师。”虽然全是假的,但已经能写出传记体
- What is 12 plus 7? → “12 plus 7 is an arithmetic expression.” 不做计算,反而开始解释定义
它掌握了一些知识,但不知道“回答问题”这种行为方式。基础模型本质上只是“续写文本”的机器,所以这也理所当然。
用 SFT 让它学会聊天
接下来,我进行了让它像 ChatGPT 一样回答问题的指令微调(SFT)。
- 数据:Hugging Face 的
smol-smoltalk(约 46 万段对话、2.7 亿 token) - 聊天格式:新增
<|user|>、<|assistant|>、<|end|>等分隔标记。这里复用了刚才把词表扩展到 50304 时留下的空闲编号。无需改变模型结构就能添加特殊 token,因此这个为提速而做的小技巧在这里派上了用场 - 只训练回答部分:问题文本只作为输入阅读,真正让它模仿的是助手的回答,以及最后的
<|end|> - 2 个 epoch,约 1 小时 50 分钟
关键在于连 <|end|> 都一起训练。这样模型就会学会说完后自己停下。ChatGPT 等模型也是类似机制:一旦生成结束标记,就停止生成。
短短 5 分钟就有了对话感
在开始 SFT 前(step 0),模型会被陌生的分隔标记弄糊涂,陷入“jakjakjakjak…”的无限循环。但仅仅 500 步(约 5 分钟)后,它就已经像在对话了。
The capital of France, Paris, is a city known for its numerous landmarks, including the Eiffel Tower, Louvre Museum, and Notre-Dame Cathedral.
而且它真的会说完就停。学会说话方式只是一瞬间的事。
不过知识还是老样子。中途的模型会说“巴黎是世界最大的城市,人口约 24 亿”之类的话。
对比 SFT 前后
我用同样的问题比较了 SFT 前(基础模型)和之后的结果。
| 问题 | SFT 前 | SFT 后 |
|---|---|---|
| What is the capital of France? | 开始罗列选项 (a)~(i) | “The capital of France, Paris, is a city located in the northern part of the country, along the Seine River.” |
| Who are you? | “I am the person who has the gift for all that I do.” | “I'm a language learning AI assistant with over 10 years of experience”(明明是 AI,却有 10 年经验) |
| Translate "Good morning" into French. | 开始说与问题无关的话 | “Bonjour!”(正确。但之后不断重复“Good morning (modifier)”) |
| What is 12 plus 7? | “是 arithmetic expression” | “12 + 7 = 21”→“12 + 7 = 30”→“35 + 7 = 34”,以看似合理的步骤不断算错 |
| Who was Albert Einstein? | 父亲是矿工的学校教师 | “prominent physicist”这个大方向是对的。但“1905 年 2 月 24 日出生于维也纳”是假的 |
语气和形式完全像助手,内容却有很多谎言。 算术更是彻底崩坏。
实际聊聊看
我写了能在终端对话的 chat.py,然后和它聊了聊。
You: What is the capital of Japan? Answer in one sentence.
AI: The capital of Japan is Tokyo, a city known for its historical landmarks and cultural significance.
它能够遵从“用一句话回答”的指令。 这是基础模型做不到的事。
另一段对话中,问完首都后我接着问人口。
You: What is the population there?
AI: In Japan, the population is estimated to be around 50,000 people. ... the northern part of the country, where about 1.5 billion people live...
它理解了前文中“there=日本”。但刚说完人口 5 万人,又说北部住着 15 亿人,已经完全混乱了。
我用日语问“日本の首都は?”,它这样回答:
AI: I'm ready to help you with your writing. Please go ahead and provide the text...
因为它只学了英文数据,日语在它看来似乎成了一段希望获得修改的神秘文本。
最后,我让它“写一首关于 GPU 的俳句”,结果它写成了一首不断重复“I see the world, the thoughts, the emotions”的诗。俳句呢?
实践后明白的事
- 一张 4090、一天时间,就能做出超过原版 GPT-2 的模型。 GPU 功耗约 430W,仅 GPU 电费粗略估计约 300 日元
- 说话方式能瞬间学会,知识则由预训练决定。 SFT 在 5 分钟内就学会了对话格式,但事实准确性几乎没有改变
- 124M 的模型语法几乎完美,内容却充满谎言。 可以非常直观地感受到:流畅和正确是两回事
- 长时间训练会在基础设施环节出问题。 这次中断的原因不是模型,而是评估数据的存放位置失效了
亲手从零开始做一遍,能切身体会到:像 ChatGPT 这样的 AI,本质上是先让“预测文本后续”的机器学会“对话礼仪”。下一步,我也想试着做一个更接近实用的模型。