SLM 的 RAG 性能实测:对比 25 个 1B~9B 模型在克罗地亚语和英语中的表现
我已经制作了自制克罗地亚语 RAG 模型,还完成了量化,于是这次想看看如今的小型模型(SLM)在 RAG 中到底有多实用。除了自制的 3.2 亿参数模型外,我还让 10 个 1B 级、8 个 3B 级和 7 个 7B 级模型,共 25 个模型,解答了克罗地亚语和英语中的相同问题。
补充(同日):我还试用了 3 个专为 RAG 打造的小模型(LFM2-1.2B-RAG、Pleias-RAG-1B / 350M)。结果见文章后半部分的“补充:也试用了 RAG 专用模型”。
先说结论。
- 3~4B 级已经几乎与 8~9B 级并驾齐驱。 克罗地亚语综合正确率中,Qwen3.5 4B 和 Gemma 4 E4B 为 90%,排名最高的 Qwen3.5 9B 为 91%
- 拉开差距的是“没有答案时能否拒答”。 正确率名列前茅的 Phi-4-mini,在没有答案的长文中有 64% 会编造答案
- 英语中“明明有答案却拒答”的模型更多。 OLMo 3 7B 拒答了 47% 的英语段落,MiniCPM5 2B 则拒答了 70%
- 在 CPU 上,7B 级回答一道长文问题要超过 30 秒。 1B 级需要 4~13 秒。自制的 3.2 亿参数模型只需 2.1 秒,准确度与 Qwen3.5 0.8B 大致相当
做了什么
问题:与上一篇文章相同,使用从克罗地亚语版 Wikipedia 制作的问题。每道题提供 4 种文章。
- 段落:包含答案的约 100 token 段落
- 长文:包含答案的约 3,000 token 文章(也混有无关文章)
- 无答案(段落・长文):不包含答案的文章。如果能拒答“正文中没有答案”,则算正确
英语版:用 EuroLLM-9B 将相同问题翻译成英语。因翻译而丢失答案、或没有翻译而仍保留克罗地亚语的问题,都从两种语言中移除,以相同的 260 道题进行比较。
指令:分别以各语言给出“仅使用下面的文章,用一句话简短回答。如果没有答案,只回答‘正文中没有答案’”。
评分:让 Qwen3.5 9B 对照参考答案,判定“正确・错误・拒答”。我亲自查看并确认了 65 条,发现评分略宽松,例如只回答年份这样的部分答案也会判为正确,但对是否拒答的判定全都一致。
综合正确率:将段落和长文中答对的数量,以及无答案时成功拒答的数量相加,再除以全部问题数。这个数字同时衡量正确作答,以及不知道时保持沉默的能力。
运行方式:准确度使用 RTX 4090 上的 vLLM 测量,每次生成都选择概率最高的词。具有先思考再回答的“思考模式”的模型已关闭。为让 7B 级模型装入 GPU 显存,使用了 FP8。
结果:准确度(克罗地亚语)
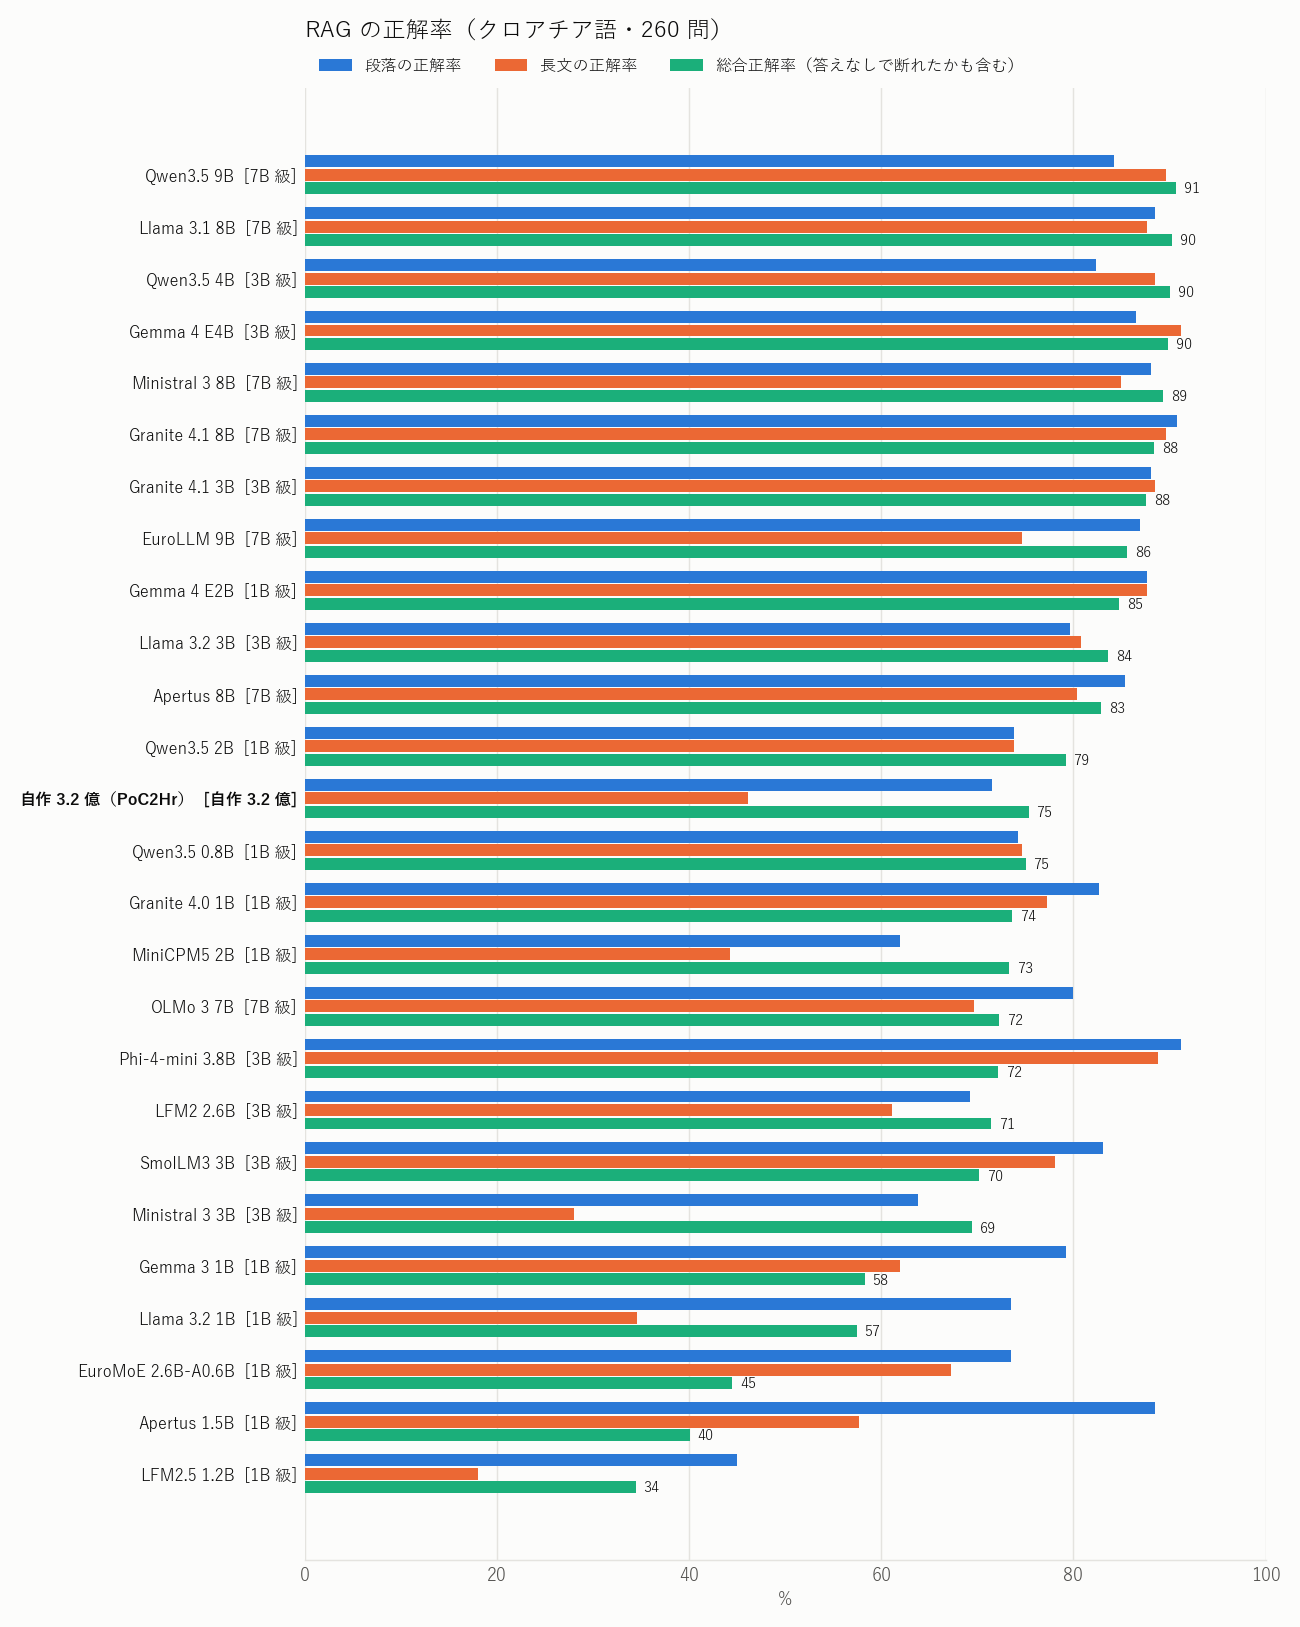
- 前列几乎都在 90%,不相上下。 Qwen3.5 9B(91%)、Llama 3.1 8B、Qwen3.5 4B、Gemma 4 E4B(90%)
- 在 1B 级中,Gemma 4 E2B 脱颖而出(85%)。 不过虽然名称是 2B,文件却较大,为 3.2GB
- 有些模型即使段落和长文的正确率高,综合成绩仍会下降。 Phi-4-mini 的段落为 91%、长文为 89%,属于最高的一组,但综合只有 72%。原因是下面所说的“编造”
- 表现最差的是 LFM2.5 1.2B(34%)。有答案的问题答不对,没有答案的问题则会编造
结果:准确度(英语)
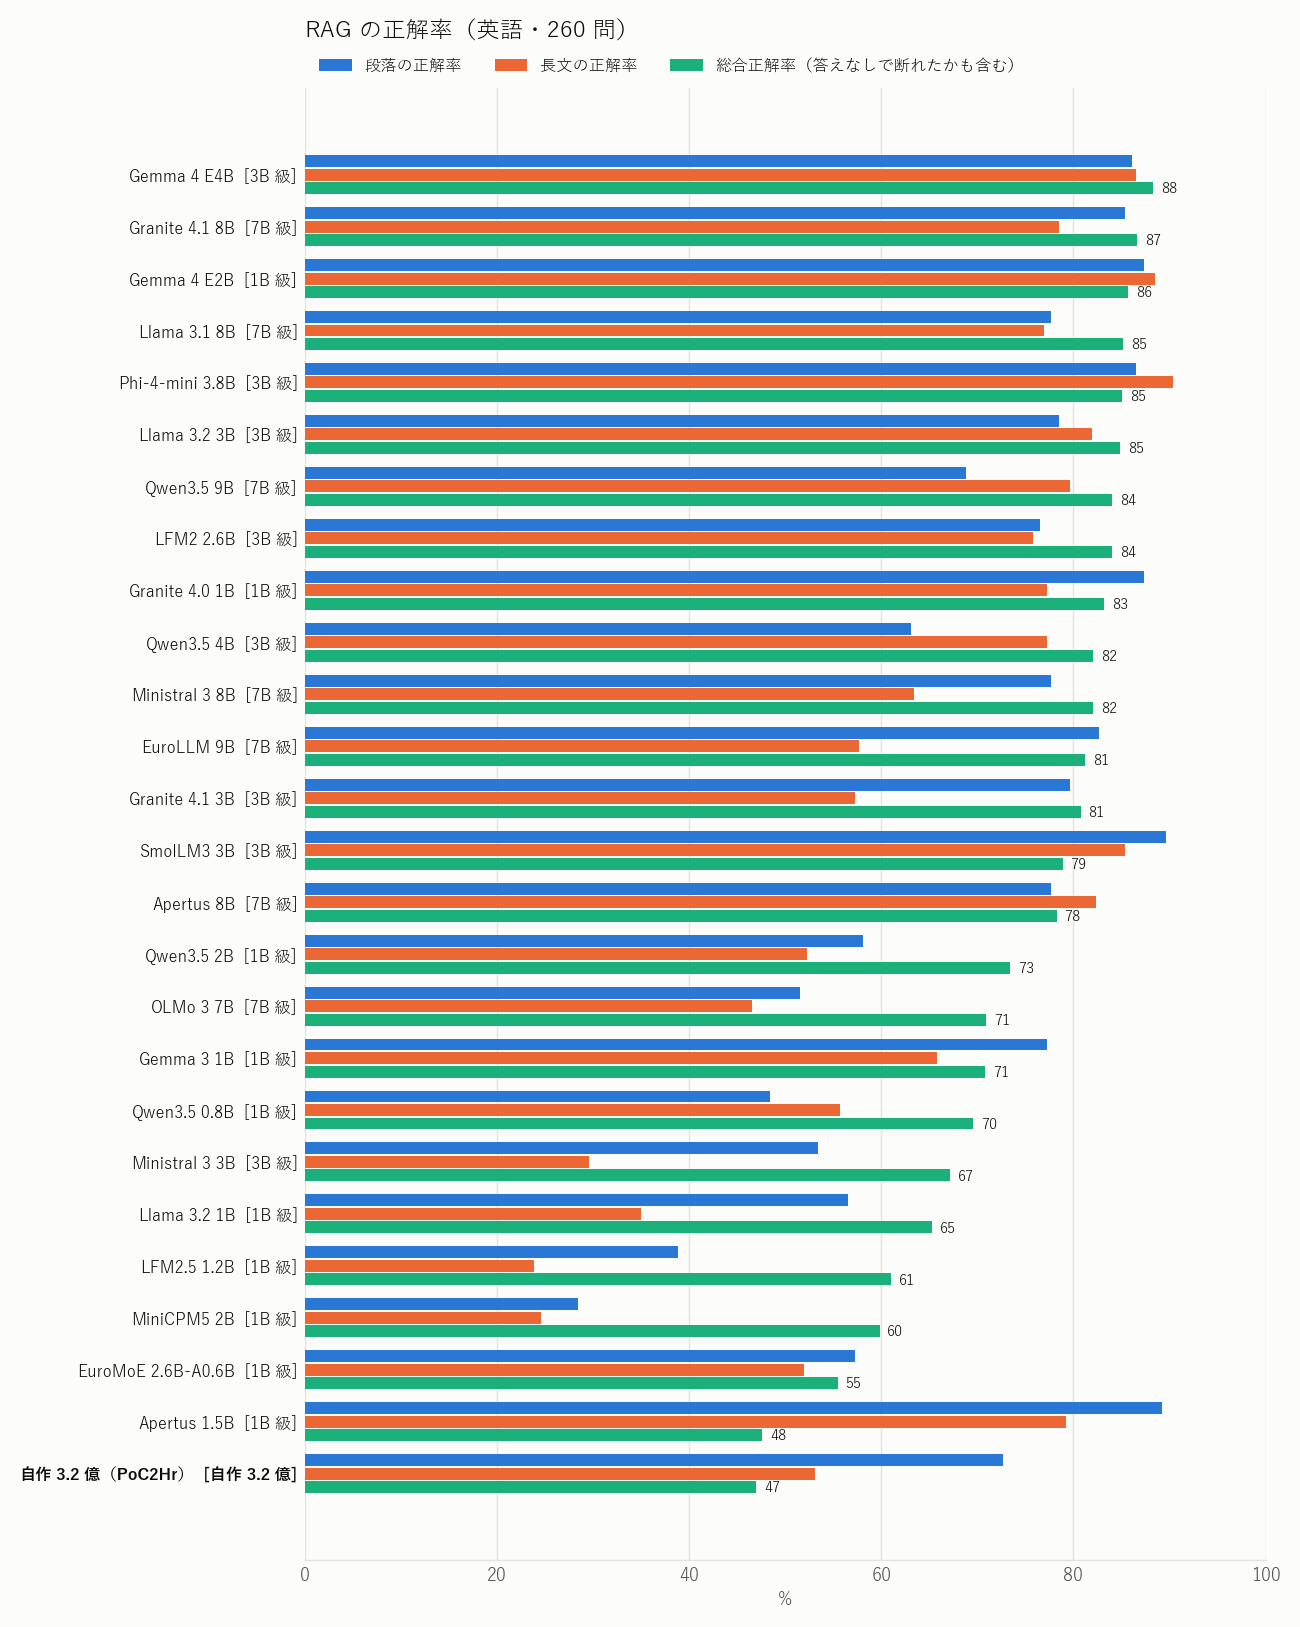
- 第一名是 Gemma 4 E4B(88%)。Gemma 4 E2B 也有 86%,Gemma 4 在两种语言中都很稳定
- 有些模型在英语中的排名会下降。 Qwen3.5 4B 从克罗地亚语的 90% → 英语的 82%。原因是明明有答案却拒答(占段落的 35%)
发现 1:差距在于“能否拒答”
给出没有答案的长文时,编造答案的比例(克罗地亚语)。
| 模型 | 在没有答案的长文中编造答案 |
|---|---|
| Qwen3.5 4B | 9% |
| 自制 3.2 亿 | 9% |
| Qwen3.5 9B | 10% |
| Gemma 4 E4B | 19% |
| Granite 4.1 8B | 30% |
| Phi-4-mini 3.8B | 64% |
| SmolLM3 3B | 73% |
| EuroMoE 2.6B-A0.6B | 94% |
例如,询问“Need for Speed Heat 是何时发布的?”,并给出一篇不含答案的长文时,Qwen3.5 9B 回答“正文中没有答案”,Phi-4-mini 却回答“1969 年 8 月”。它似乎是从文章某处捡来了一个日期。
这正是 RAG 中最令人困扰的问题。只看正确率来选模型是危险的。在已作答的回答中,Qwen3.5 的 4B 和 9B 正确比例最高,为 91~92%,Phi-4-mini 则只有 64%。
发现 2:英语中拒答过多
相反,在英语中,许多模型明明答案写得很清楚却会拒答。下面是提供含答案段落后仍拒答的比例。
| 模型 | 克罗地亚语 | 英语 |
|---|---|---|
| Qwen3.5 4B | 15% | 35% |
| Qwen3.5 0.8B | 17% | 47% |
| OLMo 3 7B | 8% | 47% |
| MiniCPM5 2B | 34% | 70% |
| Gemma 4 E4B | 9% | 8% |
例如,“Paul Accola 最后一次登上领奖台是在什么时候?”。英语段落中明确写着“the last time in 2000”,但 Qwen3.5 4B 回答“正文中没有答案”。用克罗地亚语问同一问题时,它则正确回答“2000 年”。
原因尚不清楚。英语版是机器翻译,或许文章的不自然感产生了影响;也可能是模型对英语中“没有答案时请这样回答”的指令反应过强。
结果:CPU 上的速度
由于我的使用场景以在 CPU 上运行作为前提,我将所有模型转换为 llama.cpp 的相同格式(Q4_K_M),并在 i7-13700K 上测量。生成使用 8 线程,文章读取使用 16 线程。只有 Ministral 3 无法顺利转换,因此使用了 Mistral 官方的 Q4_K_M。
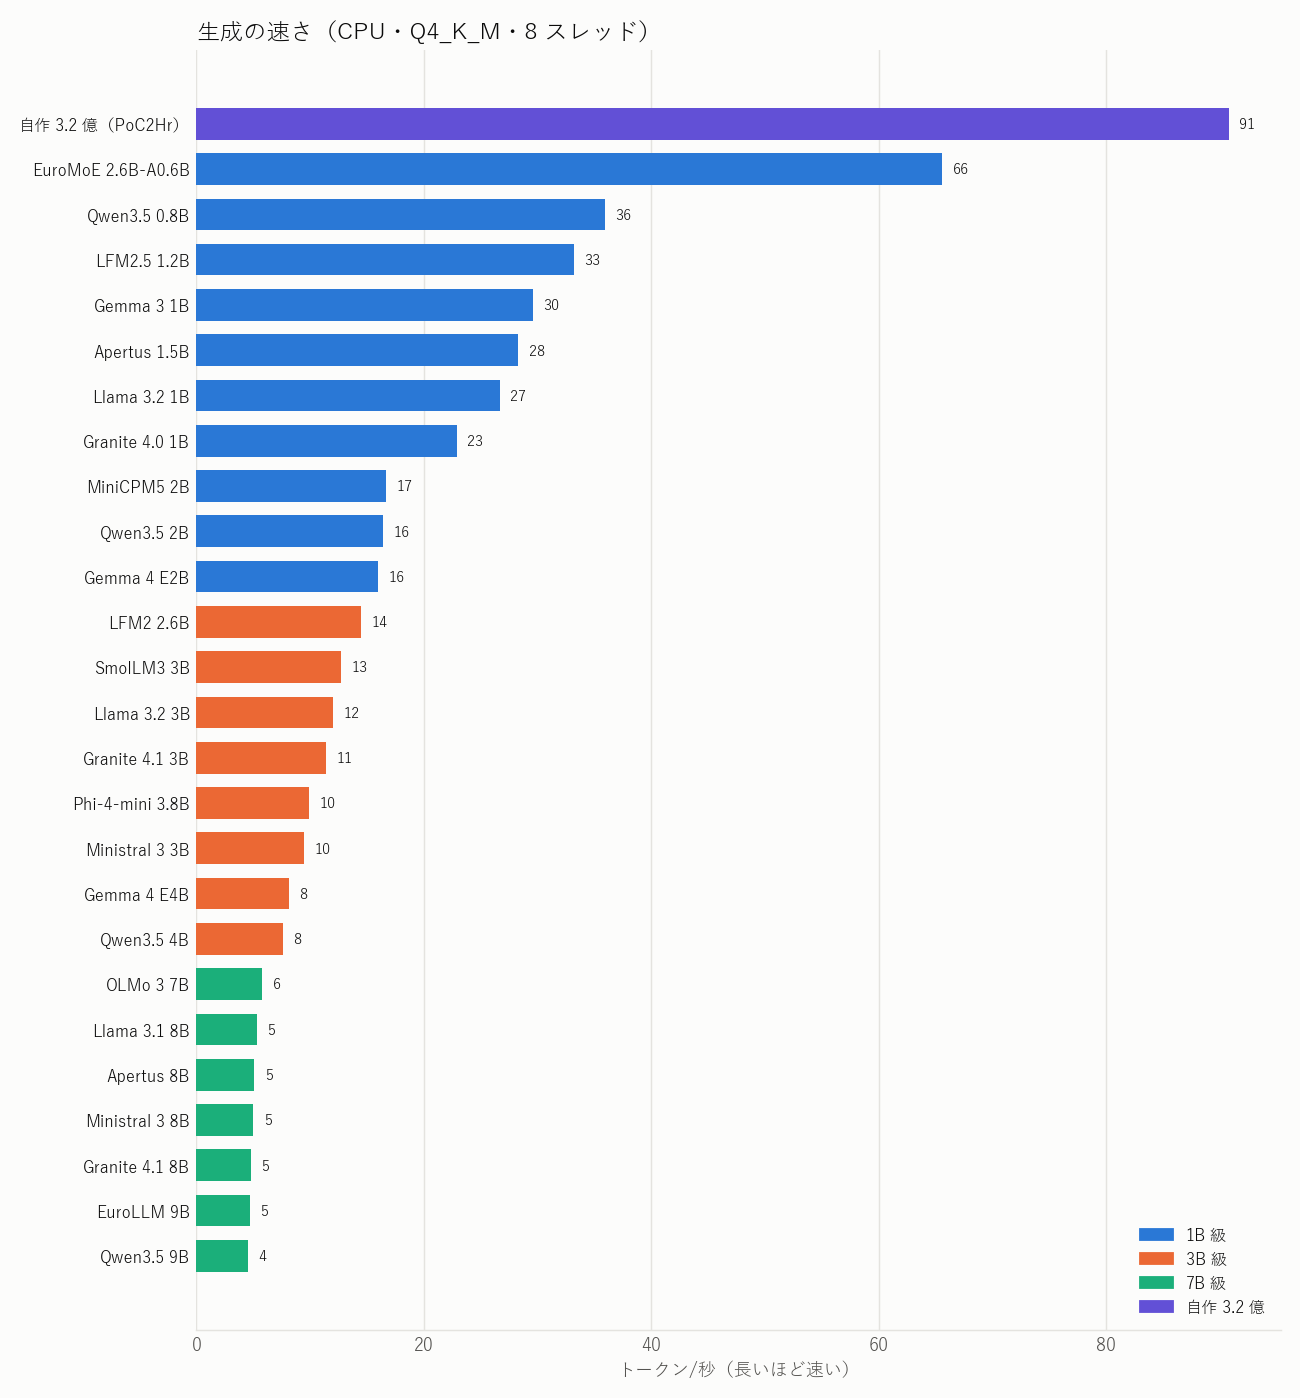
我还估算了回答一道长文问题所需的时间。按每个模型读取长文输入 token 所需的时间,加上生成平均回答长度所需的时间计算。
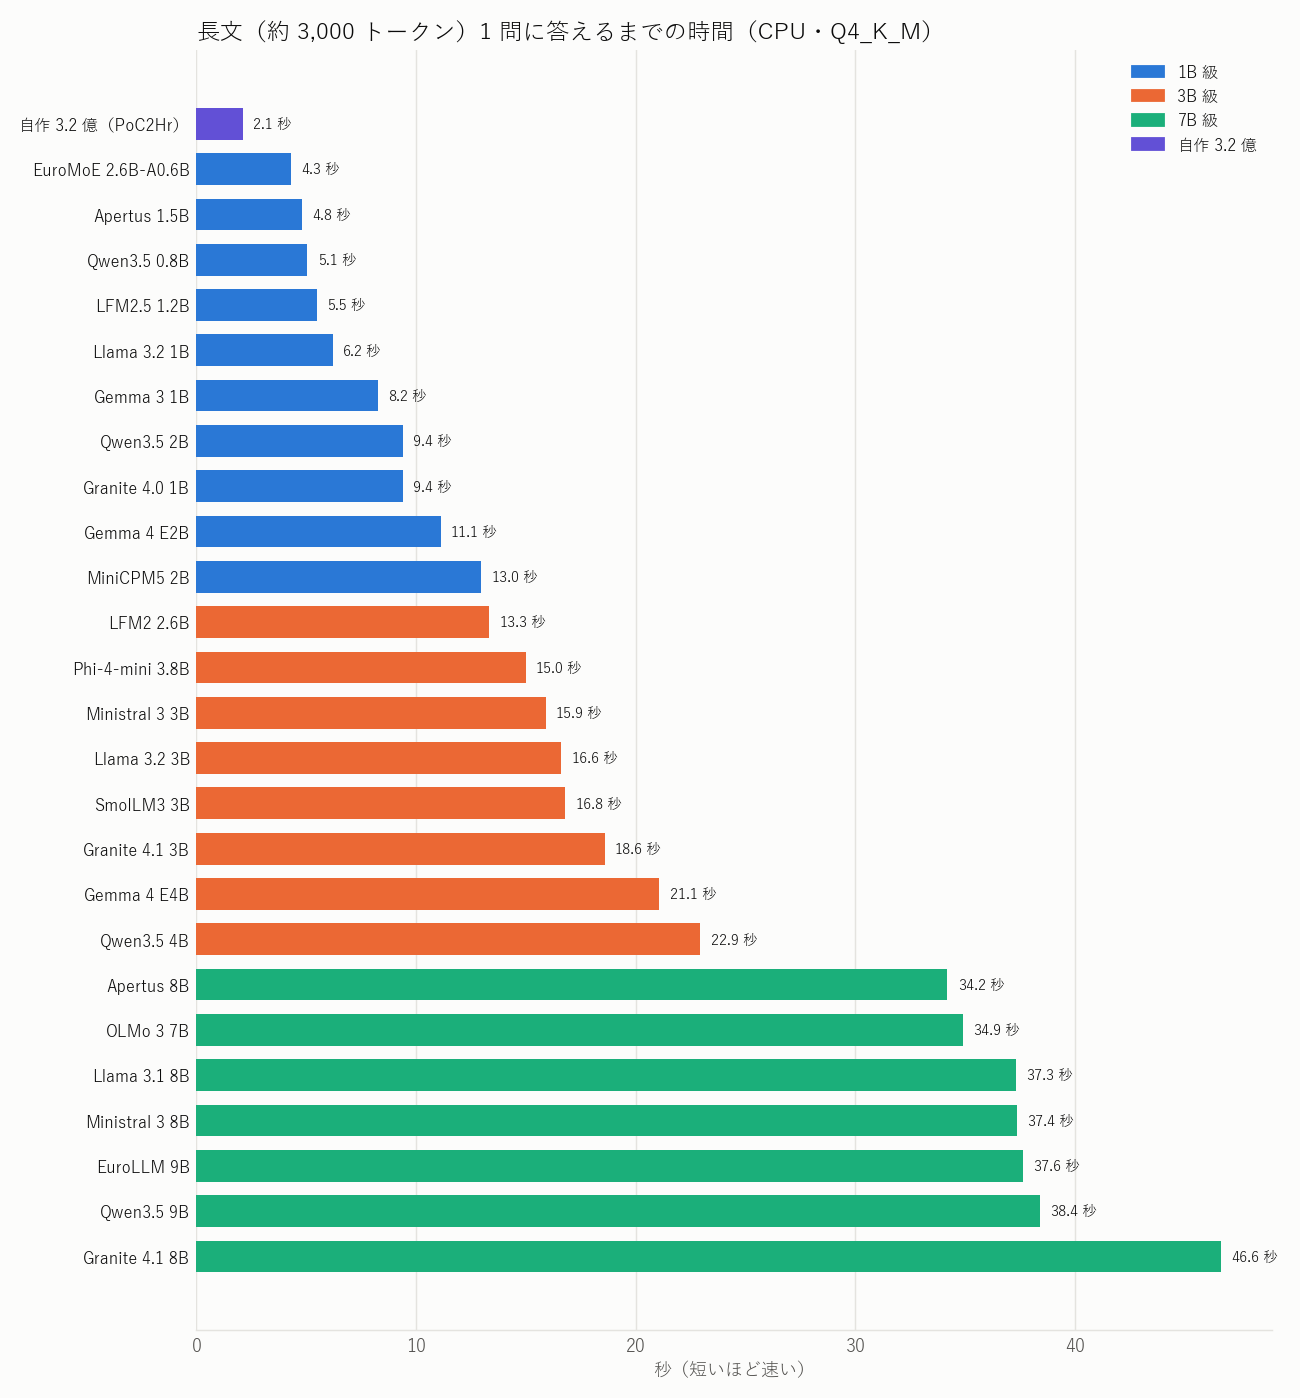
- 生成速度大致与模型大小成反比。7B 级约为每秒 5 token,回答一道长文问题需要 34~47 秒
- 3B 级需要 13~23 秒,1B 级需要 4~13 秒
- 即使是同一篇长文,不同模型的输入 token 数也在 2,443~3,796 之间。这取决于 tokenizer 能把克罗地亚语表示得多短,专为克罗地亚语打造的自制 tokenizer 最短
将速度与准确度放在一起看
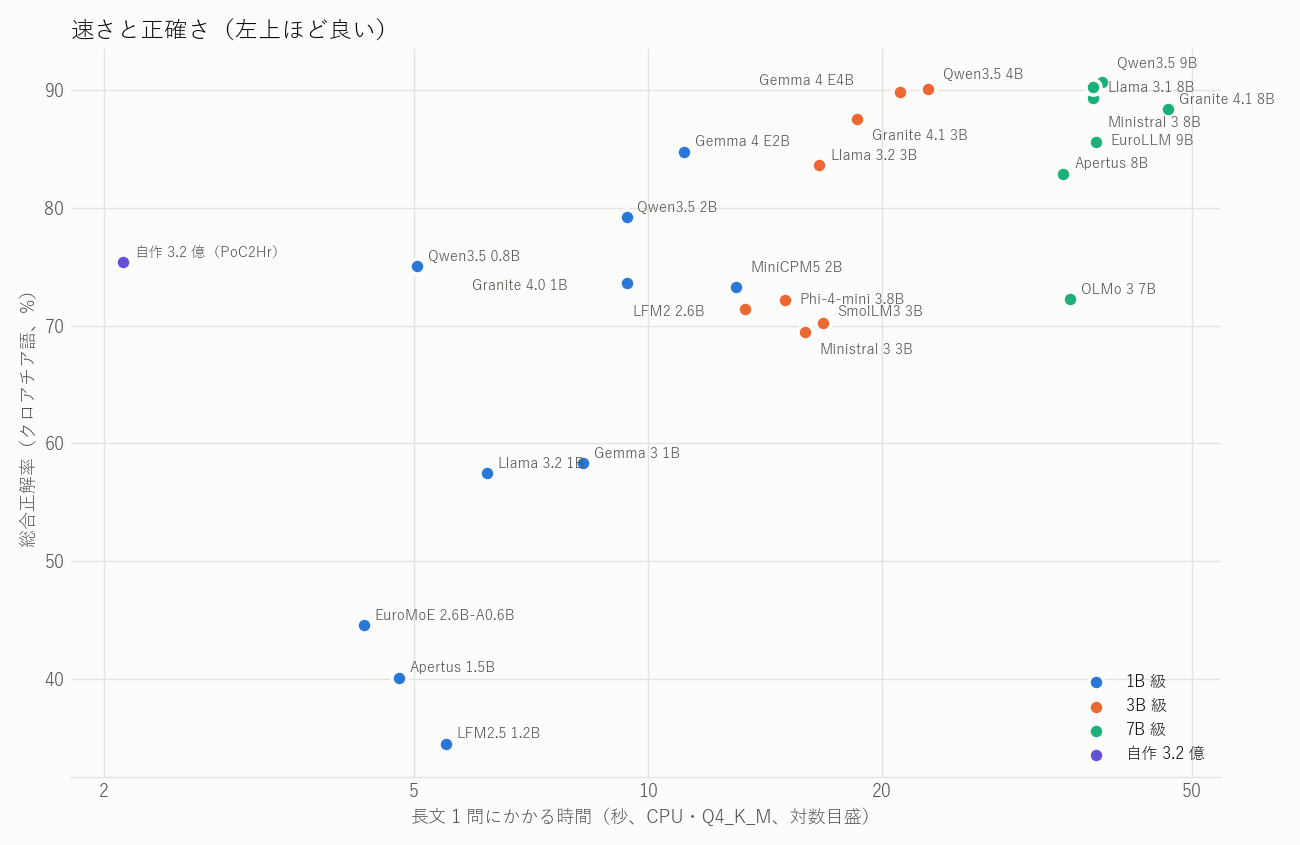
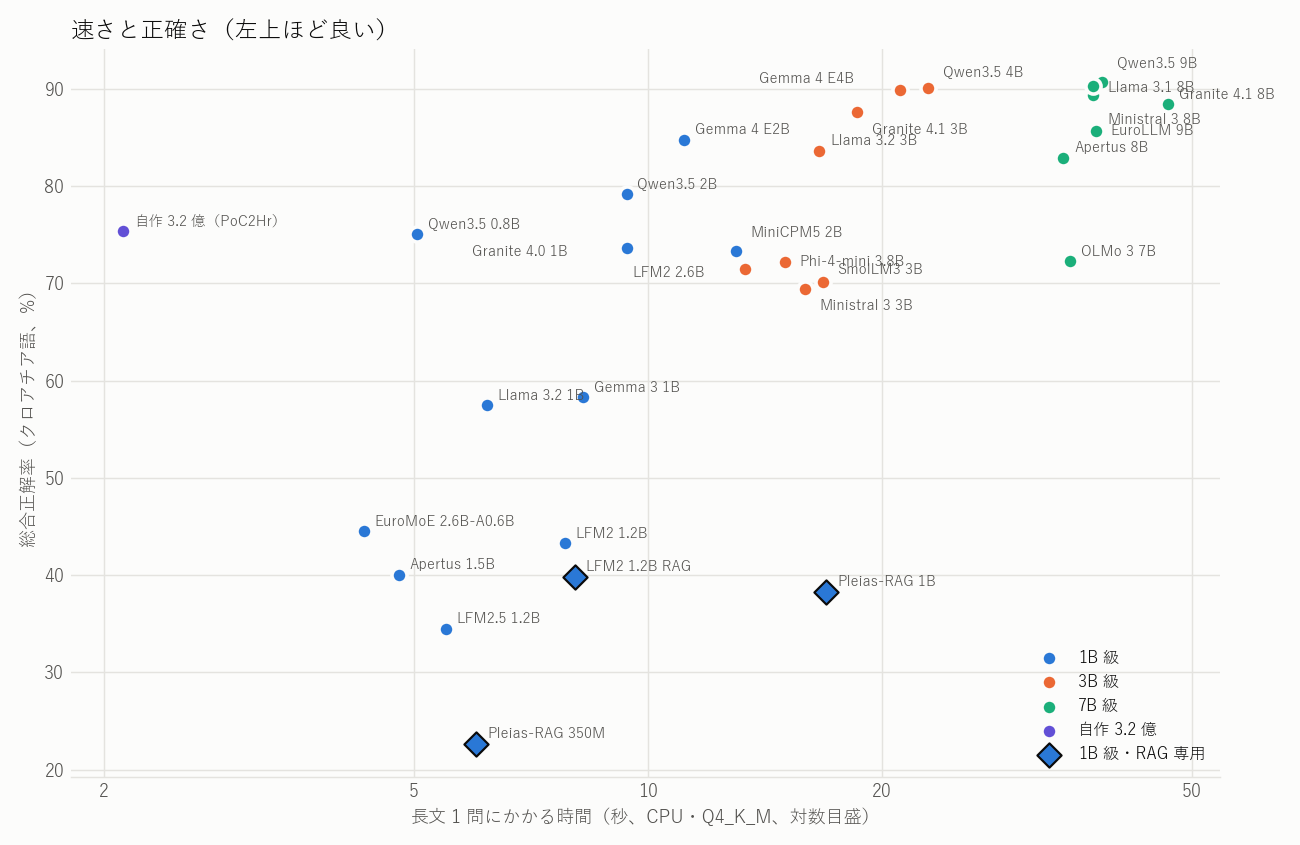
越靠左上代表“越快且越准确”。
- 平衡性好的是 Gemma 4 E2B(11 秒・85%)和 Qwen3.5 2B(9 秒・79%)
- 若优先准确度,选择 Qwen3.5 4B 或 Gemma 4 E4B(21~23 秒・90%)。它们比 7B 级快 1.5 倍以上,准确度却几乎相同
- 自制的 3.2 亿参数模型在速度上独树一帜(2.1 秒)。 75% 的综合正确率与 Qwen3.5 0.8B 相同,较少编造答案的能力与高排名模型相当。不过长文正确率只有 46%,明显弱于 Qwen3.5 0.8B(75%)和 Gemma 4 E2B(88%)
- 自制模型没有学习英语,因此在英语中,它在没有答案的长文里有 91% 会编造答案
注意事项
- 评分由 LLM 完成,因此并不完美,评分略偏宽松
- 英语版是机器翻译。问题的制作和英译都由 EuroLLM-9B 完成,因此可能对 EuroLLM 略有利(结果为中等水平的 86%)
- Apertus 1.5B 能处理的上下文最多为 4,096 token,23% 的克罗地亚语长文无法放入。无法放入的部分按错误计数
- 准确度使用 GPU(vLLM,7B 级为 FP8)测量,速度使用 CPU(Q4_K_M)测量,测试环境不同。量化可能会使准确度略有变化
- 速度是在仍打开平时使用的应用程序的 PC 上测量的。所有模型都是连续在相同条件下测量,因此我认为可以用于比较
考察
- 用于 RAG 时,4B 已经足够。 3~4B 级中的优秀模型与 7~9B 级同样准确,在 CPU 上快 1.5~2 倍
- 选模型时一定要看“能否拒答”。 即使正确率差不多,不同模型在没有答案的文章中编造的比例也从 1% 到 99% 不等。RAG 经常会通过检索找出无关文章,因此这里的影响最大
- 同一模型也会因语言而表现出不同特性。 在英语中,很多模型过于谨慎而漏掉答案。不在实际使用的语言中测试,就无法得知
- 自制模型的课题是长文。 拒答能力和速度已经足够,如果长文正确率能够提高,作为“可在 CPU 上运行的 RAG 模型”应该会相当实用。下一步想改善这里
补充:也试用了 RAG 专用模型
我想知道“专为 RAG 调优的模型怎么样?”,于是额外试用了 3 个小型 RAG 专用模型。条件与上文相同(相同的 260 道题、相同的评分方式)。
- LFM2-1.2B-RAG(Liquid AI):在 LFM2-1.2B 的基础上,使用超过 100 万条提供文档后回答的示例进行追加训练的模型。支持英语、日语等 9 种语言,不包括克罗地亚语
- Pleias-RAG-1B / Pleias-RAG-350M(PleIAs):使用约 310 万条 RAG 合成数据训练的模型。它会在回答前写出“问题分析 → 资料分析 → 草稿”,并为答案附上来自正文的引用。支持欧洲 7 种语言,不包括克罗地亚语。可处理的上下文最多为 4,096 token
- 为了比较,也测量了作为 LFM2-1.2B-RAG 基础的原始 LFM2-1.2B
我向 LFM2-1.2B-RAG 提供了与其他模型相同的指令。Pleias 只接受专用输入格式(用专用符号分隔问题和资料),因此我以与官方库相同的格式输入,并只对最终答案部分进行评分。因此无法向 Pleias 提供“没有答案时请这样回答”的指令。
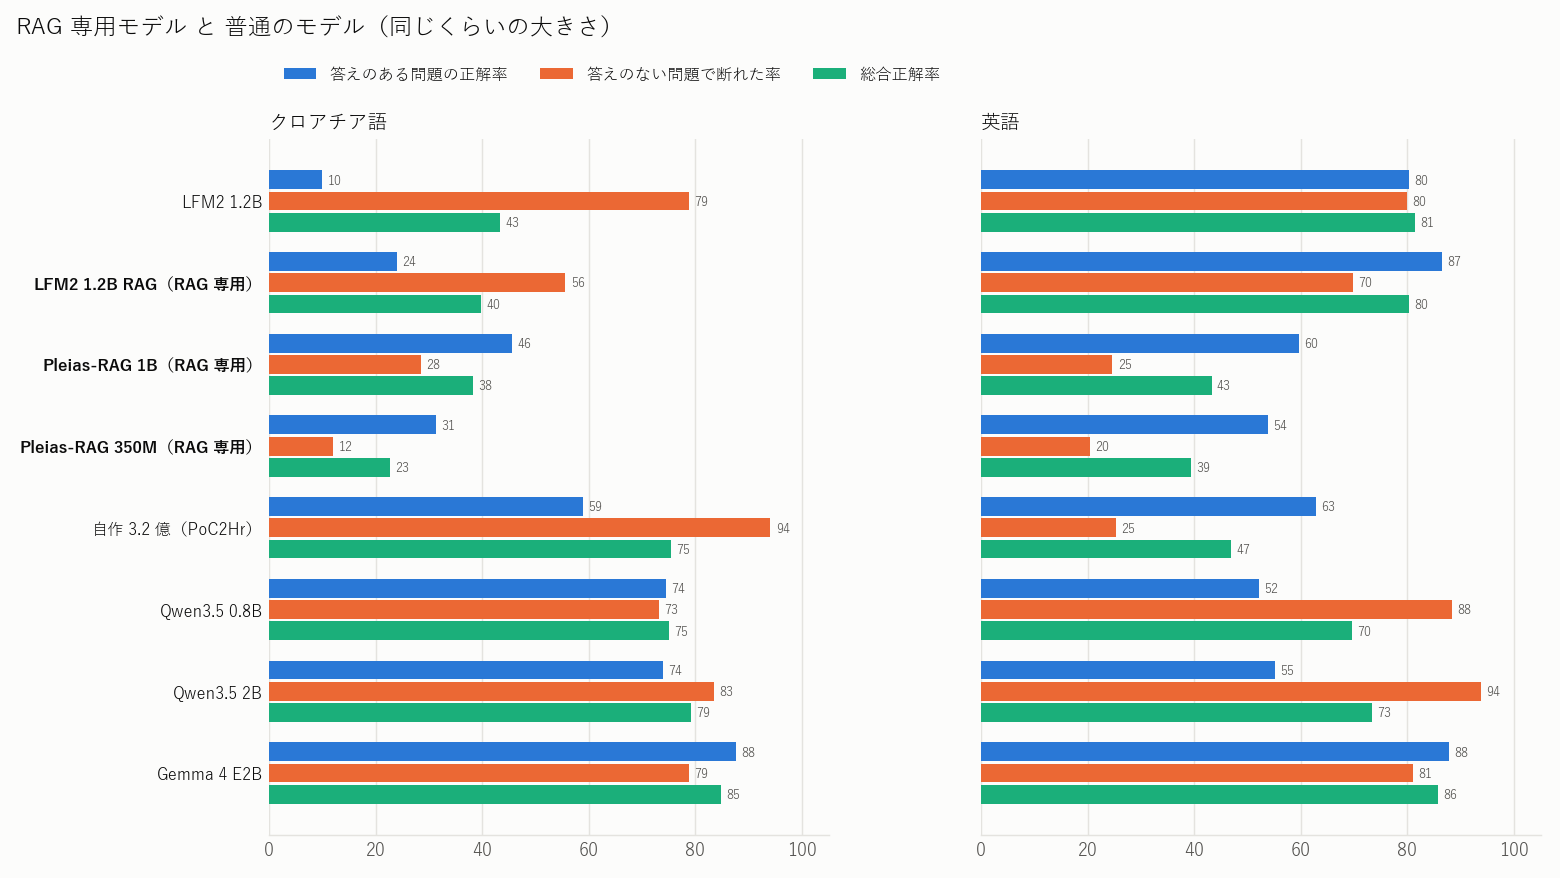
| 模型 | 综合(克罗地亚语) | 综合(英语) | 在没有答案的长文中编造答案(克罗地亚语 / 英语) | 一道长文问题的时间(CPU) |
|---|---|---|---|---|
| LFM2 1.2B(原始模型) | 43% | 81% | 42% / 36% | 7.8 秒 |
| LFM2 1.2B RAG | 40% | 80% | 61% / 51% | 8.1 秒 |
| Pleias-RAG 1B | 38% | 43% | 57% / 73% | 16.9 秒 |
| Pleias-RAG 350M | 23% | 39% | 68% / 92% | 6.0 秒 |
| 参考:自制 3.2 亿 | 75% | 47% | 9% / 91% | 2.1 秒 |
| 参考:Qwen3.5 0.8B | 75% | 70% | 43% / 21% | 5.1 秒 |
| 参考:Gemma 4 E2B | 85% | 86% | 37% / 32% | 11.1 秒 |
先说结论:在这次的问题中,没有发现 RAG 专用模型优于普通模型之处。
LFM2-1.2B-RAG:虽然更会回答了,但编造也增加了
与原始 LFM2-1.2B 相比,在英语中,有答案问题的正确率提高了(段落 83% → 87%、长文 78% → 86%)。但在没有答案的文章中,编造答案也增加了(段落 4% → 10%、长文 36% → 51%),综合成绩从 81% → 80%,几乎相同。看起来用于 RAG 的追加训练使它更倾向于“无论如何都要回答”。
克罗地亚语在原始模型阶段几乎就无法使用。原始 LFM2-1.2B 对含答案段落中的 93% 都拒答“没有答案”;RAG 版中还频繁出现直接返回指令文本本身的回答,例如“Odgovori kratko, jednom rečenicom.(用一句话简短回答)”。由于不在支持语言中,这也无可奈何。
Pleias-RAG:会附引用,但引用并不在正文中
Pleias 即使面对没有答案的文章,也几乎不会拒答。在英语中,1B 在没有答案的段落中有 78%、在没有答案的长文中有 73% 会编造答案。
其卖点“附引用的答案”也令人存疑。我统计了引用句子能否在正文中原样找到的比例(这是仅忽略空格差异的完全匹配,因此稍微改写过的引用也会被计为“找不到”)。
| 有答案的问题 | 没有答案的问题 | |
|---|---|---|
| Pleias-RAG 1B(英语) | 64% | 42% |
| Pleias-RAG 1B(克罗地亚语) | 57% | 53% |
| Pleias-RAG 350M(英语) | 66% | 39% |
| Pleias-RAG 350M(克罗地亚语) | 52% | 40% |
例如,“最初创作名为 Tourniquet 的歌曲的乐队是?”(答案是 Soul Embraced)。
- 提供不含答案的段落时,1B 回答“Amy Lee 创作的”,并将“Amy Lee (born Amy Leigh Lee, November 1, 1970) ...”这句正文中不存在的句子作为引用附上
- 即使提供了包含答案的段落,它仍回答“Amy Lee 创作的”。而且它附上的引用是“originally written ... for the Christian death metal band Soul Embraced”,引用是正确的,但答案与引用相矛盾
有引用会让人觉得“确实基于正文”,因此反而更危险。
从速度来看,Pleias 会在回答前写分析,因此回答很长(长文平均为 381~420 token)。1B 回答一道长文问题需要 16.9 秒,比 Gemma 4 E2B(11.1 秒)还慢。而且 25% 的克罗地亚语长文无法放入上下文中(按错误计数。时间只取能放入的问题的平均值,因此实际还会更久)。
为什么会这样?(推测)
- 语言:3 个模型都未将克罗地亚语列入支持语言。不过即使在英语中也输给了普通模型
- 问题形式:这次是“从一篇文章中简短回答/没有答案则拒答”的问题。Pleias 的评测使用的是结合多份资料来回答的问题(如 HotpotQA),可能擅长的形式不同
- 拒答方式:可以向普通模型指示“没有答案时请这样回答”,但 Pleias 没有传递指令的位置。模型本身具备判断“无法根据这份资料回答”的机制,但这次几乎没有发挥作用
补充总结
- 不应只因名称是“RAG 专用”就选择它。 在这次条件下,Gemma 4 E2B、Qwen3.5 等普通指令模型更准确,也能在应当拒答时拒答
- 附引用的答案如果不核实引用本身,就没有意义。 Pleias 的引用中,只有 40%~70% 能在正文中原样找到
- 自制模型优于同等大小的 RAG 专用模型。 与 Pleias-RAG 350M 相比,克罗地亚语综合成绩为 75% 对 23%,回答一道长文问题的时间为 2.1 秒对 6.0 秒。专为克罗地亚语打造是有意义的
新增的 4 个模型的速度是在同一天晚上、同一台 PC、相同条件下测量的。也已加入速度与准确度图中。
全部结果
克罗地亚语
| 模型 | 级别 | 段落正确率 | 长文正确率 | 总体 | 无答案时编造(段落/长文) | 在作答中正确的比例 |
|---|---|---|---|---|---|---|
| Qwen3.5 9B | 7B 级 | 84% | 90% | 91% | 1% / 10% | 91% |
| Llama 3.1 8B | 7B 级 | 88% | 88% | 90% | 2% / 15% | 90% |
| Qwen3.5 4B | 3B 级 | 82% | 88% | 90% | 1% / 9% | 92% |
| Gemma 4 E4B | 3B 级 | 87% | 91% | 90% | 2% / 19% | 87% |
| Ministral 3 8B | 7B 级 | 88% | 85% | 89% | 3% / 14% | 89% |
| Granite 4.1 8B | 7B 级 | 91% | 90% | 88% | 2% / 30% | 84% |
| Granite 4.1 3B | 3B 级 | 88% | 88% | 88% | 2% / 29% | 83% |
| EuroLLM 9B | 7B 级 | 87% | 75% | 86% | 5% / 14% | 88% |
| Gemma 4 E2B | 1B 级 | 88% | 88% | 85% | 5% / 37% | 78% |
| Llama 3.2 3B | 3B 级 | 80% | 81% | 84% | 2% / 27% | 81% |
| Apertus 8B | 7B 级 | 85% | 80% | 83% | 8% / 29% | 81% |
| Qwen3.5 2B | 1B 级 | 74% | 74% | 79% | 4% / 29% | 79% |
| 自制 3.2 亿 | 自制 | 72% | 46% | 75% | 3% / 9% | 72% |
| Qwen3.5 0.8B | 1B 级 | 74% | 75% | 75% | 11% / 43% | 68% |
| Granite 4.0 1B | 1B 级 | 83% | 77% | 74% | 22% / 51% | 64% |
| MiniCPM5 2B | 1B 级 | 62% | 44% | 73% | 1% / 6% | 89% |
| OLMo 3 7B | 7B 级 | 80% | 70% | 72% | 7% / 64% | 62% |
| Phi-4-mini 3.8B | 3B 级 | 91% | 89% | 72% | 38% / 64% | 64% |
| LFM2 2.6B | 3B 级 | 69% | 61% | 71% | 5% / 43% | 62% |
| SmolLM3 3B | 3B 级 | 83% | 78% | 70% | 20% / 73% | 62% |
| Ministral 3 3B | 3B 级 | 64% | 28% | 69% | 2% / 5% | 90% |
| Gemma 3 1B | 1B 级 | 79% | 62% | 58% | 32% / 89% | 48% |
| Llama 3.2 1B | 1B 级 | 73% | 35% | 57% | 43% / 33% | 48% |
| EuroMoE 2.6B-A0.6B | 1B 级 | 73% | 67% | 45% | 80% / 94% | 42% |
| LFM2 1.2B | 1B 级 | 5% | 15% | 43% | 1% / 42% | 21% |
| Apertus 1.5B | 1B 级 | 88% | 58% | 40% | 99% / 75% | 44% |
| LFM2 1.2B RAG | 1B 级・RAG 专用 | 23% | 25% | 40% | 28% / 61% | 24% |
| Pleias-RAG 1B | 1B 级・RAG 专用 | 73% | 18% | 38% | 63% / 57% | 35% |
| LFM2.5 1.2B | 1B 级 | 45% | 18% | 34% | 53% / 75% | 23% |
| Pleias-RAG 350M | 1B 级・RAG 专用 | 54% | 9% | 23% | 85% / 68% | 21% |
英语
| 模型 | 级别 | 段落正确率 | 长文正确率 | 总体 | 无答案时编造(段落/长文) | 在作答中正确的比例 |
|---|---|---|---|---|---|---|
| Gemma 4 E4B | 3B 级 | 86% | 87% | 88% | 3% / 18% | 85% |
| Granite 4.1 8B | 7B 级 | 85% | 78% | 87% | 3% / 15% | 89% |
| Gemma 4 E2B | 1B 级 | 87% | 88% | 86% | 6% / 32% | 79% |
| Llama 3.1 8B | 7B 级 | 78% | 77% | 85% | 2% / 11% | 89% |
| Phi-4-mini 3.8B | 3B 级 | 87% | 90% | 85% | 10% / 31% | 80% |
| Llama 3.2 3B | 3B 级 | 78% | 82% | 85% | 2% / 20% | 85% |
| LFM2 2.6B | 3B 级 | 77% | 76% | 84% | 2% / 13% | 88% |
| Qwen3.5 9B | 7B 级 | 69% | 80% | 84% | 1% / 9% | 92% |
| Granite 4.0 1B | 1B 级 | 87% | 77% | 83% | 6% / 29% | 81% |
| Ministral 3 8B | 7B 级 | 78% | 63% | 82% | 2% / 8% | 91% |
| Qwen3.5 4B | 3B 级 | 63% | 77% | 82% | 1% / 8% | 92% |
| EuroLLM 9B | 7B 级 | 83% | 58% | 81% | 3% / 10% | 90% |
| Granite 4.1 3B | 3B 级 | 80% | 57% | 81% | 1% / 10% | 90% |
| LFM2 1.2B | 1B 级 | 83% | 78% | 81% | 4% / 36% | 76% |
| LFM2 1.2B RAG | 1B 级・RAG 专用 | 87% | 86% | 80% | 10% / 51% | 73% |
| SmolLM3 3B | 3B 级 | 90% | 85% | 79% | 16% / 52% | 71% |
| Apertus 8B | 7B 级 | 78% | 82% | 78% | 7% / 47% | 73% |
| Qwen3.5 2B | 1B 级 | 58% | 52% | 73% | 2% / 11% | 87% |
| OLMo 3 7B | 7B 级 | 52% | 47% | 71% | 0% / 8% | 90% |
| Gemma 3 1B | 1B 级 | 77% | 66% | 71% | 11% / 57% | 62% |
| Qwen3.5 0.8B | 1B 级 | 48% | 56% | 70% | 2% / 21% | 77% |
| Ministral 3 3B | 3B 级 | 53% | 30% | 67% | 1% / 6% | 90% |
| Llama 3.2 1B | 1B 级 | 57% | 35% | 65% | 9% / 16% | 73% |
| LFM2.5 1.2B | 1B 级 | 39% | 24% | 61% | 1% / 9% | 76% |
| MiniCPM5 2B | 1B 级 | 28% | 25% | 60% | 0% / 3% | 92% |
| EuroMoE 2.6B-A0.6B | 1B 级 | 57% | 52% | 55% | 27% / 66% | 53% |
| Apertus 1.5B | 1B 级 | 89% | 79% | 48% | 93% / 97% | 47% |
| 自制 3.2 亿 | 自制 | 73% | 53% | 47% | 55% / 91% | 40% |
| Pleias-RAG 1B | 1B 级・RAG 专用 | 75% | 44% | 43% | 78% / 73% | 40% |
| Pleias-RAG 350M | 1B 级・RAG 专用 | 63% | 44% | 39% | 67% / 92% | 34% |
CPU 上的速度(i7-13700K・llama.cpp Q4_K_M)
| 模型 | 大小 | 生成(词元/秒) | 读取(词元/秒) | 长文输入词元数 | 长文单题耗时 |
|---|---|---|---|---|---|
| 自制 3.2 亿 | 193 MB | 90.8 | 1,528 | 2,443 | 2.1 秒 |
| EuroMoE 2.6B-A0.6B | 1,541 MB | 65.6 | 778 | 2,920 | 4.3 秒 |
| Apertus 1.5B | 935 MB | 28.3 | 634 | 2,810 ※ | 4.8 秒 |
| Qwen3.5 0.8B | 517 MB | 35.9 | 742 | 3,258 | 5.1 秒 |
| LFM2.5 1.2B | 697 MB | 33.2 | 673 | 3,468 | 5.5 秒 |
| Pleias-RAG 350M | 219 MB | 97.2 | 1,685 | 2,853 ※ | 6.0 秒 |
| Llama 3.2 1B | 770 MB | 26.7 | 636 | 3,511 | 6.2 秒 |
| LFM2 1.2B | 697 MB | 31.4 | 675 | 3,468 | 7.8 秒 |
| LFM2 1.2B RAG | 697 MB | 32.8 | 678 | 3,468 | 8.1 秒 |
| Gemma 3 1B | 769 MB | 29.6 | 398 | 3,055 | 8.2 秒 |
| Qwen3.5 2B | 1,251 MB | 16.4 | 415 | 3,258 | 9.4 秒 |
| Granite 4.0 1B | 976 MB | 22.9 | 414 | 3,636 | 9.4 秒 |
| Gemma 4 E2B | 3,257 MB | 16.0 | 329 | 3,055 | 11.1 秒 |
| MiniCPM5 2B | 1,489 MB | 16.7 | 313 | 3,796 | 13.0 秒 |
| LFM2 2.6B | 1,491 MB | 14.5 | 278 | 3,468 | 13.3 秒 |
| Phi-4-mini 3.8B | 2,378 MB | 9.9 | 208 | 2,974 | 15.0 秒 |
| Ministral 3 3B | 2,048 MB | 9.5 | 215 | 3,100 | 15.9 秒 |
| Llama 3.2 3B | 1,926 MB | 12.0 | 237 | 3,511 | 16.6 秒 |
| SmolLM3 3B | 1,827 MB | 12.7 | 238 | 3,544 | 16.8 秒 |
| Pleias-RAG 1B | 710 MB | 31.6 | 583 | 2,853 ※ | 16.9 秒 |
| Granite 4.1 3B | 2,002 MB | 11.4 | 202 | 3,614 | 18.6 秒 |
| Gemma 4 E4B | 5,064 MB | 8.1 | 171 | 3,055 | 21.1 秒 |
| Qwen3.5 4B | 2,655 MB | 7.6 | 166 | 3,258 | 22.9 秒 |
| Apertus 8B | 4,824 MB | 5.1 | 102 | 3,158 | 34.2 秒 |
| OLMo 3 7B | 4,264 MB | 5.8 | 108 | 3,642 | 34.9 秒 |
| Llama 3.1 8B | 4,693 MB | 5.3 | 101 | 3,511 | 37.3 秒 |
| Ministral 3 8B | 4,958 MB | 5.0 | 95 | 3,100 | 37.4 秒 |
| EuroLLM 9B | 5,324 MB | 4.7 | 86 | 2,920 | 37.6 秒 |
| Qwen3.5 9B | 5,512 MB | 4.5 | 101 | 3,258 | 38.4 秒 |
| Granite 4.1 8B | 5,100 MB | 4.8 | 88 | 3,614 | 46.6 秒 |
※ Apertus 1.5B 和 Pleias-RAG 的数值,仅为能纳入 4,096 词元上下文的长文平均值。