Qwen-Image 2.1 完全指南:以 7B 统一图像生成、编辑与透明 PNG,Reddit 热门案例 100 选
2026 年 9 月 20 日,Qwen 团队发布了图像生成模型「Qwen-Image 2.1」。其最大特点是将文生图、基于参考图的编辑、多图合成、局部编辑,以及透明背景(RGBA)的生成与编辑整合到同一个模型中。图像生成部分拥有 70 亿参数。它并非一味追求超大规模,而是瞄准更适合本地环境运行的尺寸与处理效率。
先说结论:Qwen-Image 2.1 与其说是一个“从零画出最佳成图的模型”,不如说是一个特别有趣的“创作型模型”——它能够尽量不破坏已有图像、组合多个素材,并精准修改目标区域。Reddit 上获得高度评价的也主要是编辑能力、角色一致性、商品合成、扩图和透明素材。另一方面,手指、远景人脸、细节噪点、死黑、老照片修复以及动漫风格等方面,也有明确的弱点报告。
本文基于官方信息梳理全部功能,并横跨 Reddit 的主要讨论帖,将热门的生成与编辑测试汇总为“案例 100 选”。这里的 100 项并不意味着 100 个独立帖子,而是统计了多个热门帖子、图库和工作流中验证过的单项绘制主题或编辑操作。
什么是 Qwen-Image 2.1
Qwen-Image 2.1 是 Qwen 系列的一体化图像生成与编辑模型。根据官方说明,生成部分采用 32 层 Single-Stream DiT 和 70 亿参数。Qwen3-VL 8B 将文字指令和条件图像转换为统一表示,64 通道 RGBA VAE 则负责 16 倍空间压缩与原生透明度。
官方列出的四项改进如下。
- 小型且高效:通过混合粒度注意力和 prefix KV cache 复用,改善质量与计算成本之间的平衡。
- 生成与编辑统一:可在同一模型中生成和编辑普通图像与透明图像。
- 多用途编辑:支持最多 10 张参考图、通过蒙版或涂绘进行局部指定,以及保持人物和商品的一致性。
- 质感与美感:改进了排版、人像光照和细微纹理。
来源:Qwen 官方博客、官方 GitHub、Diffusers 文档
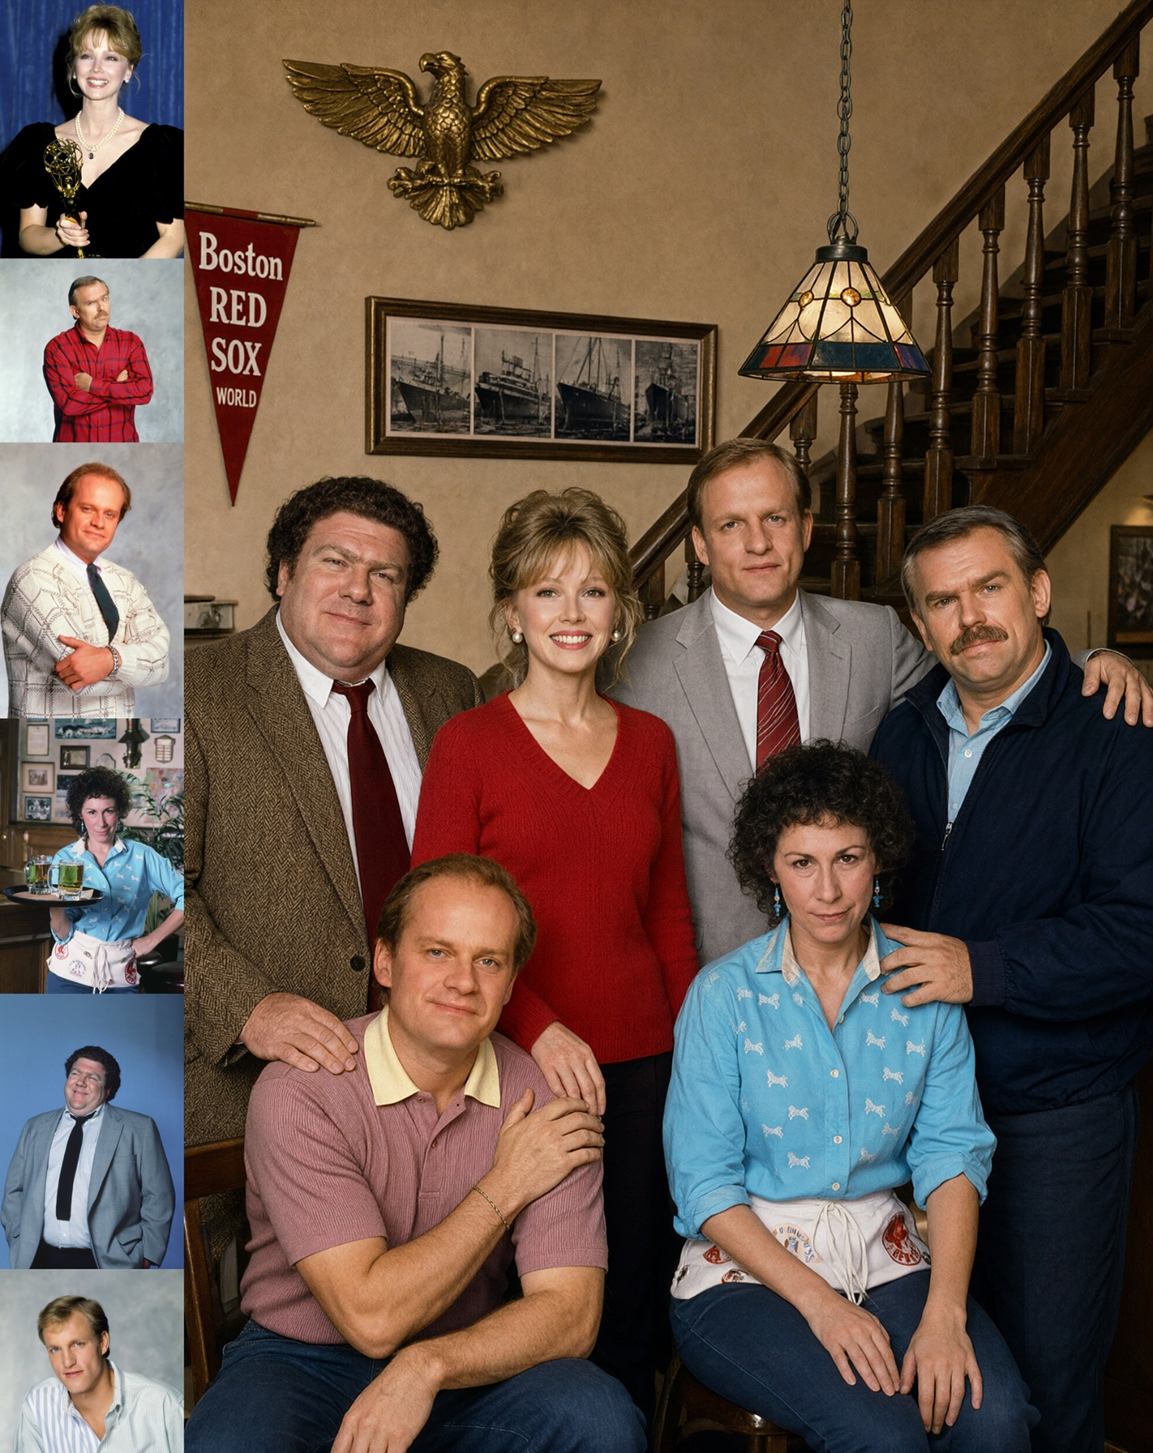
功能总览
1. 文本生成图像
支持常规的 Text-to-Image。不仅可以处理简短指令,也能通过 Qwen3-VL 理解长篇自然语言、构图、光线、材质、前景与背景,以及包含文字元素的复杂要求。官方示例以 40 步为基础;社区中也在测试 8~16 步的加速 LoRA,以及注重质量的 30~40 步设置。
2. 图像编辑
可同时提供输入图像与文字指令,从而修改颜色、天气、背景、服装、姿势、材质、光照和相机角度等。Reddit 上普遍认为,它的编辑能力比纯 T2I 更强。
3. 最多 10 张参考图
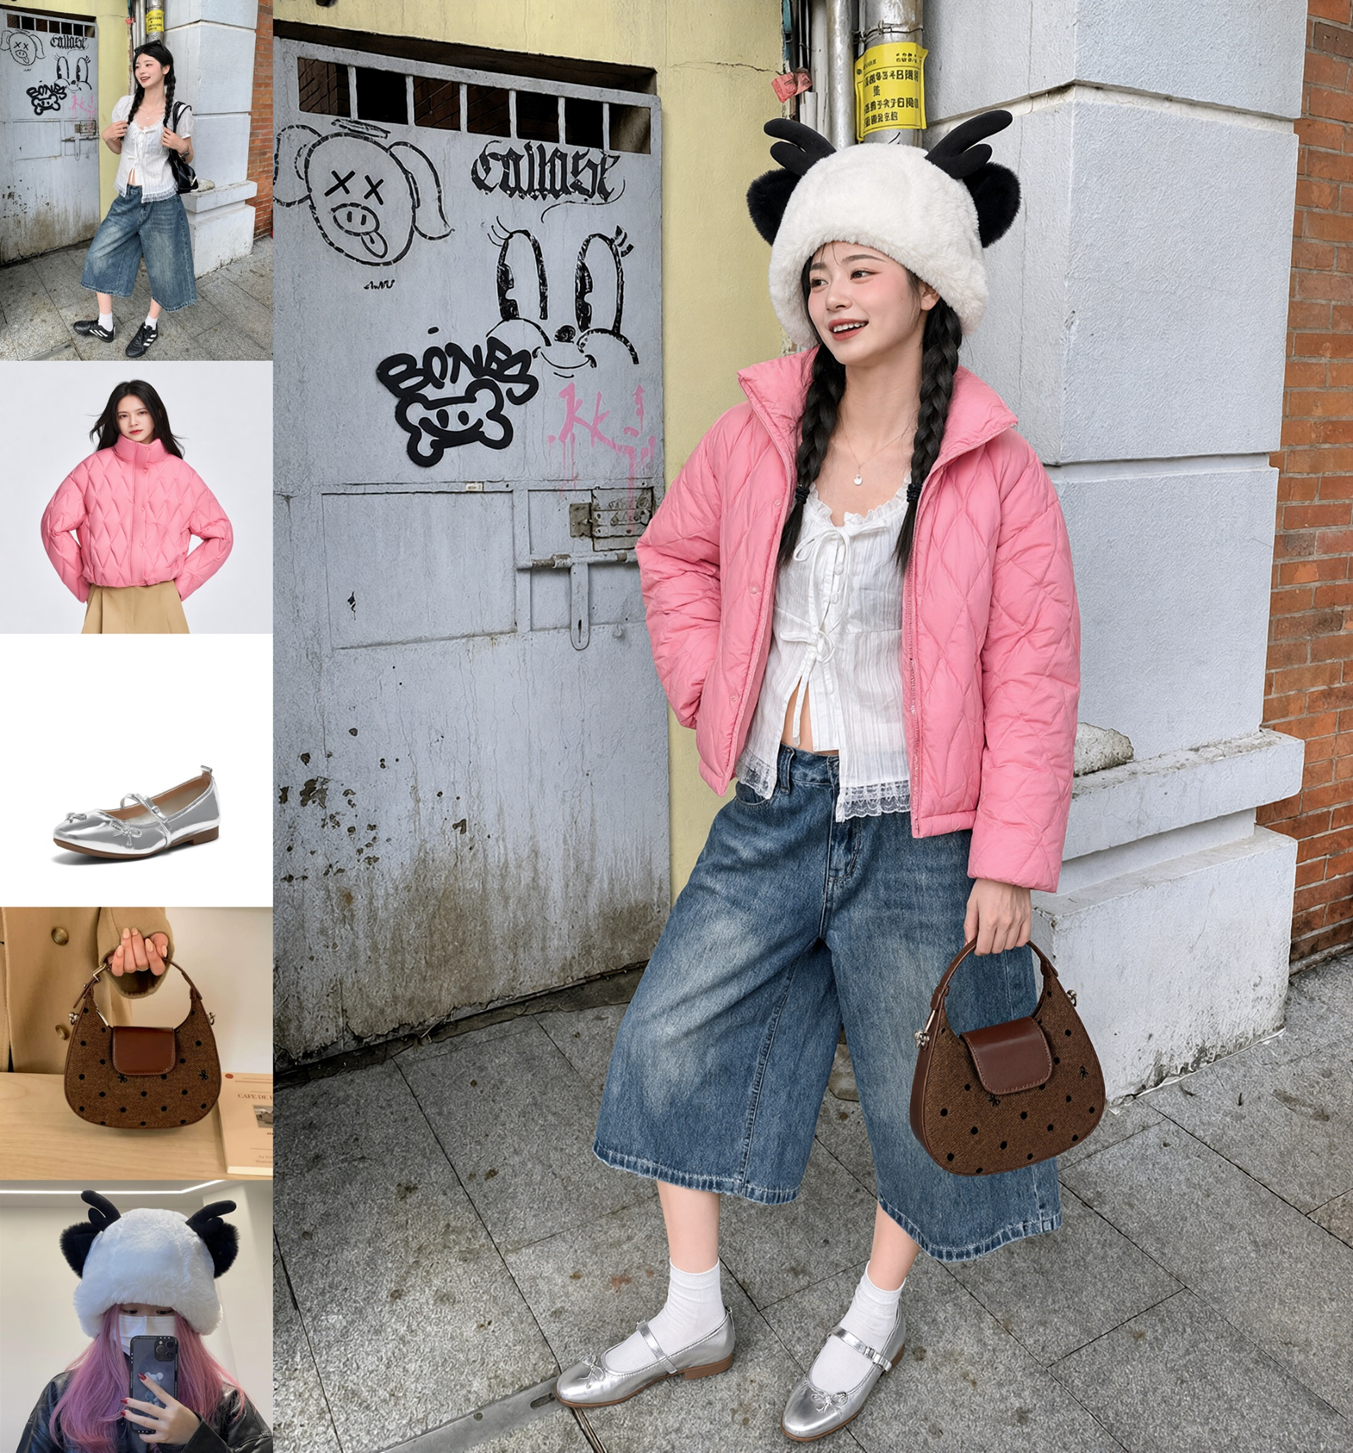
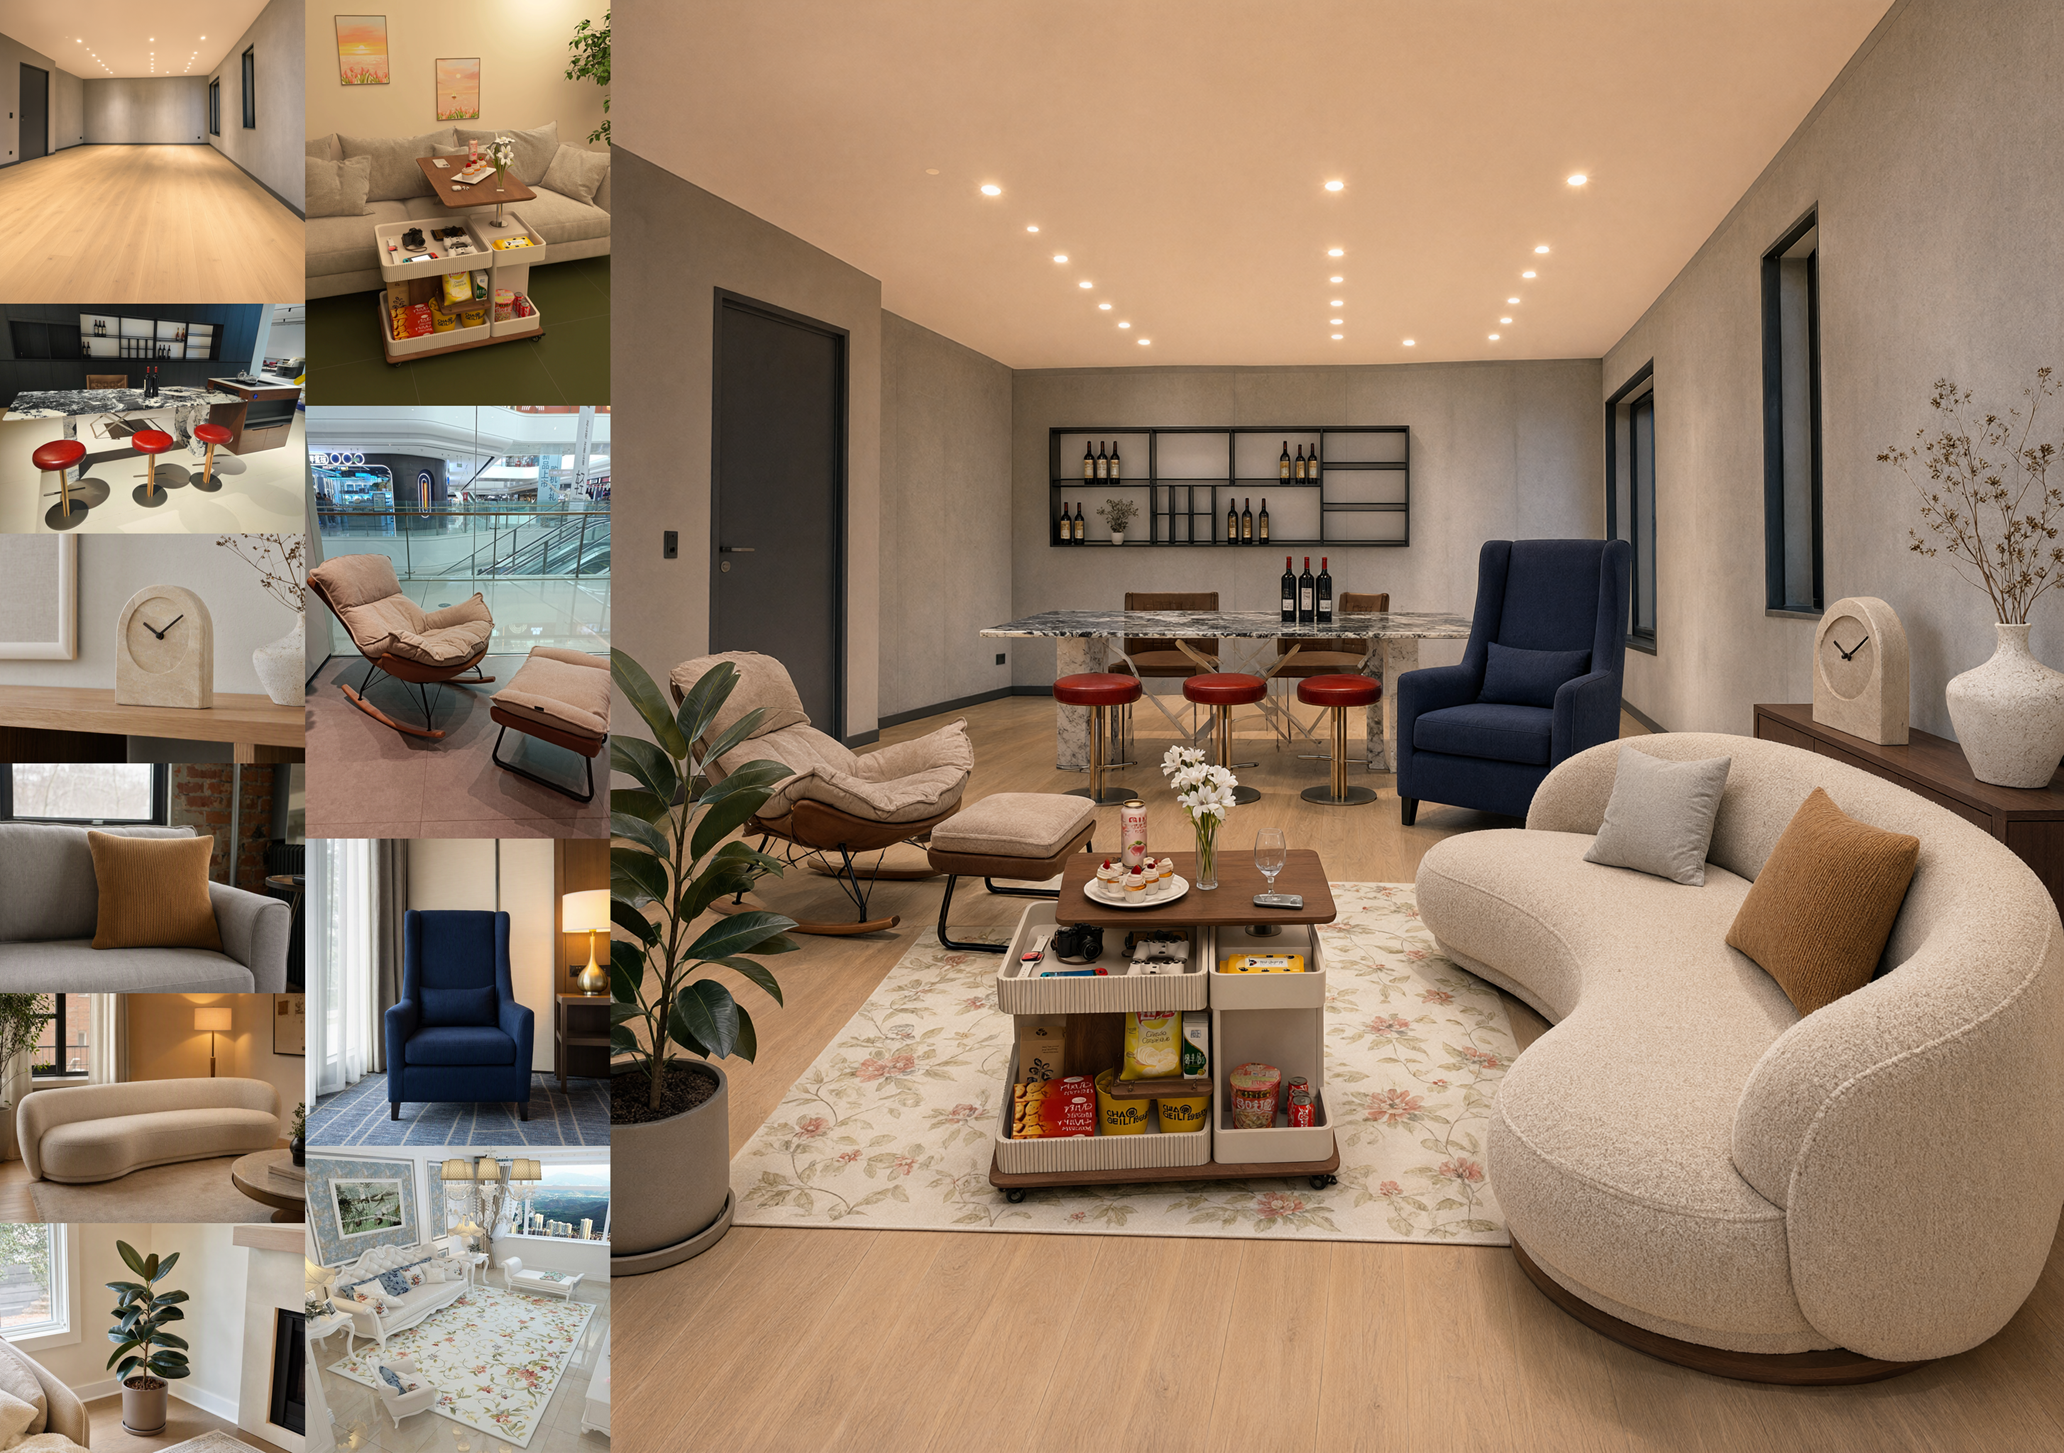
可以从不同图像中提取人物、衣服、鞋子、包、帽子、家具和商品等元素,并整合到同一个场景中。官方示例包括汇集 6 人面孔的合影、使用 5 种素材的虚拟试穿,以及利用 10 件家具完成的室内设计。不过,社区也报告称,参考图越多,越容易出现相互冲突的指令与属性混合。
4. 原生 RGBA 与透明背景
它不只是通过后处理移除背景,而是能直接生成包含透明通道的图像。适合从照片中抠出主体、编辑透明素材的形状,或制作包含多个元素的透明资产。
5. 局部编辑与蒙版编辑
可以通过圆圈、填色标注或独立蒙版来指定修改区域。在 ComfyUI 中,用户可以直接在图像上涂色,并尝试诸如“只修改红色区域的衣服”这样的指令。结合 LanPaint 时,除了颜色之外,还能对 Alpha 通道本身进行修补。
6. 扩图
可以向画布的上下左右扩展,并根据原图的上下文补绘空白区域。Reddit 上的一项热门报告指出,它可以一次扩展多个方向,速度也比以往的专用工作流更快。
7. 一致性保持
核心用途是保持人物面孔、服装、姿势,以及商品的形状和品牌元素,同时只更改背景或部分属性。它尤其适合角色设定表和连续镜头制作;但在极端角度、强烈表情和较长的连续序列中,仍需验证是否发生漂移。
8. 文字绘制与设计
支持海报、包装、招牌、排版等包含文字的图像。先通过外部 LLM 整理构图、信息层级、字号与留白,再交给模型生成的工作流颇受欢迎。不过,也有报告称英语信息图中会混入非预期的中文。
9. 提示词重写
官方仓库提供用于 T2I 和 I2I 的提示词重写器。它可将简短需求展开为详细构图,并在编辑时改写为“保持非修改区域不变”的指令。社区也反馈,在某些场景下,按用途定制的模板会优于标准重写。
10. 加速、省显存与量化
支持 Diffusers 的 CPU offload、vLLM-Omni 的 prefix KV cache、CUDA Graph、FP8、张量并行,以及 SGLang 的内存卸载和优化内核。面向 ComfyUI,也出现了 BF16、INT8 ConvRot、GGUF 和 4bit 系列衍生版本。有用户报告称 4 步 LoRA 可实现约两倍速度,也有自定义节点可在 8GB VRAM 上运行提示词扩展;不过,务必确认速度与质量之间的取舍。
11. 支持环境
官方列出了官方实现、Hugging Face Diffusers、ComfyUI、vLLM-Omni、SGLang-Diffusion、LightX2V 和 ModelScope。还介绍了面向 AMD Radeon 的 ROCm 示例,以及经由 FlagOS 支持多种芯片的方案。
12. 许可证注意事项
模型权重虽然公开,但并非采用 Apache 2.0,而是以「Qwen Research License Agreement」提供。官方许可证明确写明,商业使用需要另行取得商业许可证。它还包含再分发时的通知义务,以及在衍生 AI 模型文档中标注“Built with Qwen”或“Improved using Qwen”等要求。请务必在业务部署前核对原文。
来源:官方许可证
从官方案例看 50 个视角
这里以 Qwen 团队公开的 Qwen-Image 2.1 官方样例为主,并对应 Reddit 上讨论尤其热烈的议题,列出 50 个案例。内容不只包含“漂亮的单张成图”,还包括输入图、编辑结果、蒙版、多参考图、相机变换和资料生成,以便观察模型能在创作流程的哪些环节发挥作用。
透明素材与插画生成
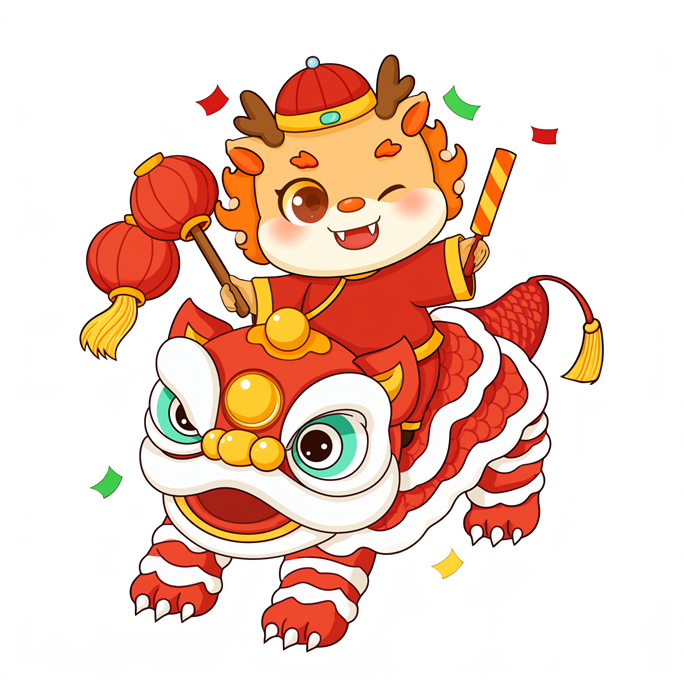
案例 1:舞狮主题的透明插画。 同时处理轮廓细密的装饰与 Alpha 背景的示例。
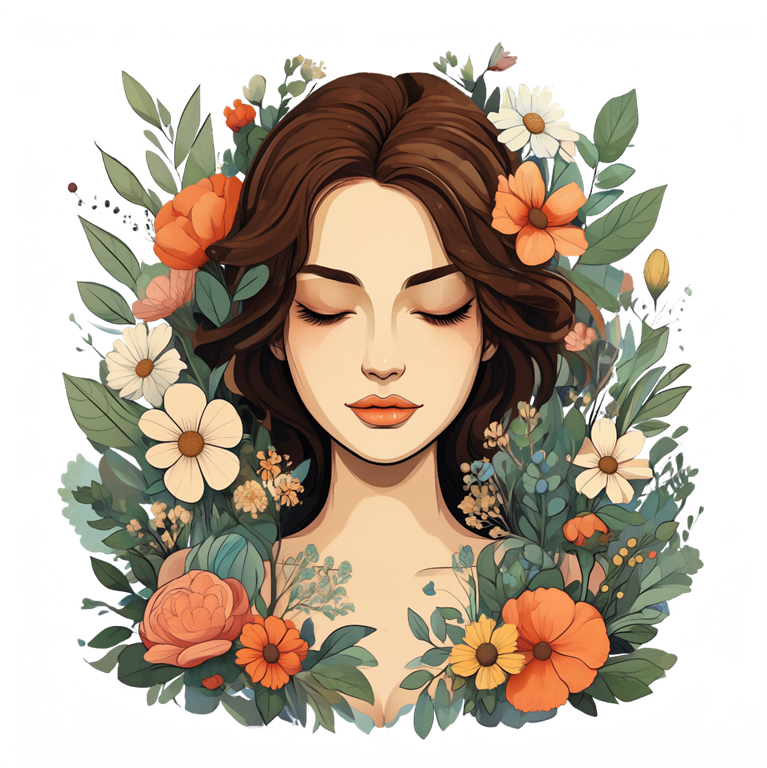
案例 2:被花朵环绕的女性装饰插画。 包含头发、花瓣和叶片的复杂边界。
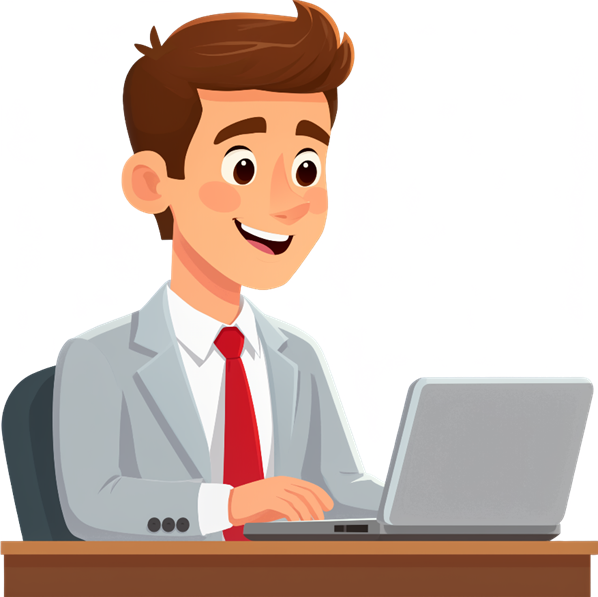
案例 3:使用笔记本电脑的商务人物。 面向网页或演示材料的剪贴插画。
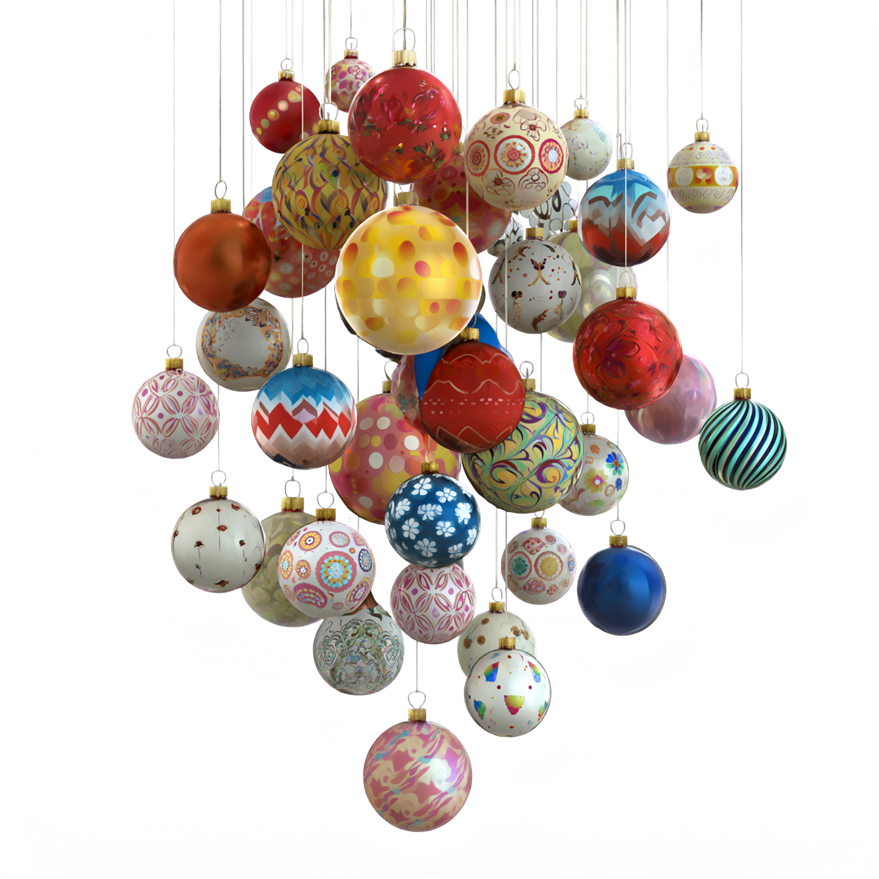
案例 4:多个悬挂装饰。 将半透明感、细线和不同材质感整合进一张图像。
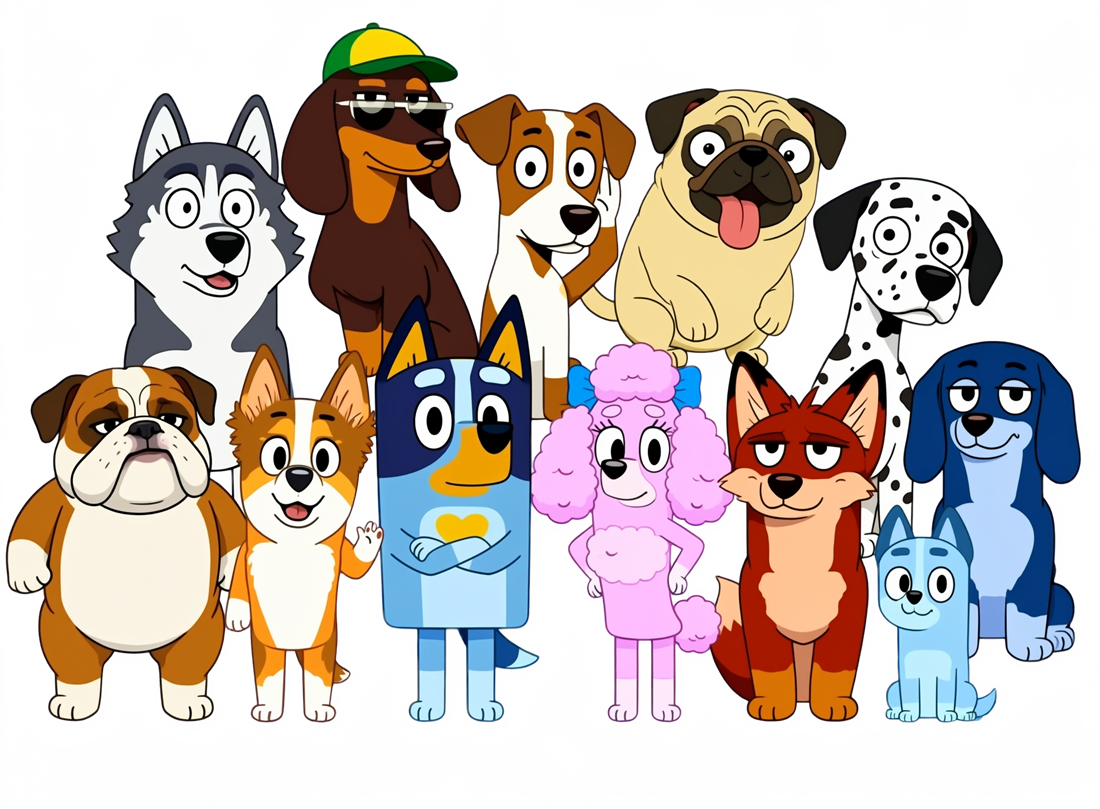
案例 5:大量狗狗角色。 展示多个主体的区分绘制与群像构图。
图像编辑与文字替换
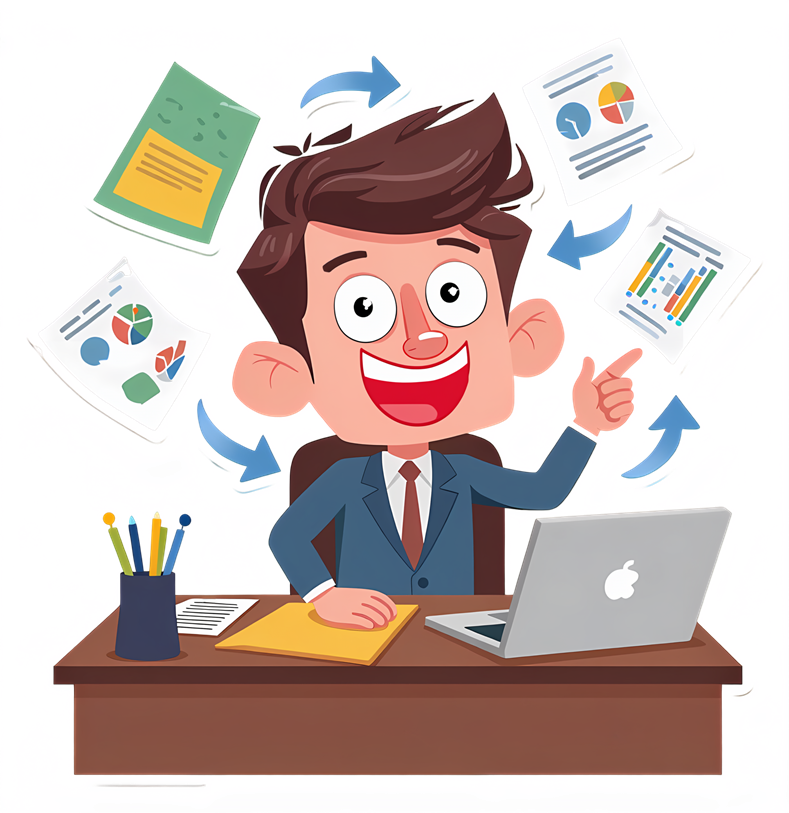
案例 6:疲惫上班族的原图。 用作与下一项编辑结果对比的条件图像。
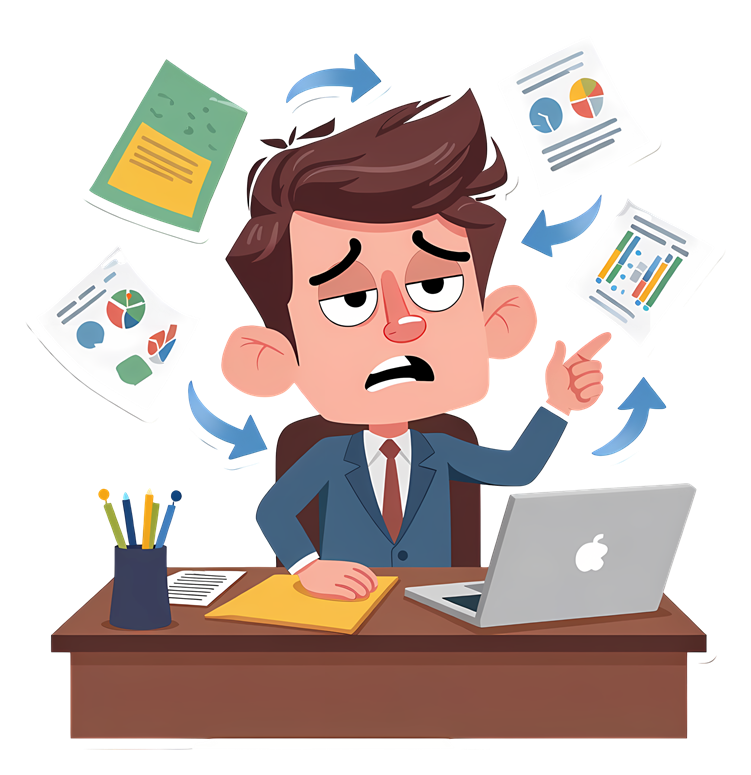
案例 7:改变表情和氛围后的上班族。 在保持布局的同时改变人物情绪。
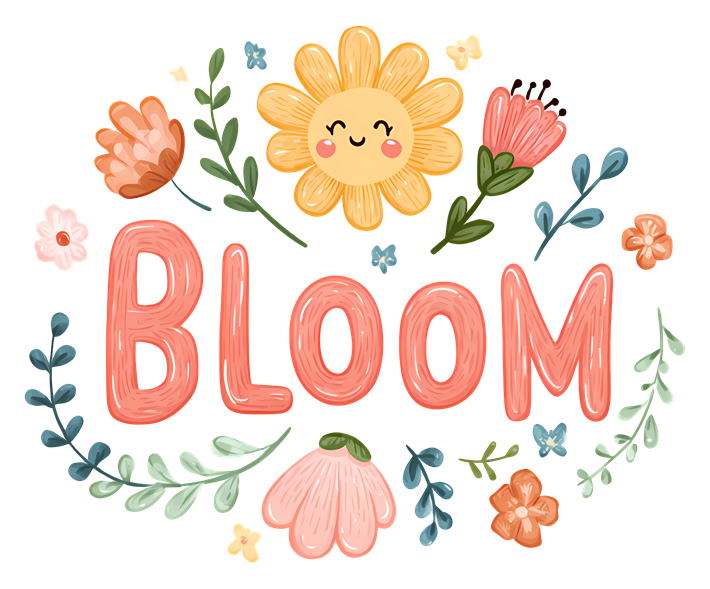
案例 8:「BLOOM」花卉文字。 文字、装饰与居中布局的基准示例。
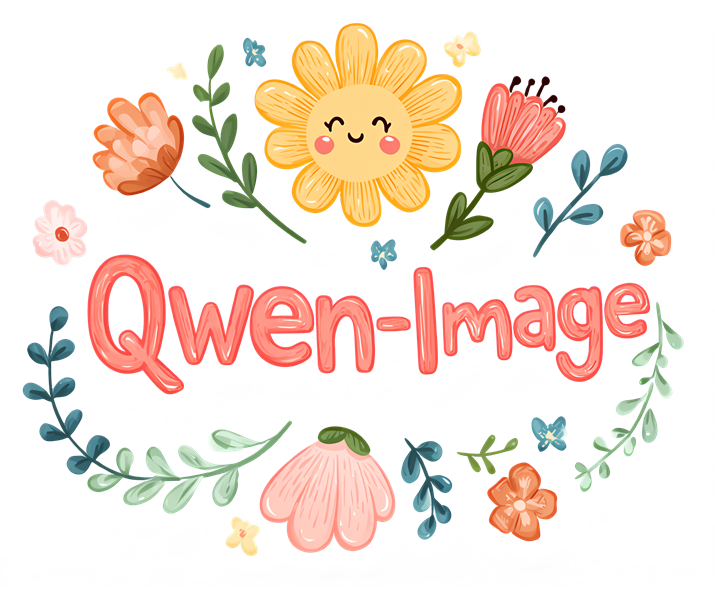
案例 9:替换为「Qwen-Image」的文字。 保持花卉风格的排版编辑。
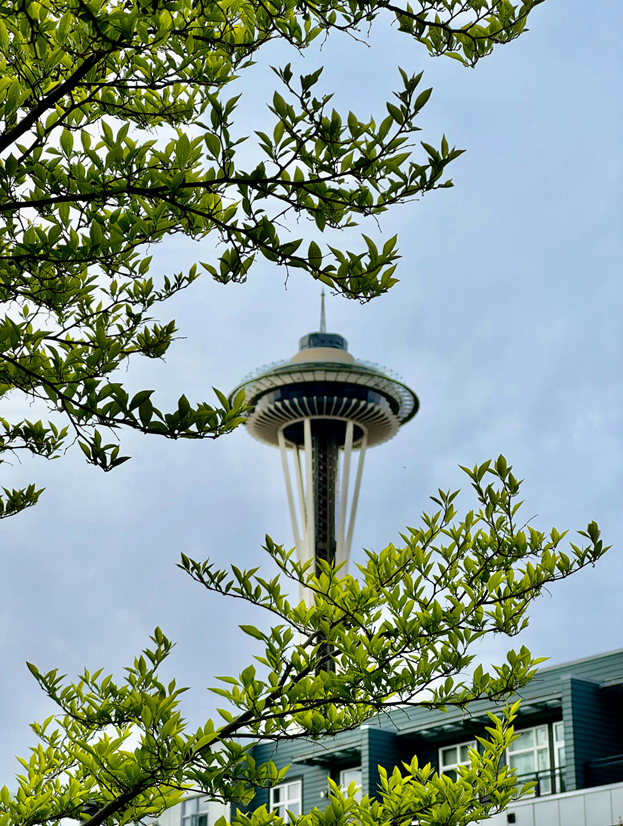
案例 10:白天的塔楼照片。 用于时间与背景编辑的输入示例。
背景、时间与多人场景
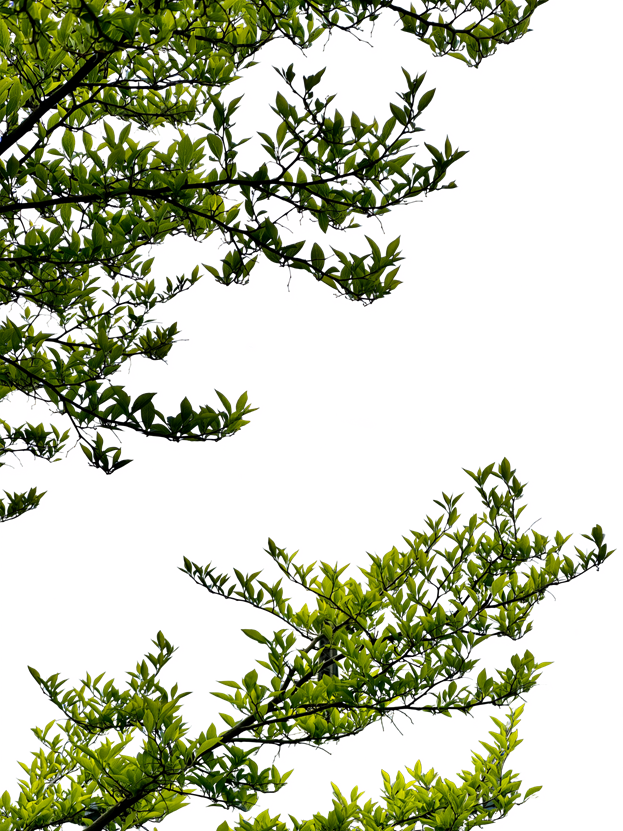
案例 11:夜晚的花树。 展示从日间照片转换为夜景和不同氛围的编辑能力。
案例 12:从多张人物参考图生成合影。 展示最多 10 张参考图这一核心能力。
案例 13:利用服装与人物的多参考图完成搭配。 接近虚拟试穿的思路。
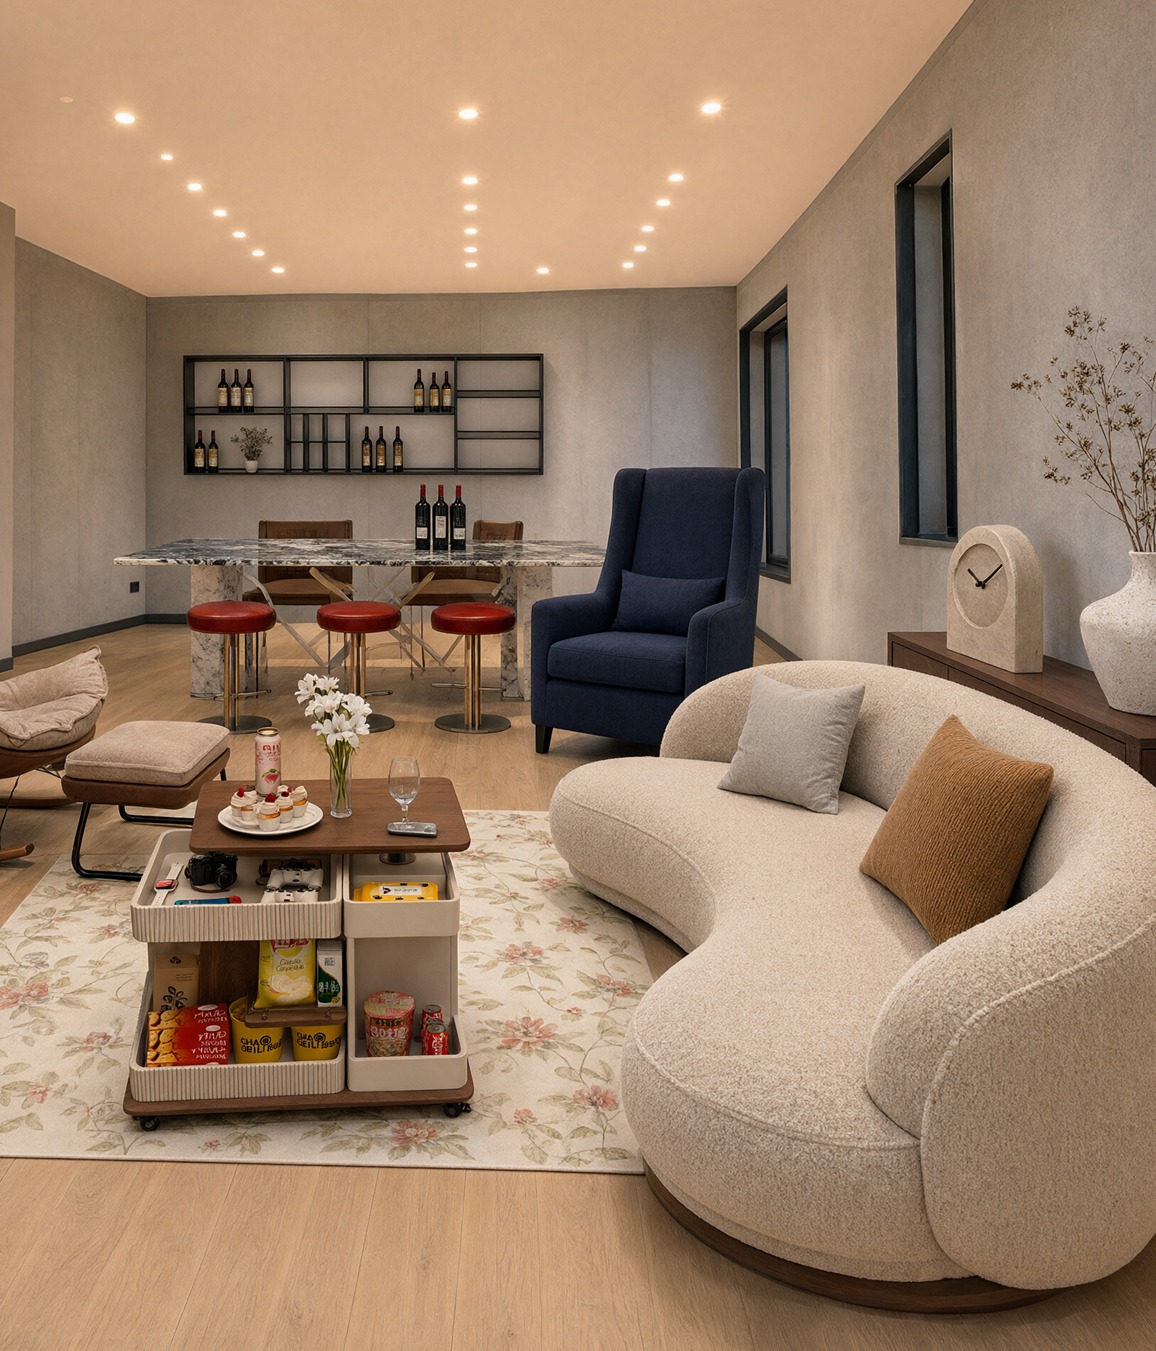
案例 14:由大量家具图像构成室内空间。 将商品目录中的家具布置进房间的用途。
案例 15:在猫周围用颜色绘制指示。 通过涂绘标注进行局部指定的输入。
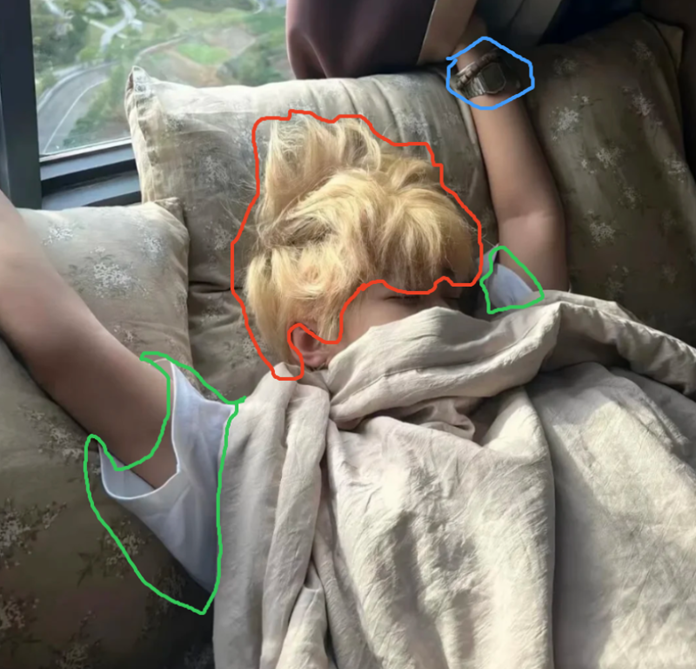
局部编辑、蒙版与合成
案例 16:仅修改指定区域中的猫。 在保留床具和人物的同时替换主体。
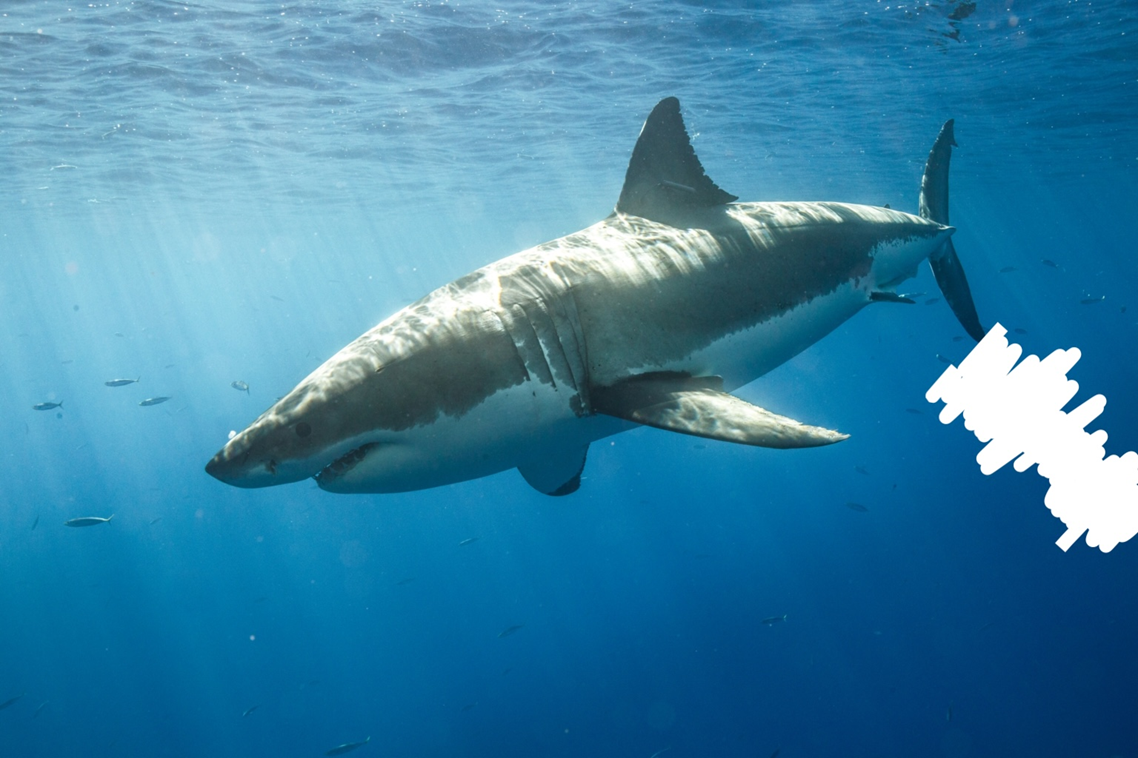
案例 17:水下鲨鱼与局部指示。 直接在目标物上绘制的编辑输入。
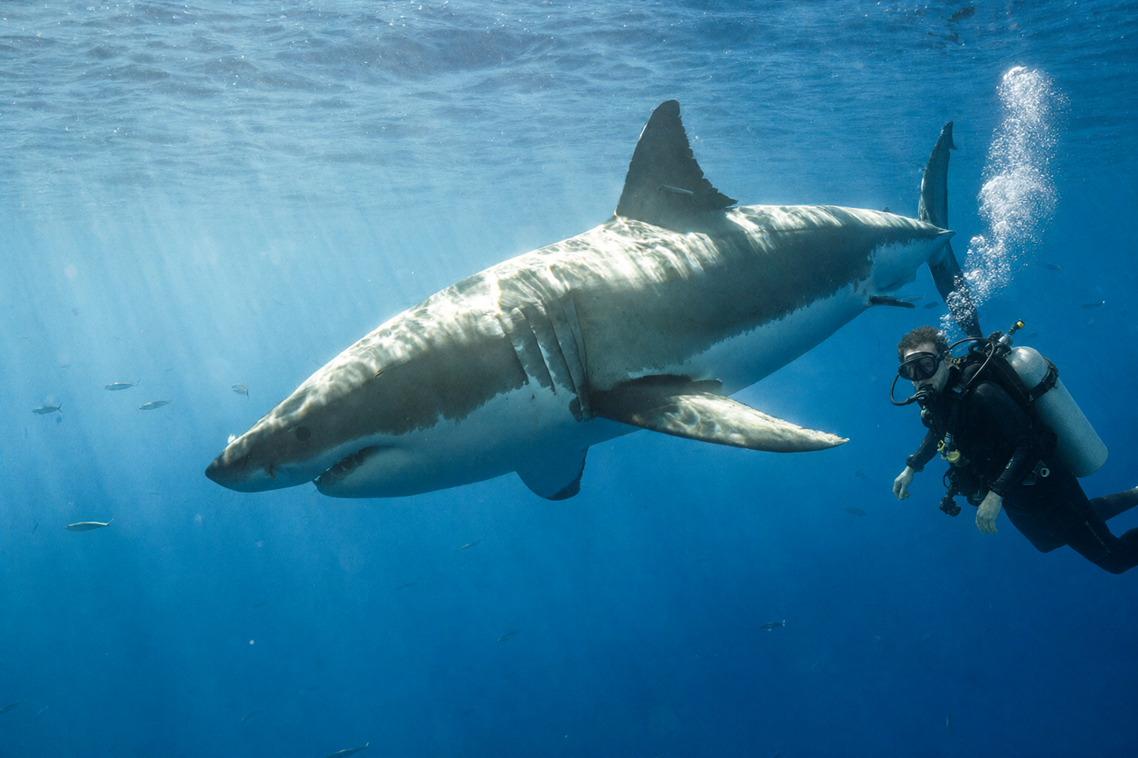
案例 18:添加潜水员后的水下场景。 使水下光线和尺度相匹配的合成效果。
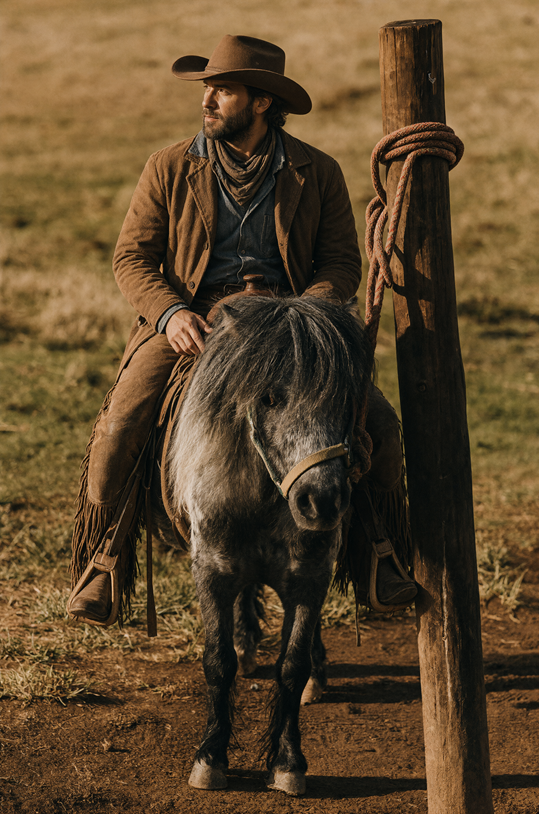
案例 19:骑在驴上的人物原图。 作为蒙版编辑基准的照片。
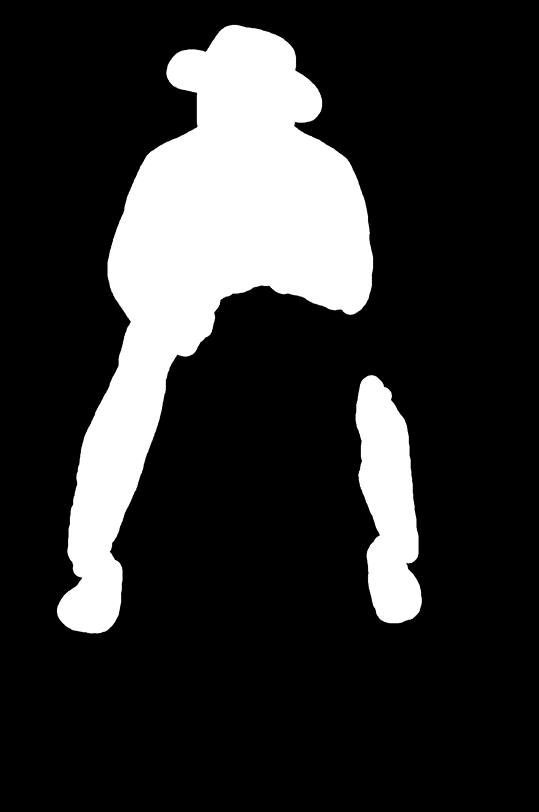
案例 20:标示人物与驴的蒙版。 以黑白明确标示修改区域的另一种方式。
人物重构与人脸保持
案例 21:使用蒙版进行人物编辑的结果。 也可对比其与草原背景的一致性。
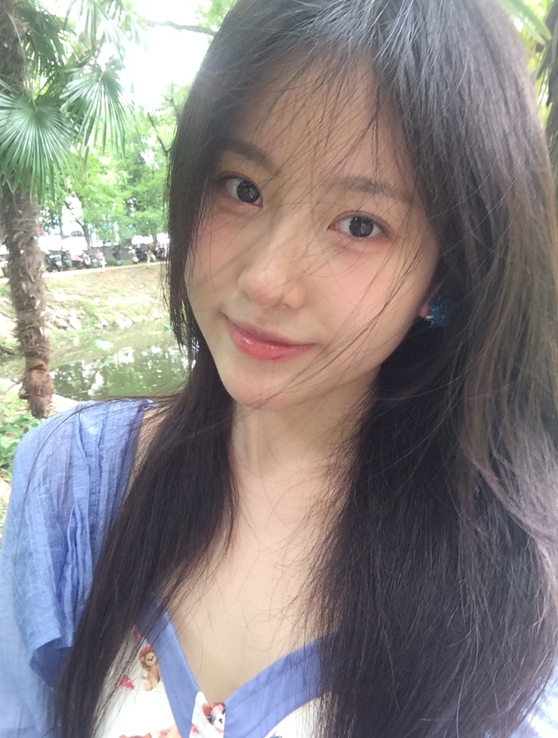
案例 22:用于人脸参考的人像。 用作下一项全身图和新环境生成的基准图像。
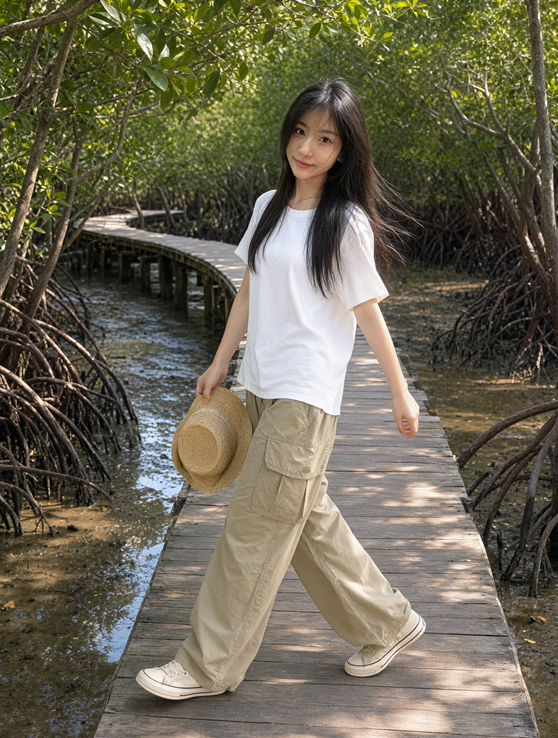
案例 23:将参考人物扩展为户外全身照。 将脸部与服装迁移到新的构图中。
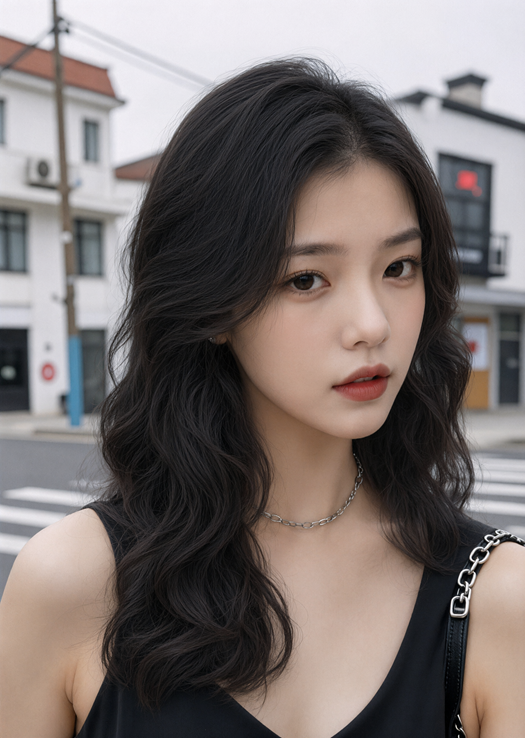
案例 24:接近正面的脸部照片。 用作发型编辑的输入条件。
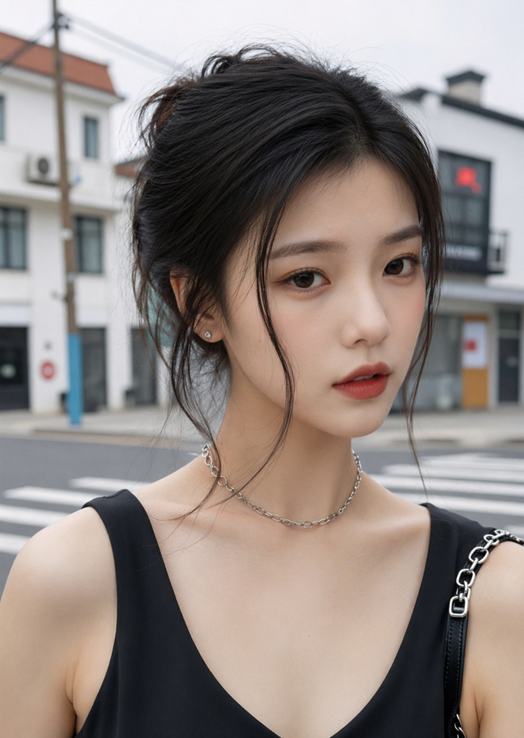
案例 25:修改发型后的脸部照片。 保持五官和背景,仅将头发变长。
姿势、场景与商品照片
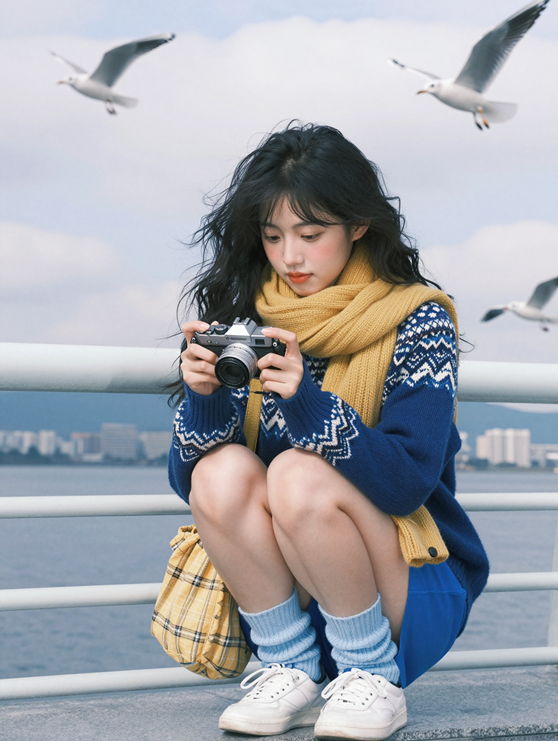
案例 26:在港口蹲着的人物。 包含复杂姿势、小物件与远景的示例。
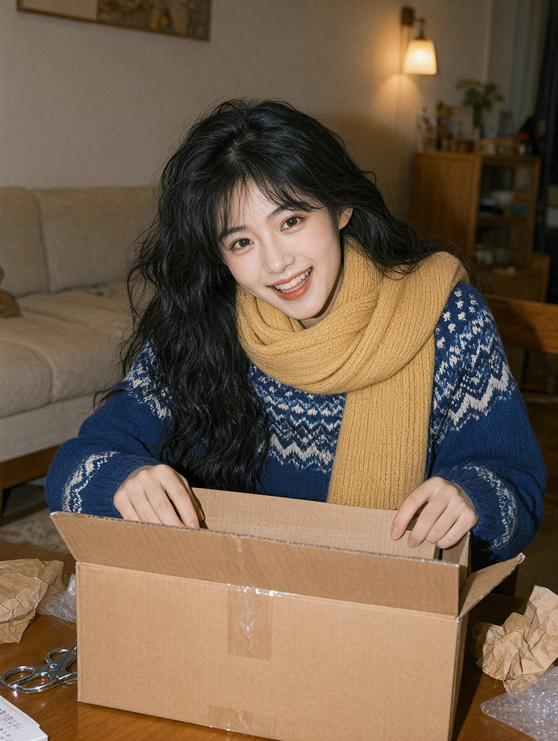
案例 27:在室内打开纸箱的人物。 用于观察手指、纸箱和身体重叠关系的构图。
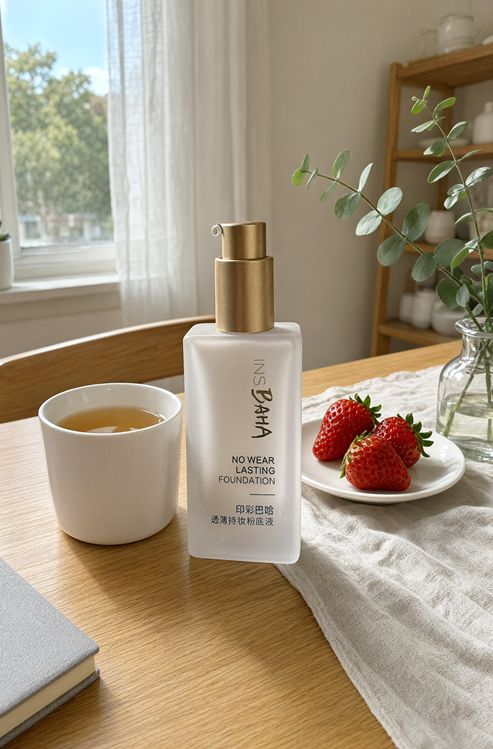
案例 28:手持化妆品。 包含标签文字与手指接触的商品照片。
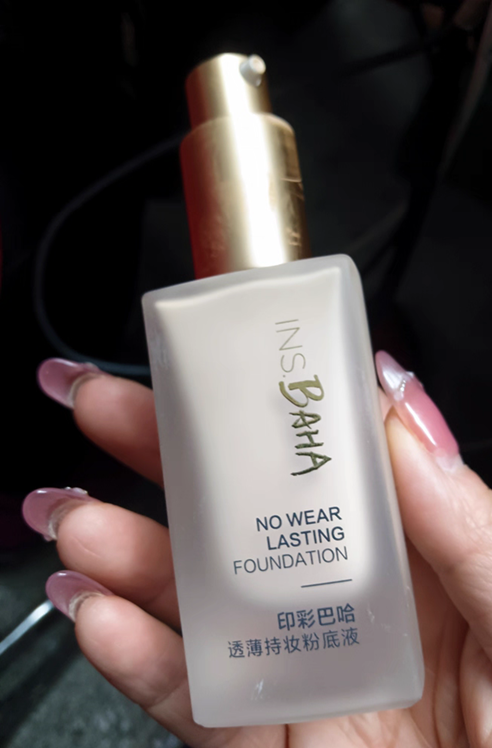
案例 29:将化妆品改为室内商品图。 添加自然光、桌面与食品小物件。
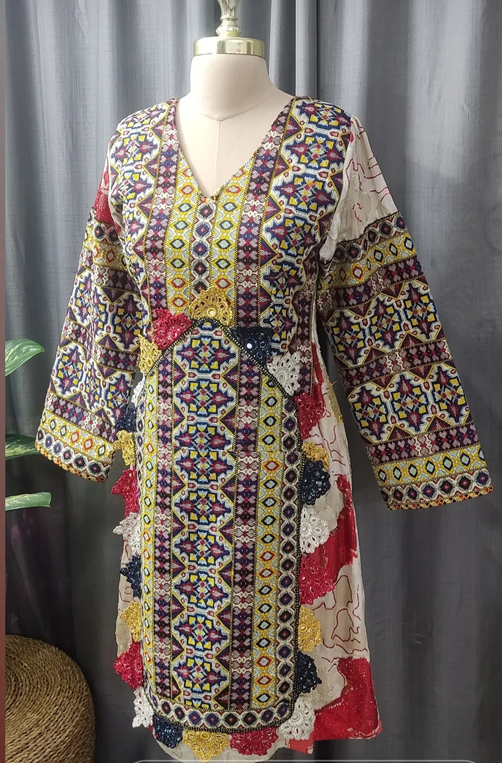
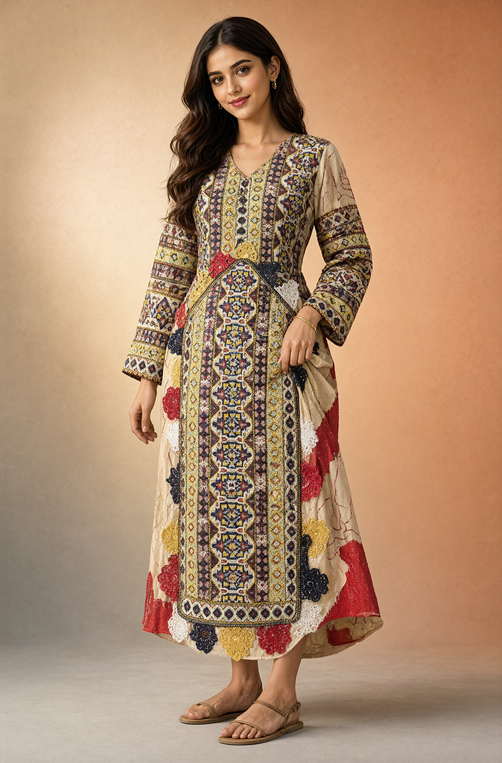
案例 30:穿在模特假人上的衣服。 用于下一项人物试穿生成的商品参考图。
虚拟试穿与佩戴合成
案例 31:将参考服装穿到人物身上。 将图案、长度和轮廓适配到人体。
案例 32:单独拍摄的手链商品图。 佩戴合成的条件图像。
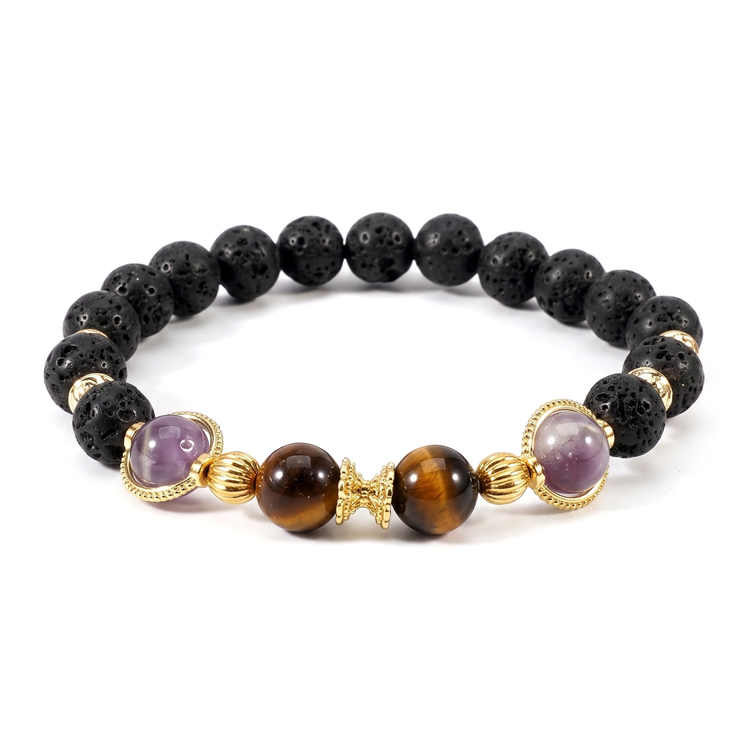
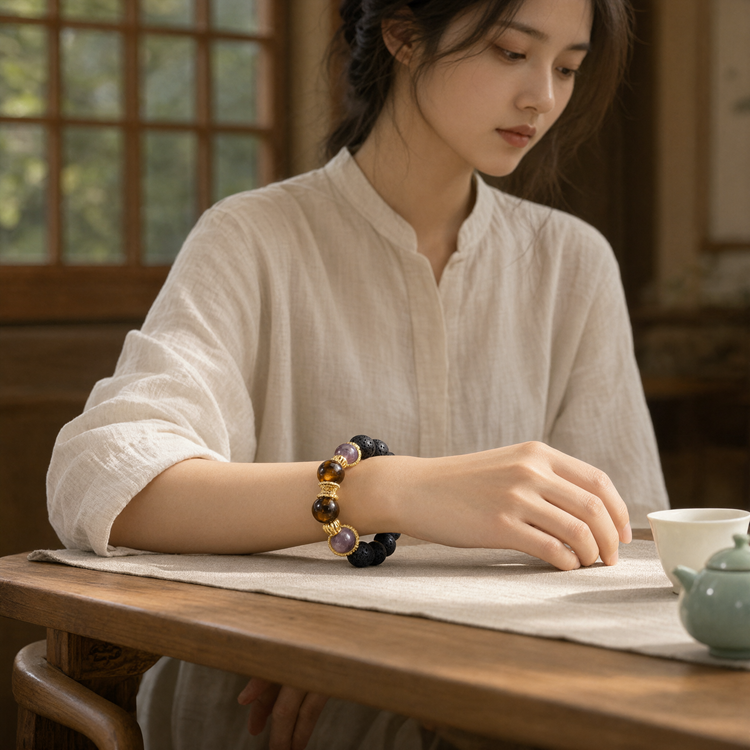
案例 33:将手链佩戴到人物手腕上。 自然匹配与皮肤的接触和阴影。
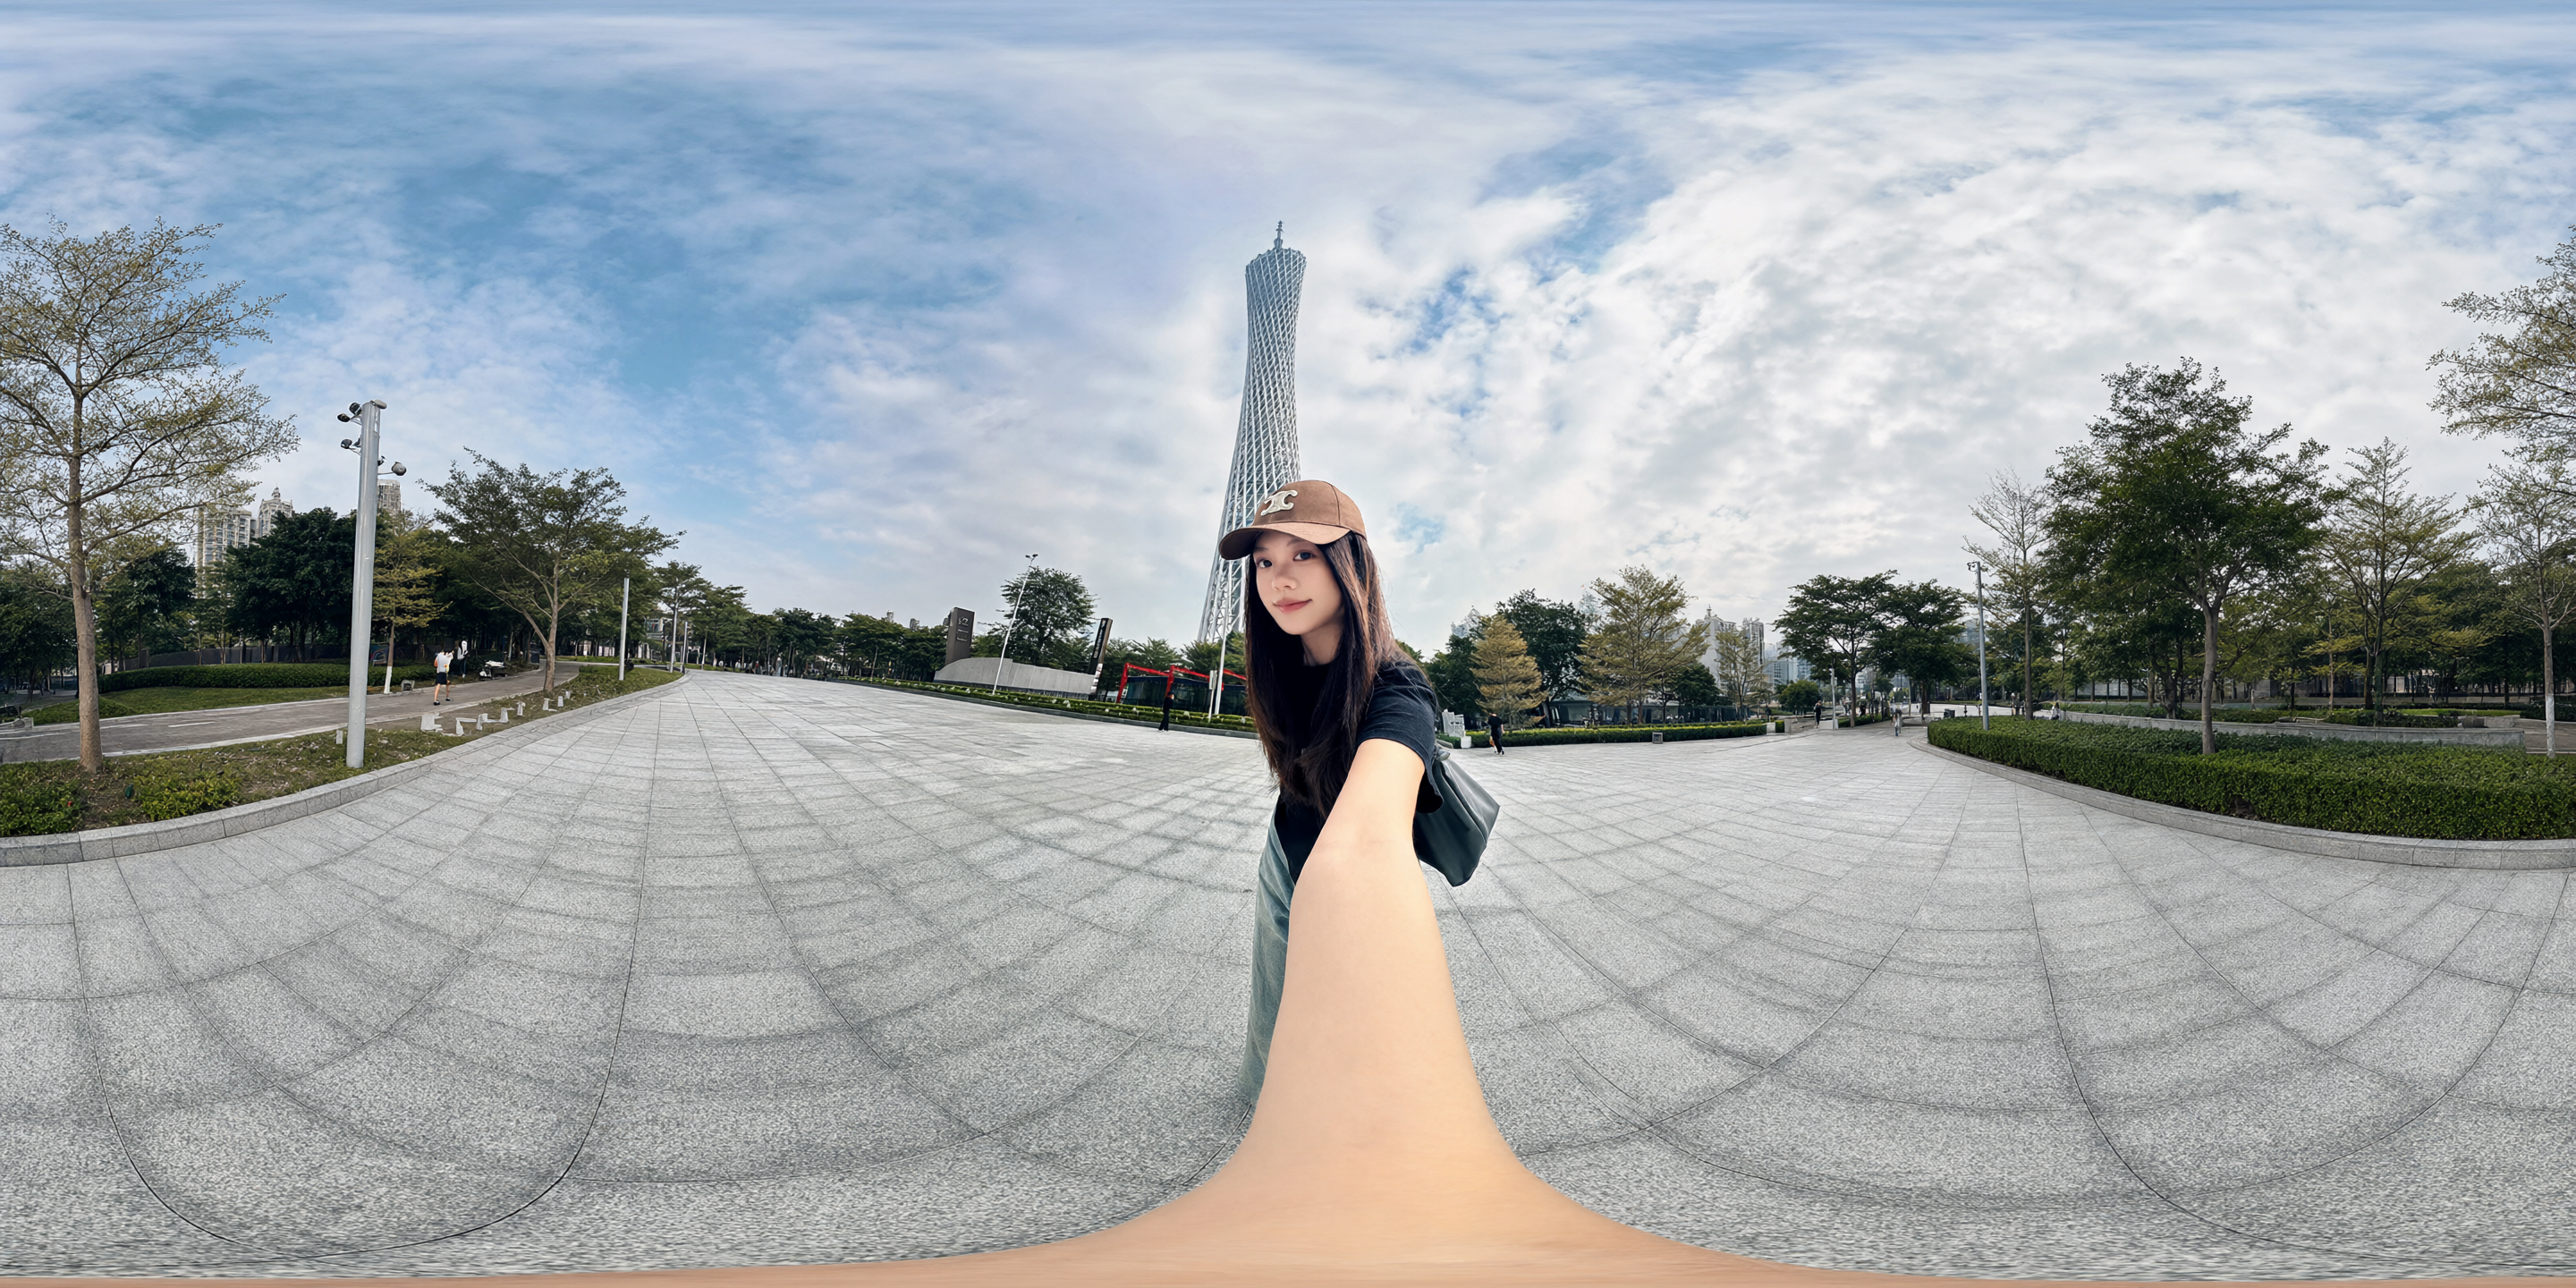
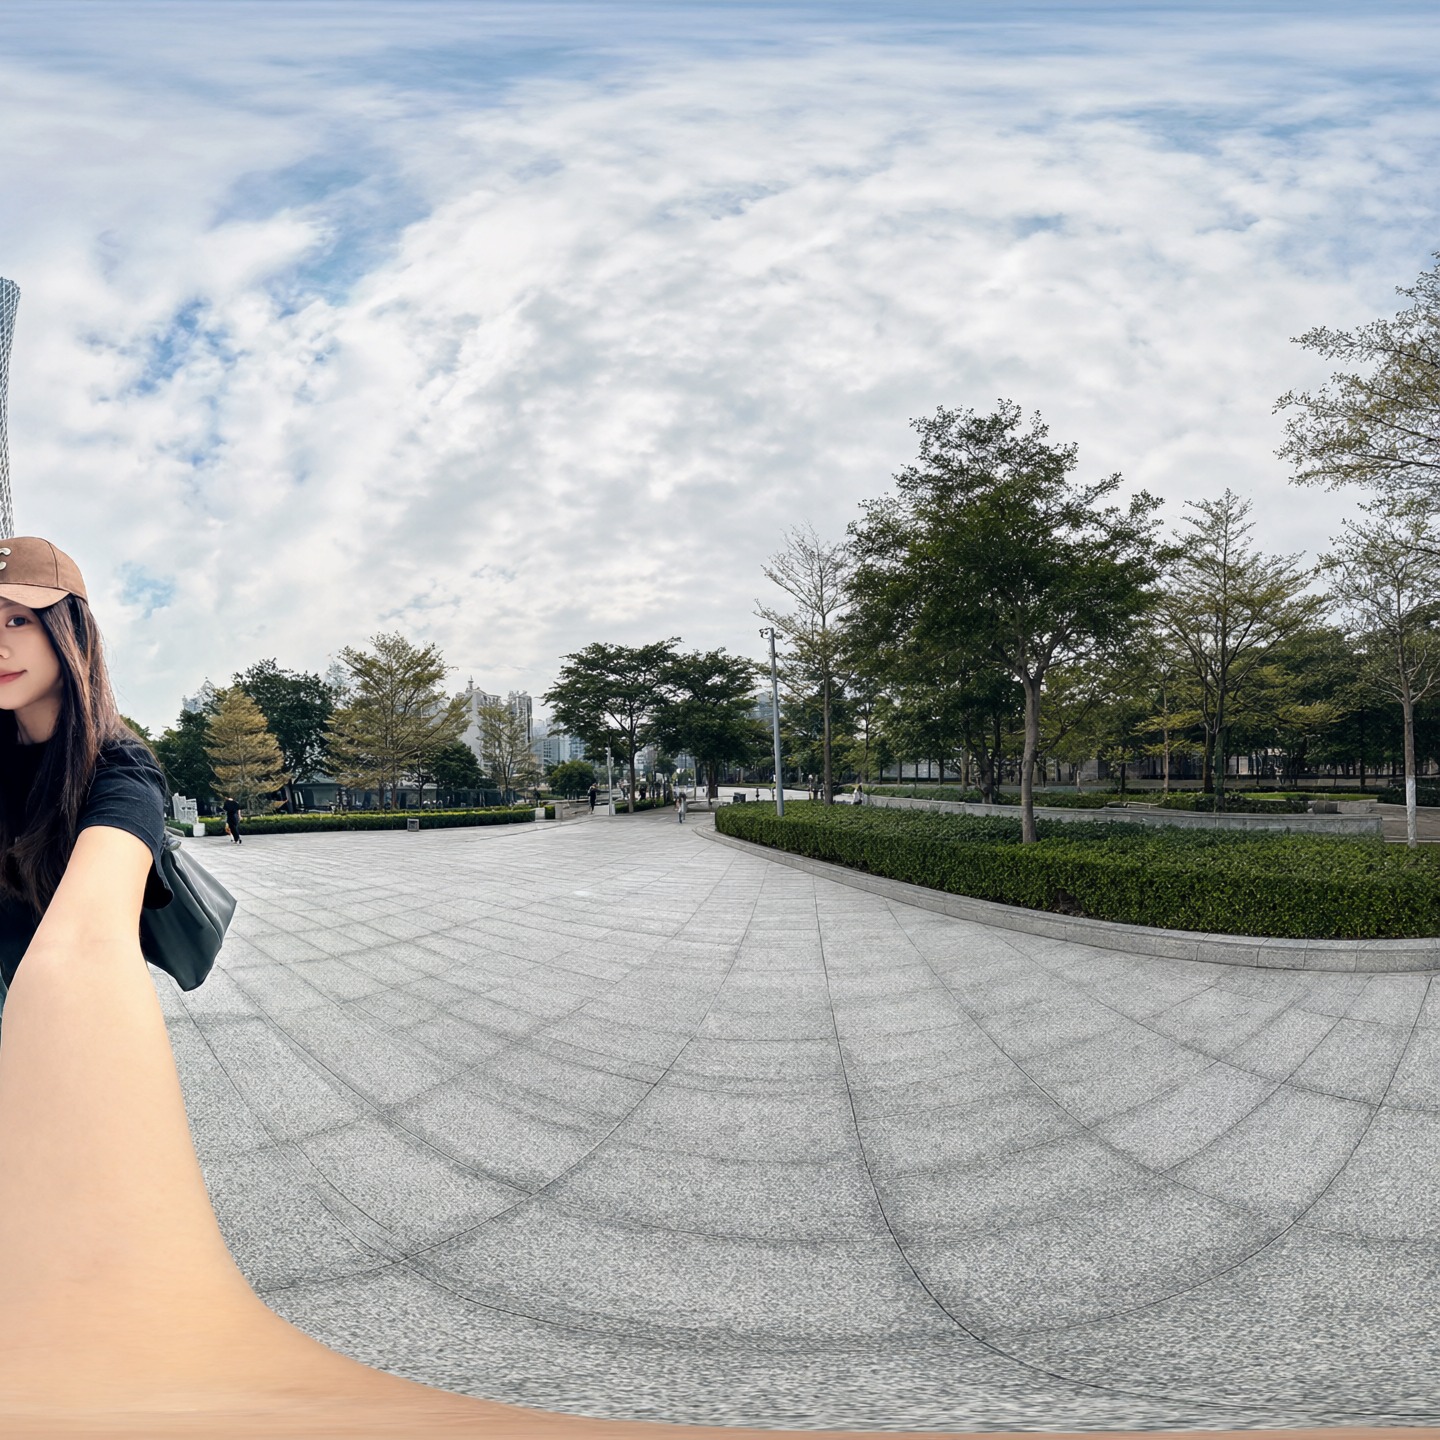
案例 34:塔楼前的自拍。 用于变换视角的输入照片。
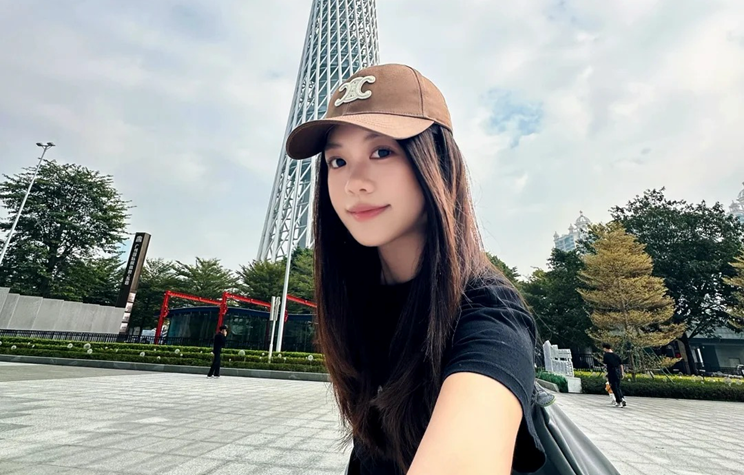
案例 35:从自拍转换为第三人称视角。 在更宽画角中重构同一人物和地点。
角色设定表与连续性
案例 36:身穿白色服装的人物人像。 作为角色设定资料的输入。
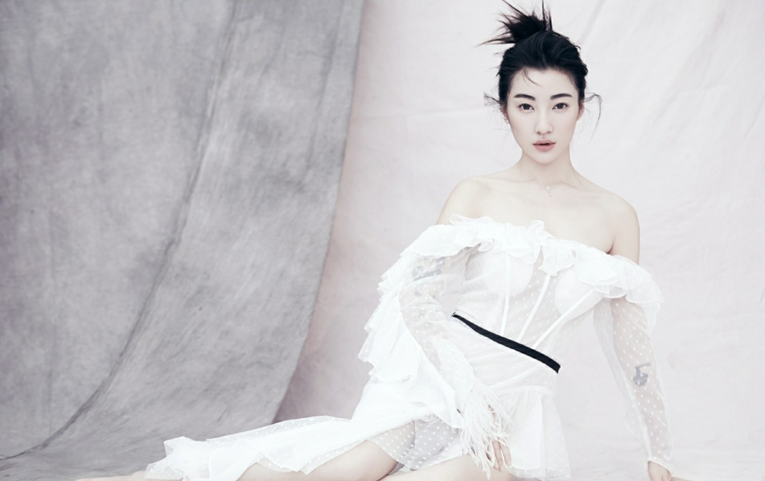
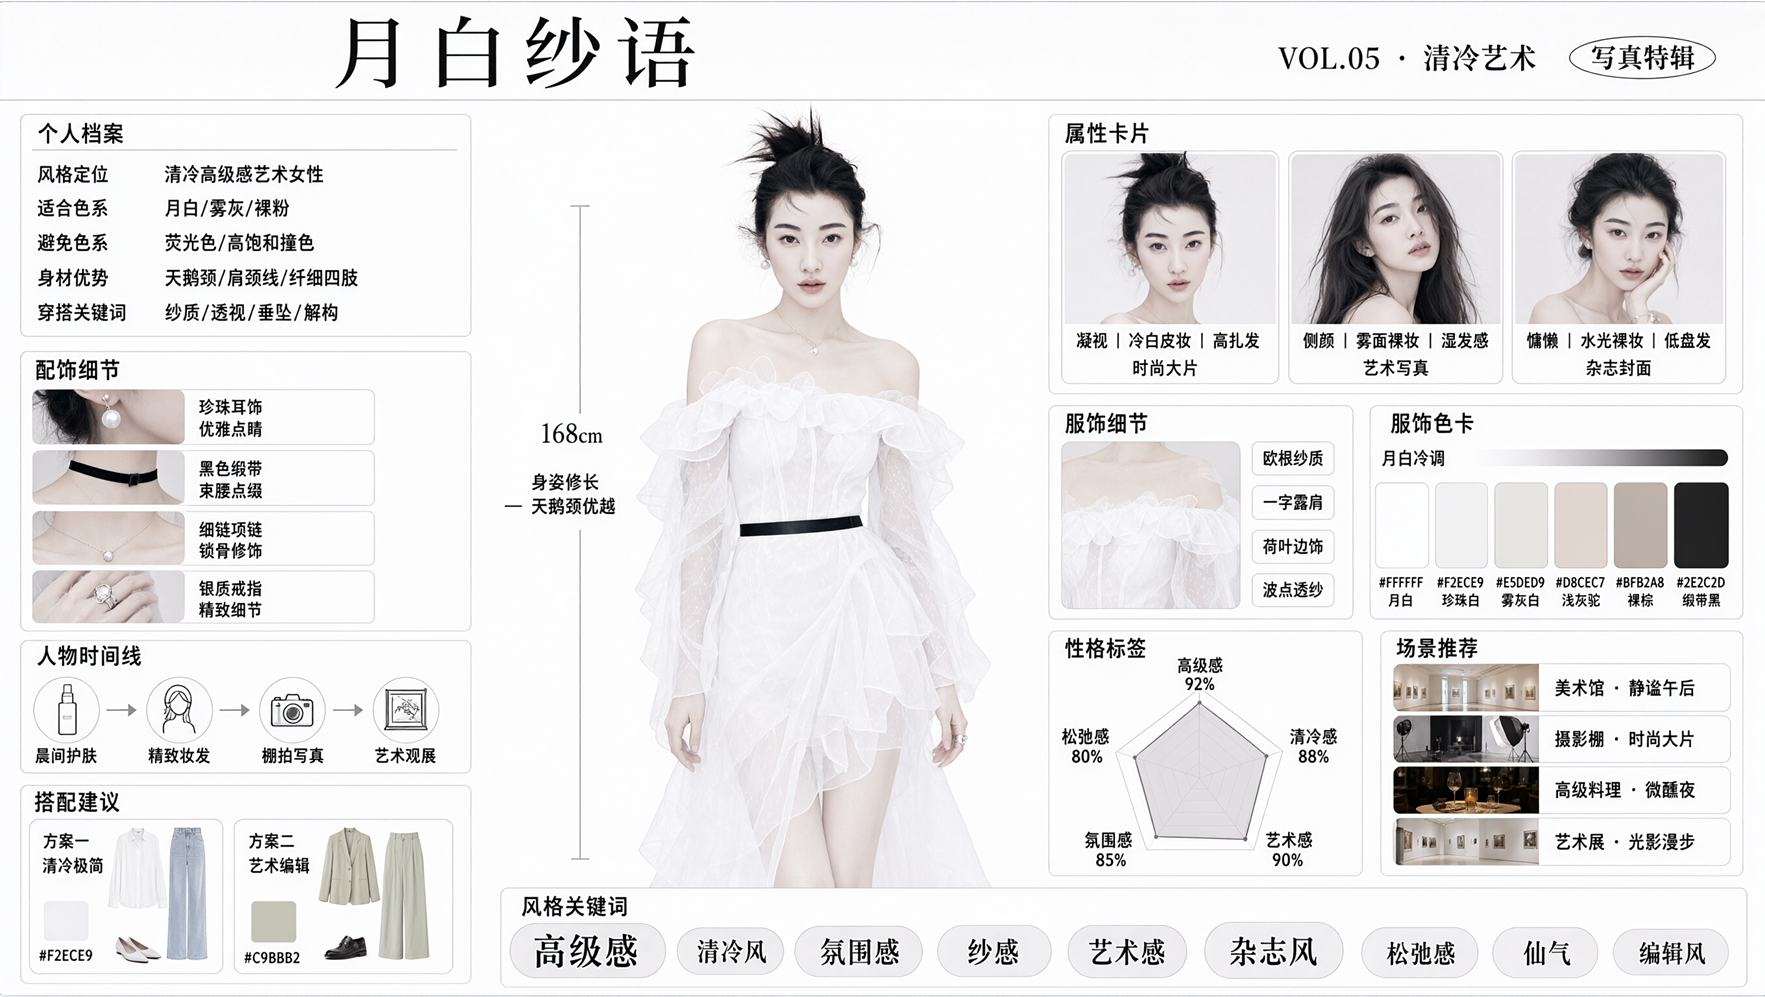
案例 37:将人物设定汇集到一张设计表中。 整合脸部、服装、小物件与文字信息。
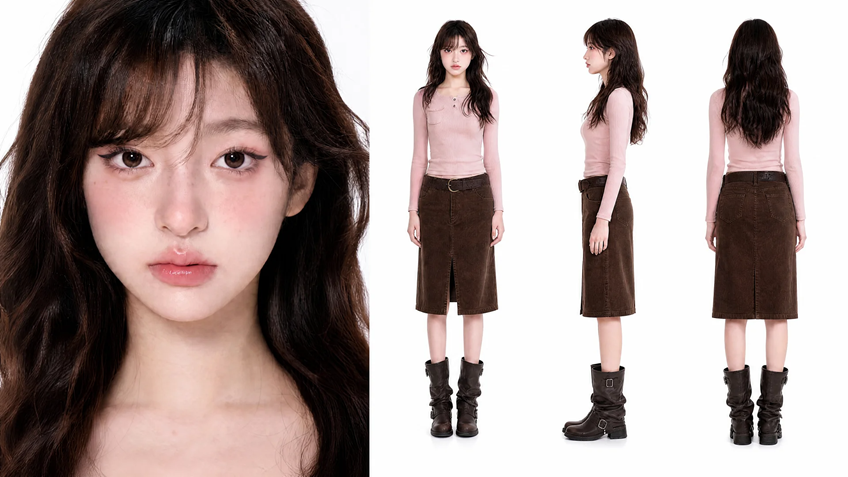
案例 38:包含正面、侧面与背面的角色设定表。 适合作为视频或漫画的参考素材。
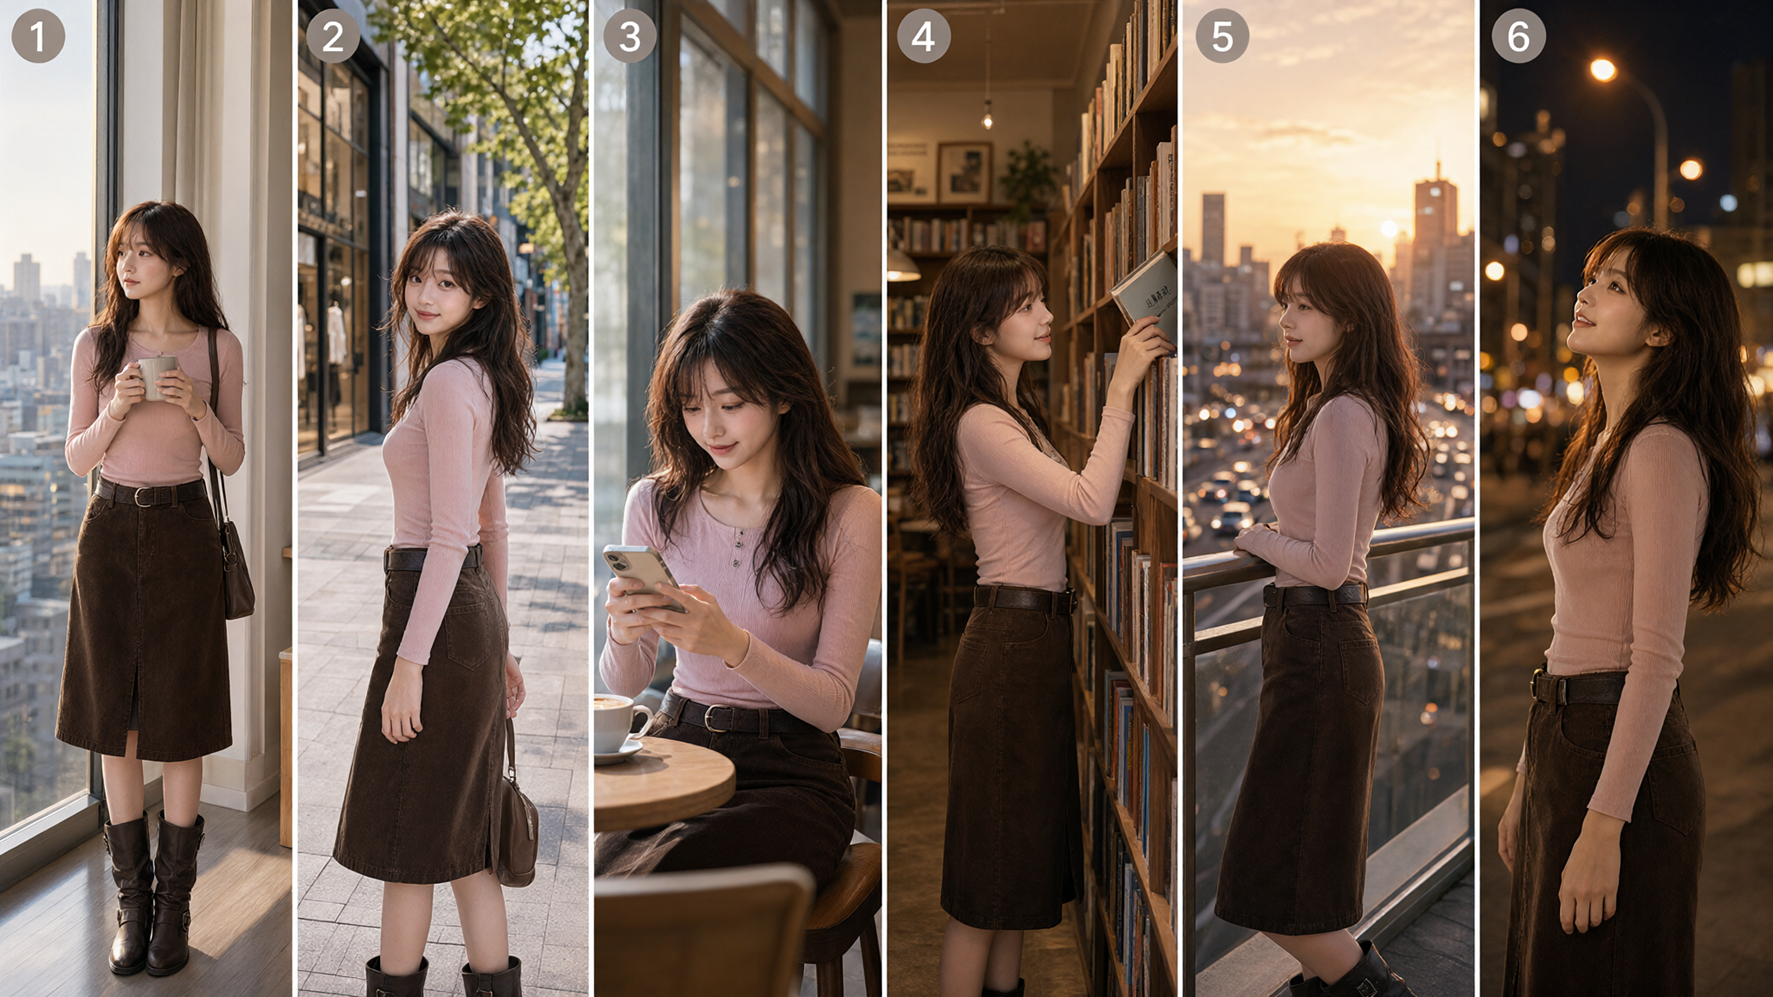
案例 39:将同一人物置于多个场景中。 观察改变姿势与地点时,脸部和服装的保持情况。
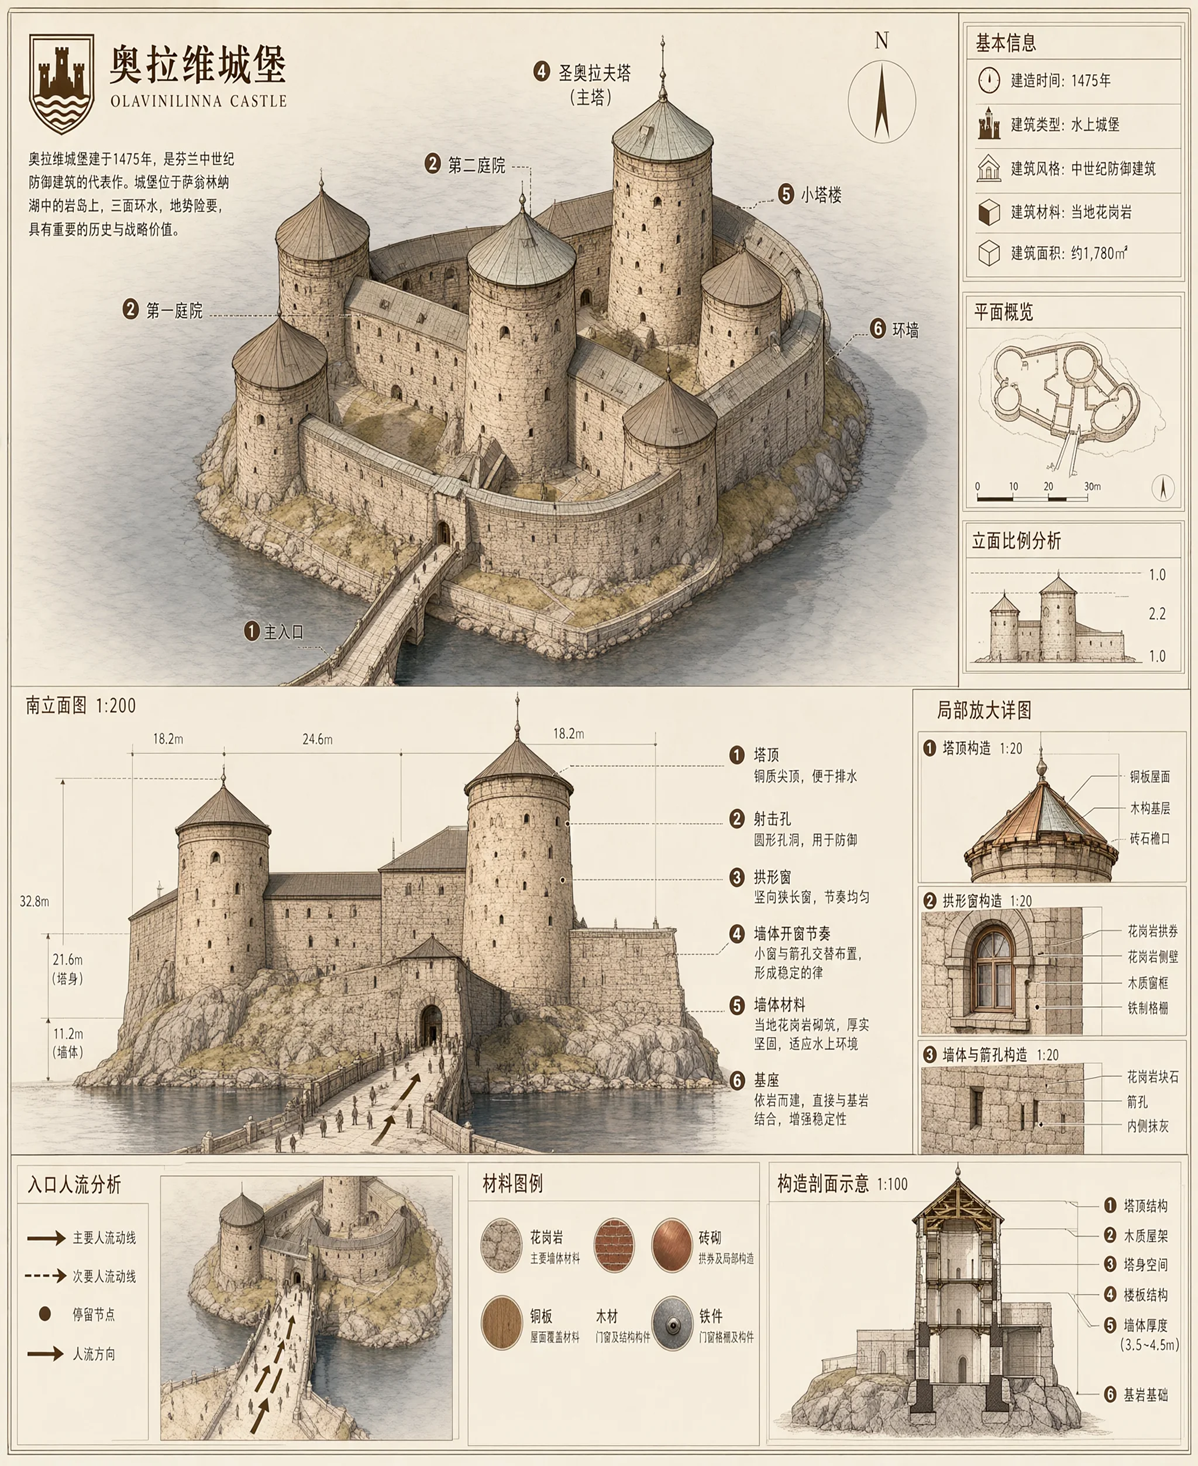
案例 40:建筑说明图。 将文字、图纸、材质样本和注释整合到一张资料图中。
UI、文档与自然人物照片
案例 41:旅行预订应用 UI。 包含小字号文字、卡片、图片和按钮的界面设计。
案例 42:包含几何题的文档。 用于观察含长文本和图形页面的生成难度。
案例 43:户外自然光人像。 展示帽子、头发与树影斑驳光线。
案例 44:码头人物照片。 包含绳索、船只、工具等细致背景的写实示例。
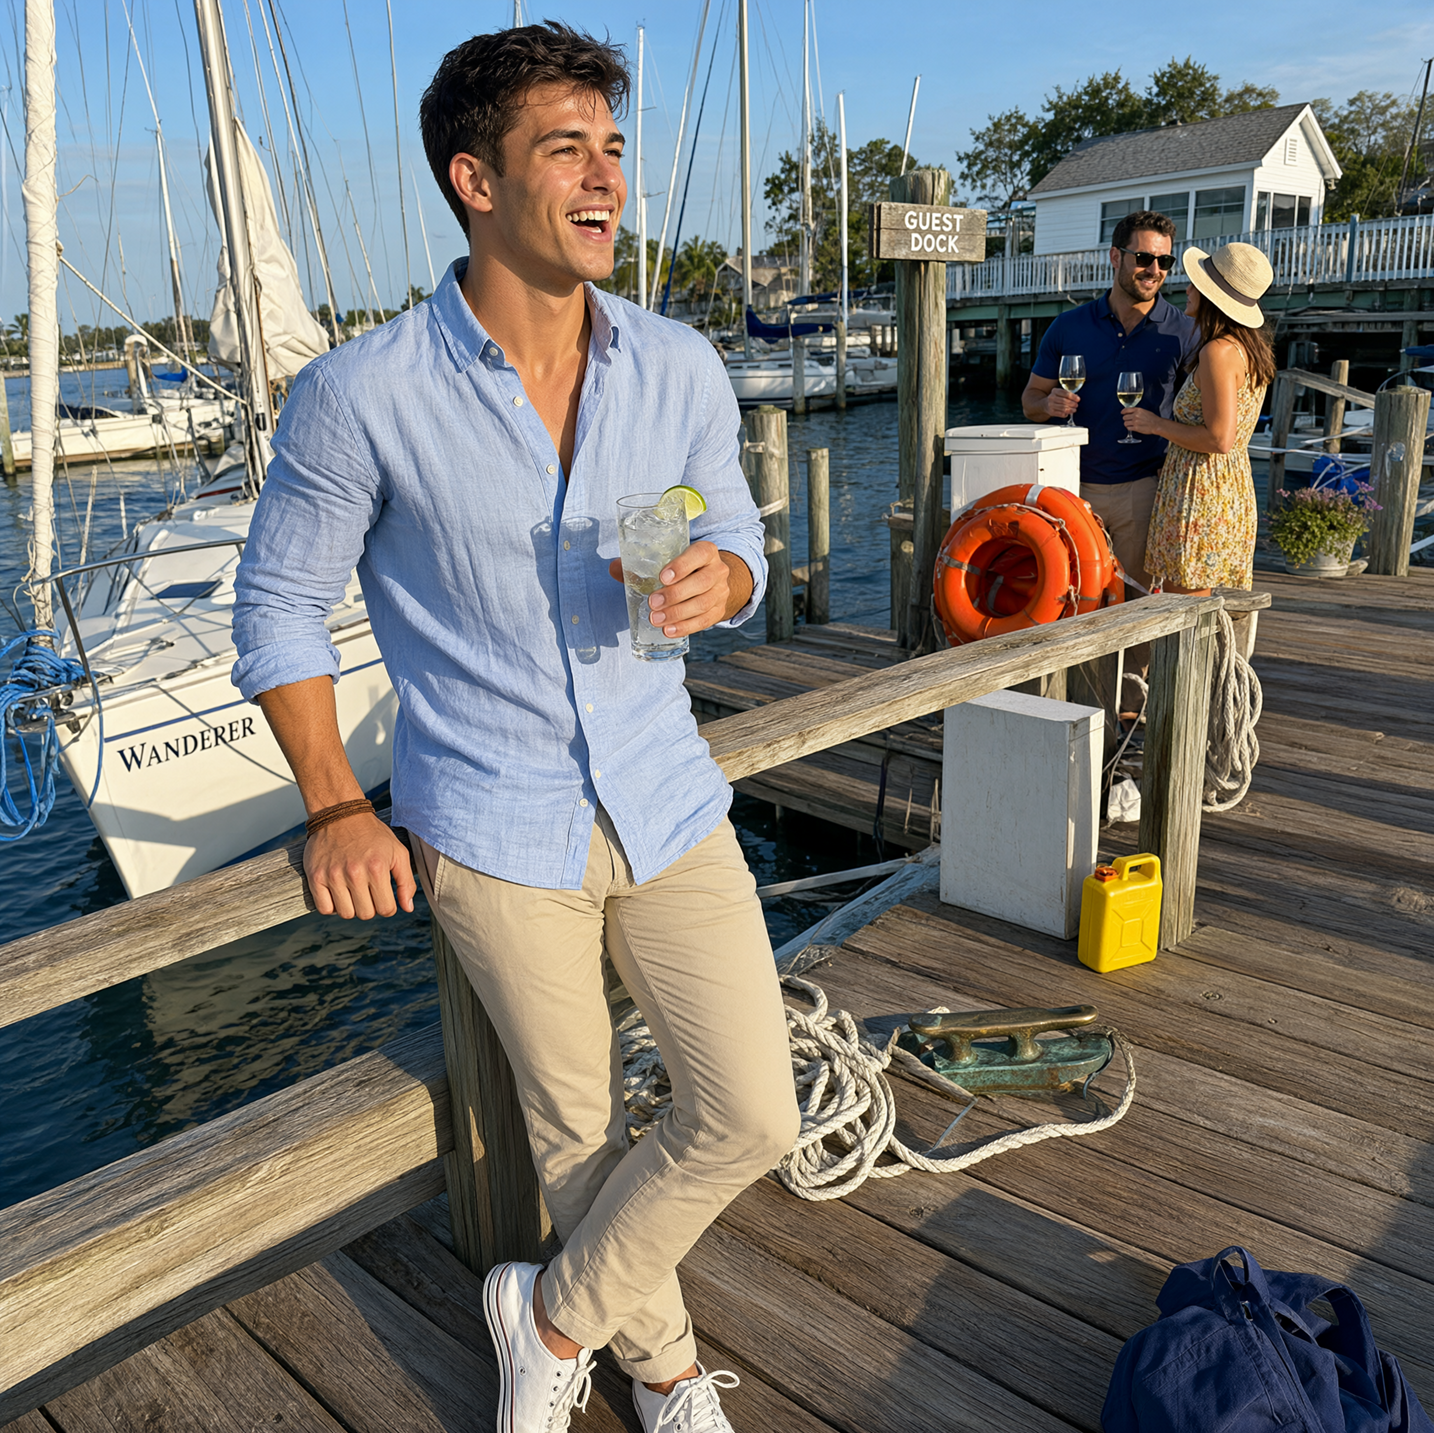
便于比较的放大图与其他视角
案例 45:合影结果局部放大。 用于确认将多张参考图整合到同一空间时的人脸、姿势和光照。
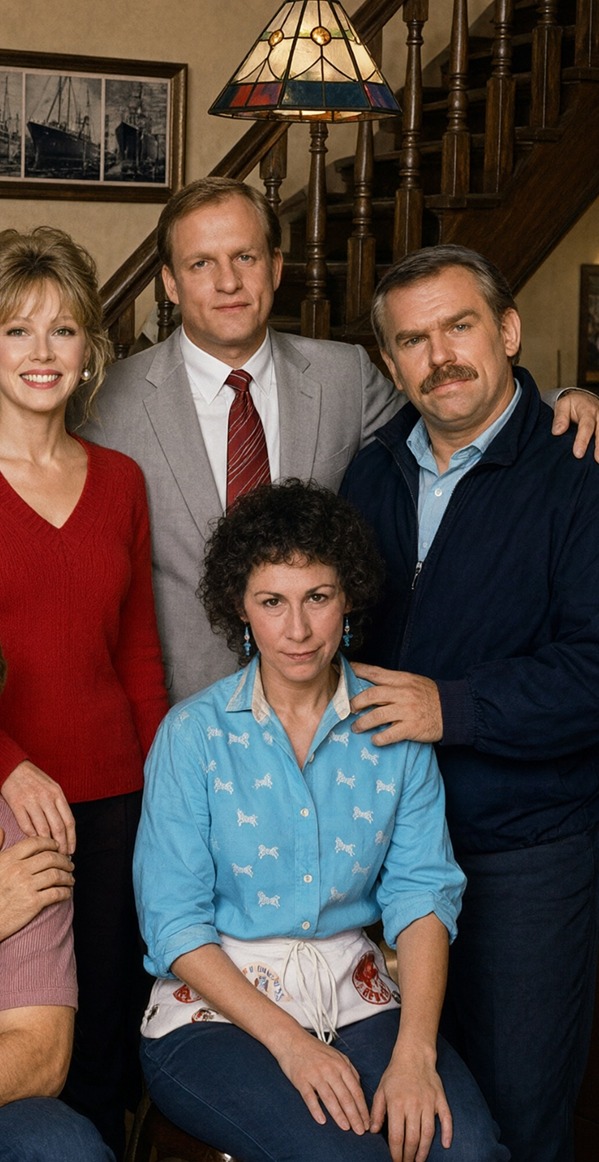
案例 46:家具整合后的室内局部放大。 从单件商品参考图构建整个房间的透视与光线。
案例 47:相机视角变换后的方形裁切。 更便于观察背景塔楼与人物之间的尺度关系。
案例 48:角色设计表放大图。 可查看脸部差分、文字和小物件的局部质量。
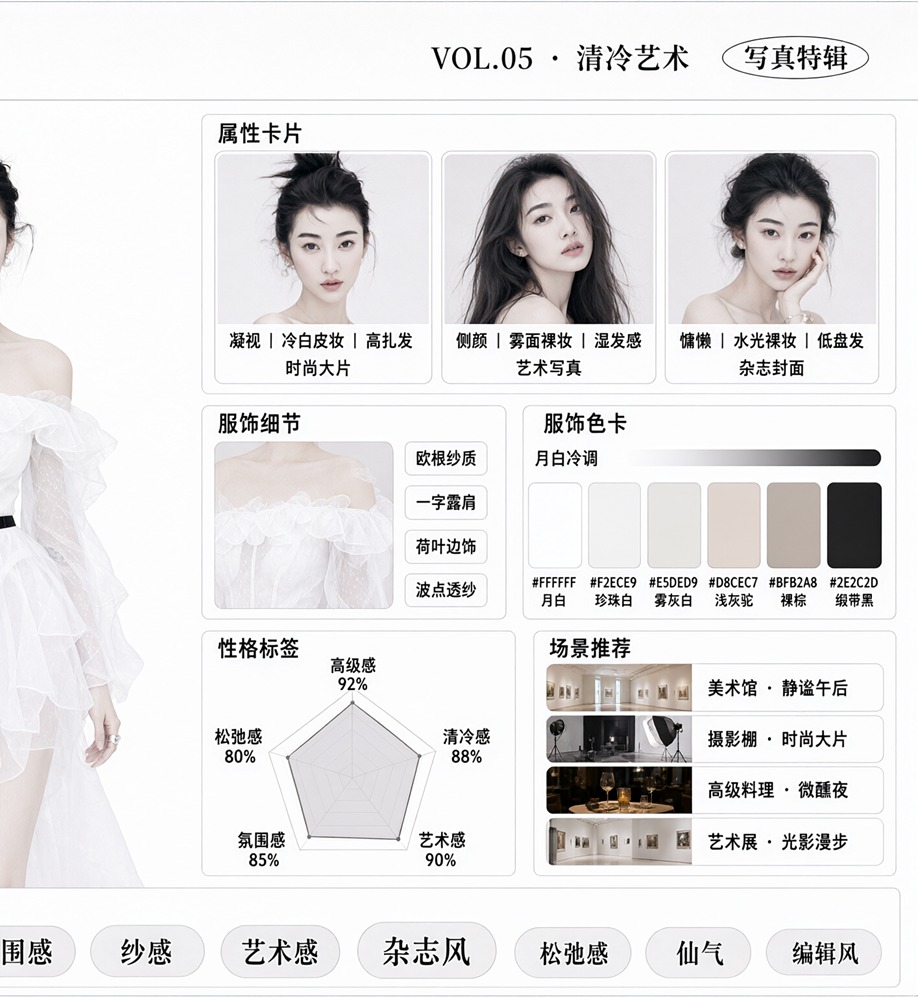
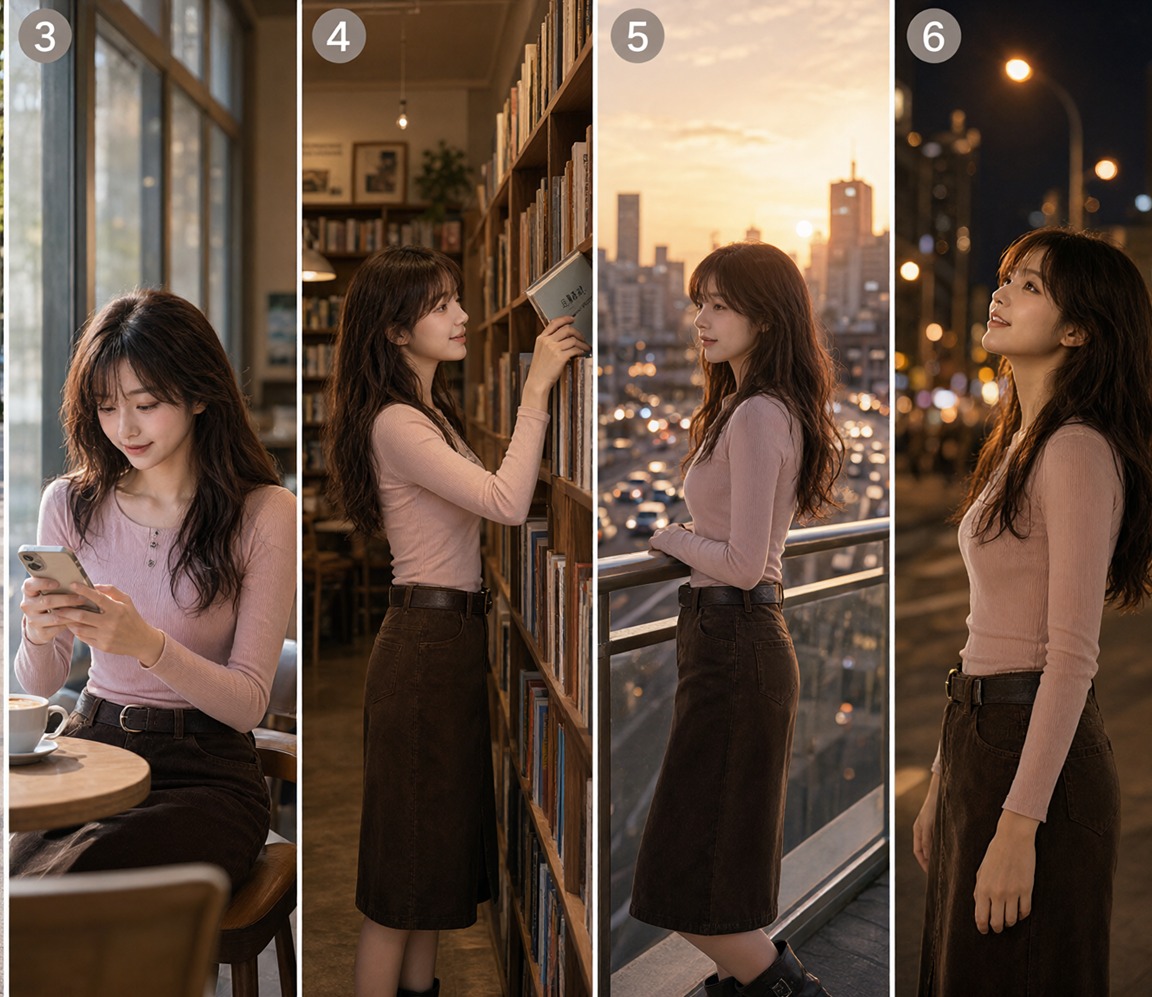
案例 49:将同一人物扩展至多个场景的局部放大。 查看长篇创作中重要的服装和脸部一致性。
案例 50:建筑信息图放大图。 展示线稿、材质、注释与留白设计这一复合任务。
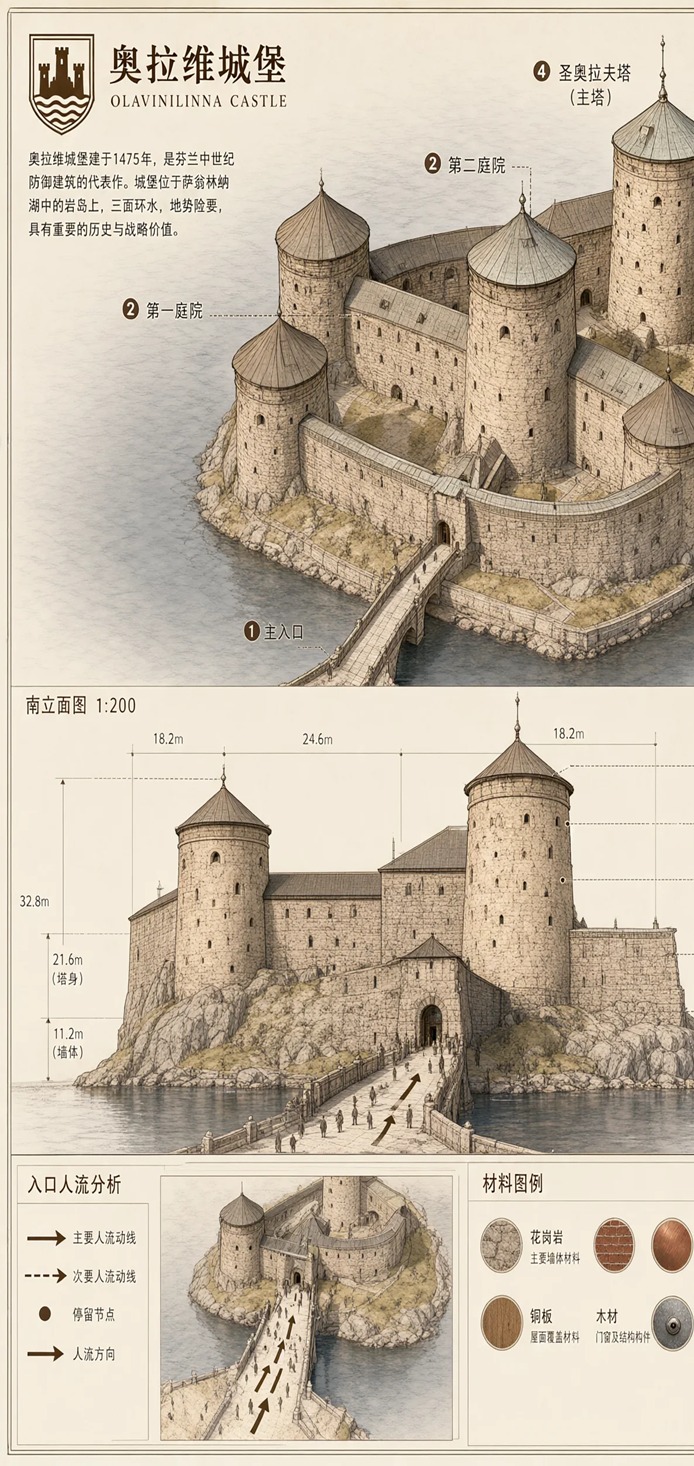
图片来源:Qwen Team「Qwen-Image-2.1」官方样例。6 张放大图是为便于对比说明而制作的编辑裁切图。
Reddit 热门案例与测试 100 选
以下从 Reddit 上主要的 Qwen-Image 2.1 帖子中,整理出 100 种实际受到讨论的绘制与编辑模式。由于其中包含发帖者的主观感受和环境差异,请不要把它当作基准测试,而应将其视为一份实践目录:通过测试什么,能够看出模型的特性。
A. 人物照片与人像(1~10)
- 如同用智能手机拍摄的业余女性照片。
- 在超市货架区拍摄的日常人像。
- 使用电影感逆光的人物照片。
- 以夜景为背景的人物重新布光。
- 同时改变为雨天和夜晚。
- 保留皮肤质感的时尚照片。
- 从低机位拍摄的右侧面镜头。
- 将正面照片转换为四分之三角度。
- 伴随大幅表情变化的人脸重生成。
- 从多种照明条件中整合生成“基准脸”。
关注来源:超过 200 张的 1girl 测试(约 1,483 票)、早期评测
B. 角色一致性(11~20)
- 同一角色的正面、侧面和背面设定表。
- 将脸部特写和全身像汇集到一张设定资料中。
- 从 2×2 脸部参考图生成一张一致的人脸。
- 将同一人物移到不同地点并保持脸部一致。
- 同一人物只更换服装。
- 同一人物只更换发型。
- 同一人物只替换姿势。
- 以写实版和漫画版分别绘制同一人物。
- 为连续镜头制作多种姿势。
- 将角色设定表作为视频生成的参考素材。
关注来源:角色设计表、四方向脸部参考(约 157 票)、Qwen 对比 FLUX.2 Krea(约 116 票)
C. 姿势、相机与构图迁移(21~30)
- 将参考图 2 的姿势迁移到参考图 1 的人物上。
- 将坐着的人物放到另一张图中的黄色椅子上。
- 将站姿改为坐姿,同时保持服装不变。
- 将正面构图改为低角度中景。
- 保持主体尺寸不变,只扩展画角。
- 从姿势工作室图像向写实人物迁移姿势。
- 将写实人物转换为辛普森风格,同时保持姿势。
- 改变相机角度时仍保持商品的佩戴位置。
- 对前景和背景同时应用较深景深。
- 在不打乱多人排列的前提下生成合影。
关注来源:编辑技巧(约 513 票)、Editing Beast(约 840 票)
D. 商品、广告与虚拟试穿(31~40)
- 将压扁的可乐罐批量替换成另一种商品罐。
- 保持罐体变形,只修改颜色和设计。
- 将商品颜色反射到周围白色表面上。
- 将另一张图中的手表自然佩戴到人物手腕上。
- 保持原有姿势、体型和光照的手表广告。
- 利用模特、衣服、鞋子、包和帽子 5 张参考图进行试穿。
- 在商品照片中放置另一张图的 Logo。
- 仅替换包装,保留拍摄布景。
- 面向电商商品的透明背景抠图。
- 在多个背景和光照条件下展示同一商品。
关注来源:Editing Beast(约 840 票)、官方博客中的多参考图示例
E. 背景、光照与材质编辑(41~50)
- 将白天背景改为雨夜。
- 保持人物不变,只替换背景。
- 同时迁移参考图的光照和背景。
- 用另一张图中的绿色纹理替换墙面。
- 将室内改为暖色夕阳照明。
- 改为高定时尚摄影风格的锐利光照。
- 根据背景光线重新计算人物阴影。
- 比较常规噪声与 Brownian 噪声的写实感。
- 比较 Euler 与自定义 eta 0.50 采样器的质感。
- 用两阶段采样器兼顾锐度与自然感。
关注来源:编辑技巧、设置测试帖子(约 80 票)
F. 透明 PNG、抠图与局部编辑(51~60)
- 单一角色的透明背景 PNG。
- 商品透明背景资产。
- 由多个元素构成的透明设计素材。
- 从照片中仅提取人物。
- 编辑透明图层上的主体。
- 对包含 Alpha 边界的形状进行修补。
- 同时修改耳机形状和透明区域。
- 只替换涂成红色的服装区域。
- 只编辑用圆圈圈出的物件。
- 完全还原蒙版外区域的局部编辑。
关注来源:使用 LanPaint 进行 Alpha 编辑(约 77 票)、早期评测
G. 扩图与修复(61~70)
- 只向左侧扩展画布。
- 只向右侧扩展画布。
- 只向上方扩展画布。
- 只向下方扩展画布。
- 同时向左、右和下方扩展。
- 补全倾斜照片中的空白区域。
- 修复因糟糕裁切而缺失的背景。
- 补全部分出画主体周围的区域。
- 保持原背景的同时扩展为宽画角。
- 在老照片修复中比较颗粒感和对比度变化。
关注来源:扩图测试(约 62 票)、对照片修复的批判性测试
H. 海报、文字与平面设计(71~80)
- 包含大标题的活动海报。
- 先确定构图和信息层级的广告设计。
- 在 2~2.5MP 下稳定大文字的比较。
- 在约 4MP 下提升无文字视觉精细度的比较。
- 含商品名称的包装设计。
- 在复古电视上显示「Qwen」的图形。
- 将招牌或 Logo 自然合成到另一张图中。
- 用长提示词制作复杂布局。
- 测试英语信息图中的文字损坏与中文混入。
- 用海报比较 GPT 系图像模型的设计质量。
I. 风格转换、插画与叙事创作(81~90)
- 从写实照片转换为漫画风格。
- 从写实人物转换为辛普森风格。
- 只将参考图的画风迁移到另一张图上。
- 保持角色与背景不变的色调转换。
- 生成宝丽来照片风格图像。
- 生成四格形式的故事板。
- 将同一人物扩展到多个场景中。
- 保持动物、汽车和人物的连续故事镜头。
- 现代动漫截图风格绘制。
- 对会被拉向写实、电影化方向的动漫风格失败案例进行比较。
关注来源:宝丽来实验、与 Krea 2 的动漫用途比较、早期评测
J. 工作流、速度与质量比较(91~100)
- 在 CFG 1~5 下比较构图、质感和对比度。
- 比较 CFG 2 以下与 CFG 4 的“过度烘焙”效果。
- 以 16 步、1MP、INT8 进行快速生成。
- 验证 25 步、2K 下的编辑质量。
- 从 30 步、2K 放大到 4K。
- 使用 4 步 LoRA 进行目标约两倍速度的编辑。
- 在 8 步、1024×1280、RTX 3060 下约 45 秒生成人物。
- 比较 Qwen 与 FLUX.2 Krea 生成角色设定表的速度。
- 测试 2K 下的像素精度与 10 张参考图整合。
- 比较 Fix v2.0 与专用采样器抑制细节噪点的效果。
关注来源:ComfyUI 模型发布帖子(约 106 票)、4 步低显存方案(约 44 票)、实验结果、Fix v2.0
Reddit 评价总结
获得高度评价的方面
- 编辑性能:即使改变颜色、背景、材质、姿势和商品,也能相对较好地保持原图。
- 多参考图:擅长组合人物、商品、服饰和小物件进行创作。
- 角色一致性:有望成为制作设定资料和连续镜头的良好起点。
- 透明图像:不仅能抠图,还能生成和编辑 Alpha 本身。
- 扩图:尤其适合一次向多个方向扩展画布。
- 尺寸与速度:作为 7B 生成部分具有实用性,量化和加速选项丰富。
被反复指出的弱点
- 手、手指、手臂和复杂人体结构不稳定。
- 远景人脸和细线容易崩坏。
- 默认输出有时会出现噪点感或细节紊乱。
- 对比度较强,黑色有时会压得过暗。
- 在照片修复中,可能擅自改变原有颗粒感或细微形状。
- 有批评认为角色设定表中的体型会显得臃肿。
- 参考图增多时,属性串线和幻觉更容易发生。
- 某些动漫风格会被拉向写实或电影化方向。
- 虽然也有文字效果很强的案例,但小文字和英语信息图仍不稳定。
- 设置、提示词重写和采样器会显著影响结果。
从这些褒贬中可以看出,Qwen-Image 2.1 并不是“一次就完美的万能模型”,而是一个“以编辑为核心,设置与工作流打磨得越细,潜力越大的创作模型”。
实用入门方式
在 ComfyUI 中,可以更新到最新版,并从内置模板选择 Text-to-Image 或 Image Edit。官方支持的工作流也已在 GitHub 上公开。建议先以接近官方的 40 步设置制作基准图,再降至 16、8、4 步,对比速度与质量。
进行编辑时,与其模糊地写“变得更好”,不如按以下顺序描述,便于测试。
- 要修改什么。
- 要从哪张参考图中取用什么内容。
- 哪些内容绝对不能改变。
- 应如何保持光线、背景、体型、姿势和构图。
- 将容易失败的元素写入负面指令。
例如进行商品合成时,可以明确写成:“保持图像 1 中的人物和姿势,只将图像 2 中的手表佩戴到手腕上。不要改变体型、背景和光照。”多参考图时,重要的是不要模糊 <image1>、<image2> 分别对应什么。
对于透明图像,Reddit 分享的示例会明确写出“RGBA image”“alpha channel”“background is transparent”。如果希望连透明边界也一起编辑,应使用 LanPaint 等支持 Alpha 的蒙版处理。
适合哪些人
Qwen-Image 2.1 适合以下用途。
- 希望用 ComfyUI 在本地创作的人。
- 希望只修改人物或商品局部的人。
- 希望将多份参考素材汇集为一支广告或一个场景的人。
- 希望制作角色设定资料或视频参考图的人。
- 希望制作透明 PNG 或游戏、网页资产的人。
- 希望在专用服务器上运行图像生成与编辑 API 的研究和开发团队。
反过来,如果需求是完整的照片修复、长篇连续作品中的严格一致性、手指至关重要的复杂姿势、密集小文字的信息图,或者在默认可商用前提下直接采用,则必须与其他模型进行比较,并核实许可证。
总结
Qwen-Image 2.1 的本质,在于将 T2I、图像编辑、最多 10 张参考图、局部编辑、透明 RGBA 与主体提取整合到一个参数规模相对较小、仅 70 亿参数的生成部分中。Reddit 上最受关注的也并非单纯生成美少女,而是替换手表或罐子、制作角色设定表、迁移背景与光照、扩图和 Alpha 编辑等能够“缩短创作流程”的用法。
另一方面,案例评价很大程度上受设置影响。CFG、采样器、步数、分辨率、提示词重写和加速 LoRA 都能让结果产生仿佛来自不同模型的差异。更稳妥的做法是先用官方设置建立基准,再逐项比较改动;对于重要项目,则与其他模型进行盲测比较。
最大的注意事项依然是许可证。即使权重公开,也不代表商业使用自动自由。它在技术上极具吸引力,但若要用于业务,请先确认官方许可证和最新条款,再作决定。
主要链接
- Qwen-Image 2.1 官方博客
- 官方 GitHub 仓库
- Hugging Face Diffusers 文档
- ComfyUI 模型
- Reddit:1girl 案例集
- Reddit:Editing Beast
- Reddit:编辑技巧
- Reddit:扩图
- Reddit:Alpha 通道修补
- Reddit:Qwen-Image 2.1 Fix v2.0
※本文基于截至 2026 年 10 月 4 日的官方信息和公开社区帖子撰写。Reddit 票数、模型周边工具和许可证条款均可能发生变化。