试着用预演做 AI 视频生成:粗糙也比没有好
我试着把用盒子和人体模型制作的简单预演交给 AI 视频生成。预演是一种粗略的视频,用于提前确定人物的位置和动作,以及镜头运动。
先说结论:相当好用。不过,细节并不会被原样复现。相反,给出大致的导演意图后,它会恰到好处地补全缺失的部分。作为这种用途的设计图,它非常方便。
对比预演与生成结果
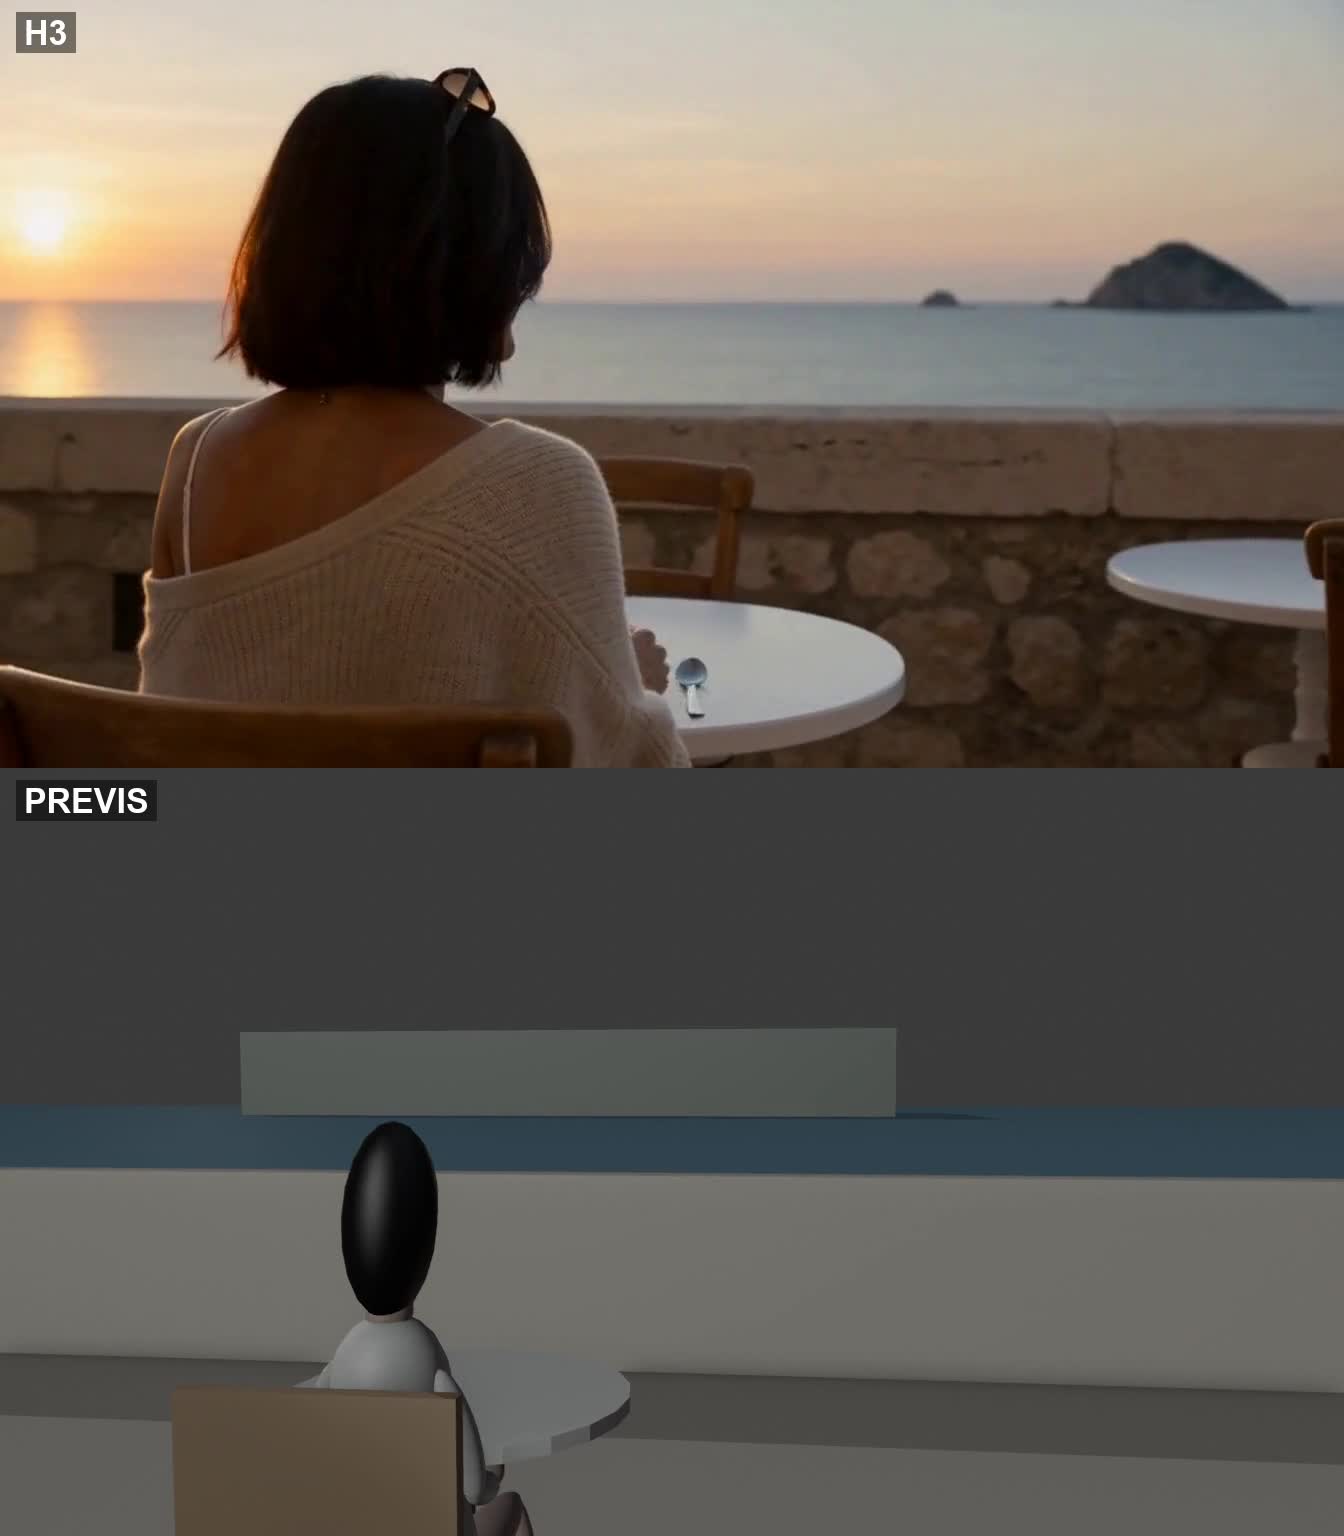
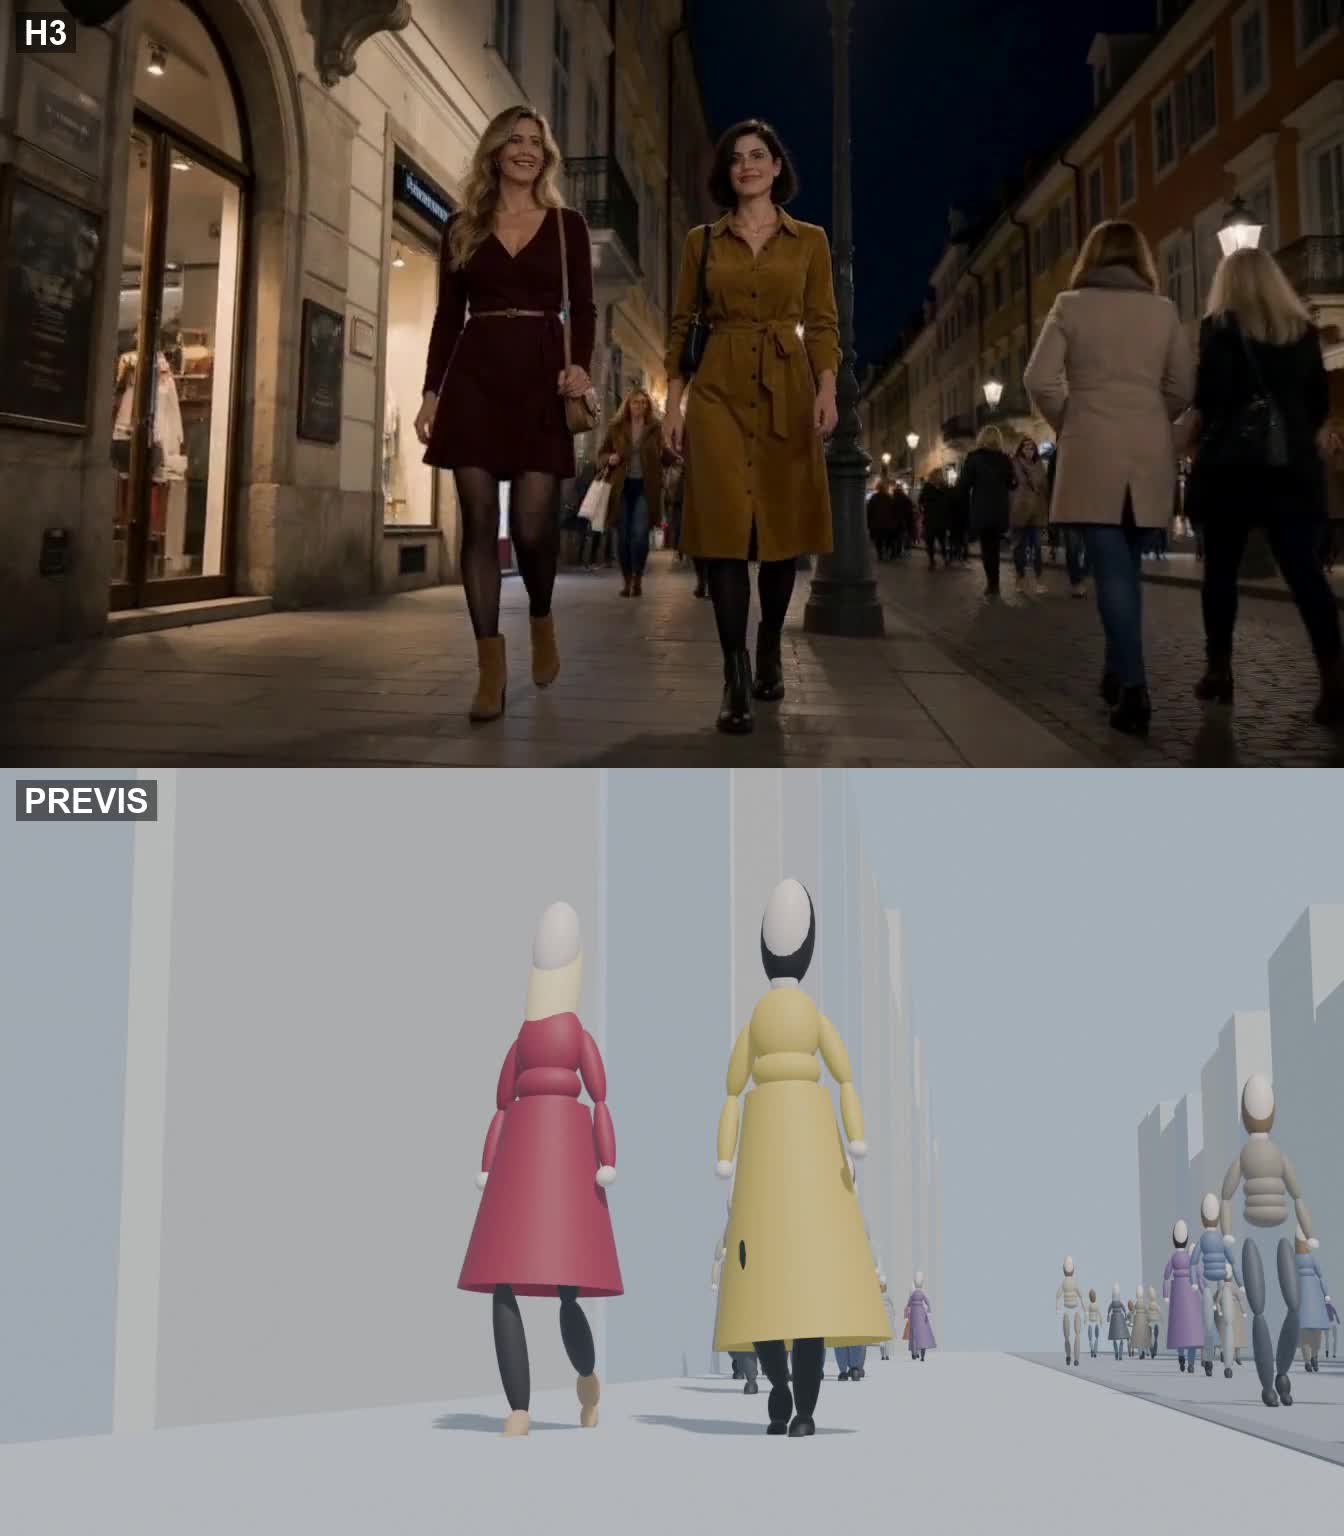
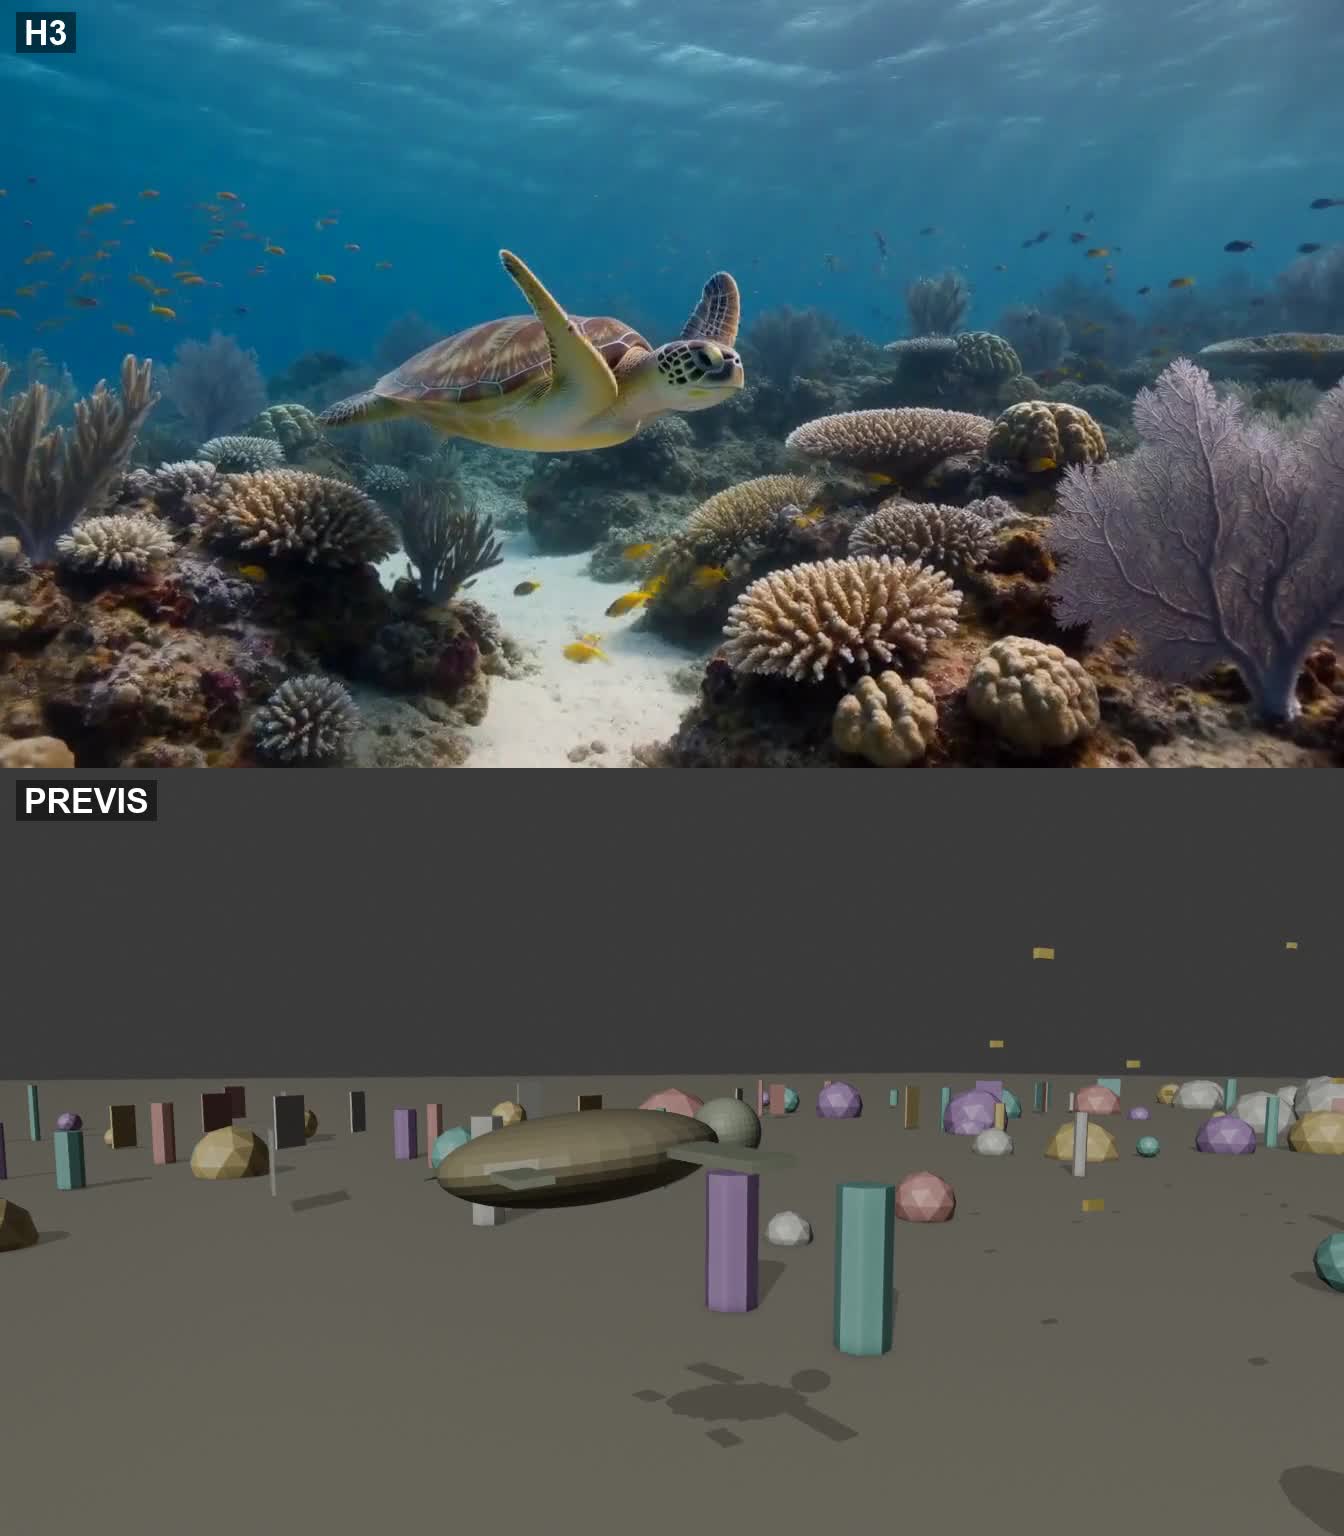
所有视频均为:上方是 AI 生成的视频,下方是原始预演。每段约 15 秒。我想测试的是,即使不细致制作背景和人物,究竟能传达多少场景流程。
海边咖啡馆
从简单的桌子和人物布局,变成黄昏时分的咖啡馆。把把饮料送到嘴边等动作,转化为写实风格的视频。
漫步夜晚街头
通过预演指定人物的位置和行走方向。借助提示词,将如同白天般明亮而简略的街景打造成夜晚的街头。
水中的海龟
从粗略的海底和海龟动作,变成带有水下光线与珊瑚的景观。这是一个很容易看出视觉补全效果的示例。
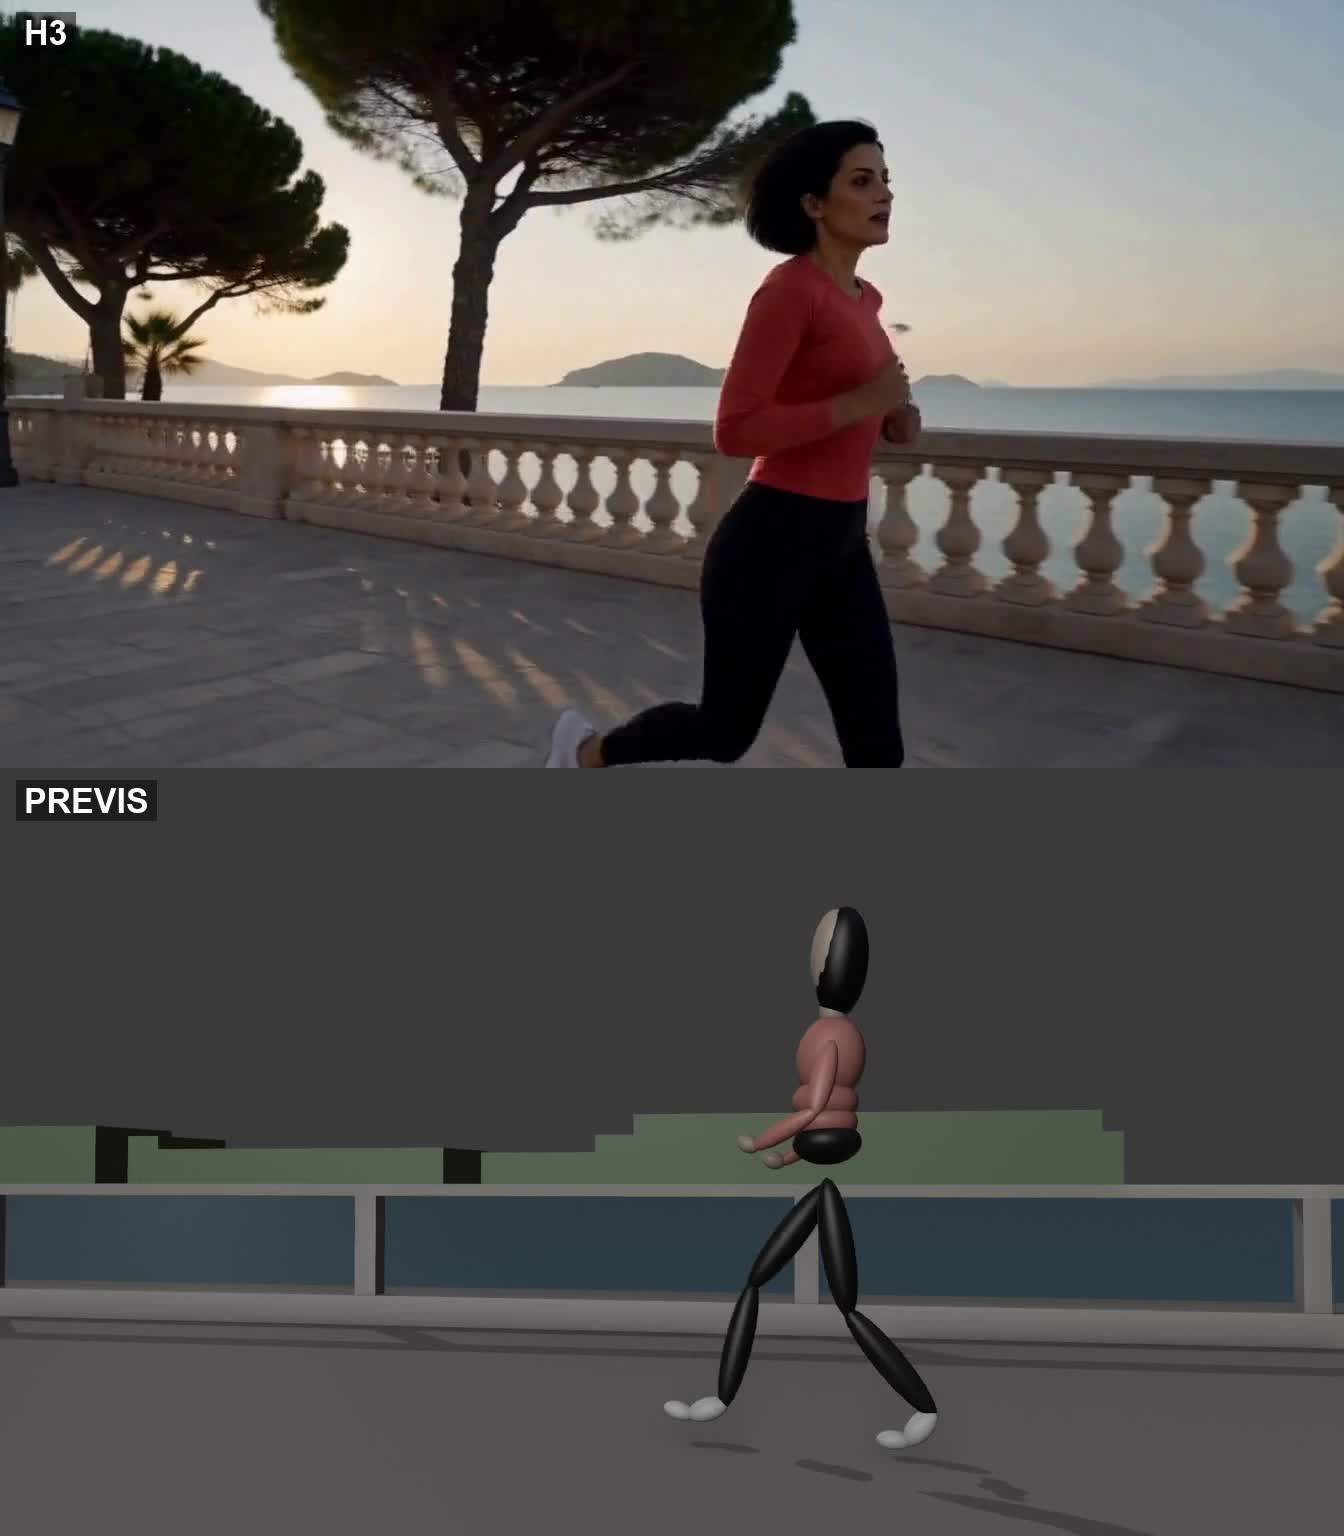
海边跑步
指定奔跑人物以及跟拍它的镜头运动。粗略的背景被替换成了海滨步道。
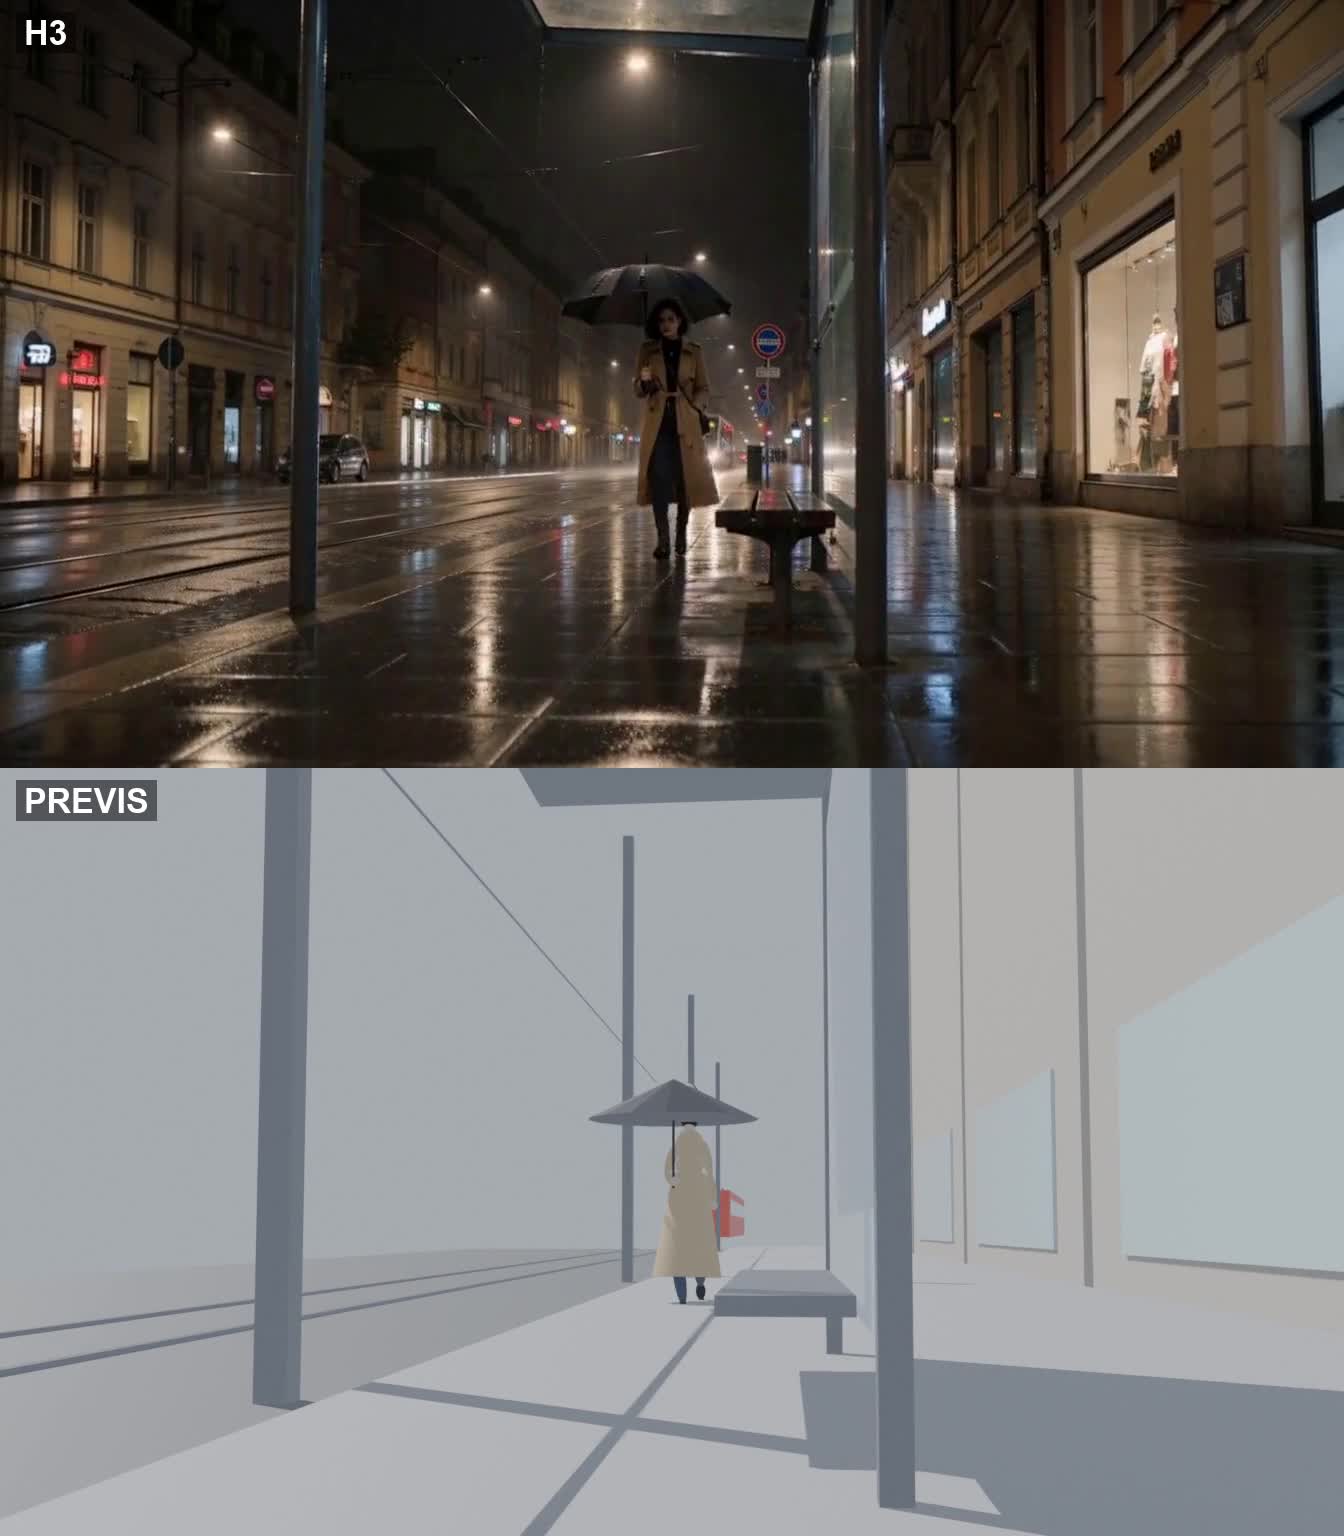
雨中的街道与电车
以撑伞人物和电车的布局为基础,加入了雨夜的氛围。
制作方法很简单
这次制作采用了以下流程。
- 使用 Python+Blender 4.2,以盒子和简单形状制作预演。人物动作还使用了 Mixamo。
- 使用 Codex 的图像生成准备人物等参考图。
- 向 MiniMax-H3 Ref2VA提供预演、参考图和参考音频,生成约 15 秒的视频。
- 台词使用 HiggsAudio v3,音效使用 Stable Audio 3 Medium,BGM 使用 ACE-Step 1.5 制作,并用 ffmpeg 混音和剪辑。制作脚本和运行管理使用了 Claude Code。
指令的关键是分开不同参考资料的作用。让模型将“图片”作为面部和服装的参考,将“预演”作为布局、动作和镜头运动的参考,同时说明不要继承人体模型或盒子的外观。夜晚、雨天、照明等最终效果,则通过文字指定。
能用,但细节会有不少变化
人物布局、移动方向、动作顺序和镜头的大致运动比较容易传达;但“几秒后停下”“缩放多少”这类细致要求,则可能出现偏差,或根本没有被反映出来。它并不能严格固定所有细节。
此外,预演中的灯光闪烁,或排列得过于规整的背景,有时也会留在生成结果中。预演的灯光和形状最好都保持简单,聚焦于想传达的动作。
即便如此,能够从粗略的指定补全出美观的视频,依然很方便。虽然细节会有不少变化,但要传达导演意图的大框架已经完全够用。不必做到完美精细,即使粗糙,也值得使用预演——这就是我这次的感想。