我试着用 3200 万参数做了一个克罗地亚语语音合成模型:听听训练过程中的声音变化
继用于克罗地亚语 RAG 的 LLM之后,这次我尝试做了一个克罗地亚语专用的小型语音合成(TTS)模型。目标是让它能在智能手机 CPU 上实时运行。
方法是“蒸馏”。我让大型语音合成模型(HiggsAudio v3)朗读克罗地亚语脚本来制作训练数据,再用这些数据从头训练一个小模型。这次先用 7.5 小时的数据进行了试验性训练,并对比聆听同一句话随着训练推进发生的变化。
先说结论。
- 用 3200 万参数(Matcha-TTS 1830 万+Vocos 1350 万),确实能说克罗地亚语了
- 训练 50 分钟(5000 步)时,就已经能按脚本朗读。 此后主要改善的是“噪声”
- 评估用的 14 个句子,最终字符错误率为 0.9%(其中 10 句完全一致)
- 即使只用一个 CPU 线程,也能在 0.09 秒内生成 1 秒音频(i7-13700K)
演示:让它实际说说看
我把本文的模型(最终的 30,000 步版本)放到了 克罗地亚语 TTS 演练场。输入任意克罗地亚语,它会立即朗读出来。
- 可从 50 个例句(问候、旅行、医院等)中选择,也可以自行输入,最多 1,000 个字符
- 可以调整语速、语调幅度和合成步数。固定随机种子后,同一句话每次都会生成相同的音频
- 合成完全在服务器 CPU 上运行(ONNX Runtime,不使用 GPU 或外部 API)
- 它不会读数字,因此需要把数字写成单词,例如“dvadeset pet(25)”
做了什么
1. 制作脚本:让本地的 Gemma 4 31B 编写克罗地亚语日常对话台词。随机指定“在市场和祖母聊天”“半夜听到怪声而感到害怕”这类情境、交谈对象、情绪和长度,每次生成 22 行。设定为一名 30 多岁的女性说话。混入了 23 种情绪(普通、喜悦、愤怒、耳语等)。
2. 生成音频:让 HiggsAudio v3 用一段参考音频(16 秒)中的声音朗读脚本。加上情绪标签(如 <|emotion:anger|>)后,它确实会表现出愤怒或喜悦。约 5 小时生成了 4,500 段。
3. 自动检查:使用 Whisper large-v3 转写后与脚本对照,剔除误读的音频。同时,用说话人识别模型衡量其与参考音频的声线相似度,也剔除了变声的音频。通过的有 4,500 段中的 4,393 段(97.6%)。裁掉前后的静音后,得到 7.46 小时的音频。
4. 训练小模型:在 RTX 4090 上训练了 5 小时的 Matcha-TTS(一种采用流匹配方法的 TTS)。约 3 万步。将音频还原为波形的部分(声码器)则直接使用公开的 Vocos。
克罗地亚语基本上是按拼写发音的语言,因此没有转换成发音符号,而是直接将字符作为输入。不过,lj、nj 和 dž 各自代表一个音,所以把它们合并视为一个字符。
对比聆听训练过程中的音频
我用训练数据中没有出现过的句子“Molim Vas, možete li mi reći koliko košta ova haljina?(请问,这条连衣裙多少钱?)”让训练过程中的模型合成语音。
第 5,000 步(训练开始约 50 分钟后)
第 10,000 步(约 1 小时 40 分钟后)
第 15,000 步(约 2 小时 20 分钟后)
第 20,000 步(约 3 小时 10 分钟后)
第 30,000 步(约 5 小时,最终版)
作为参考,下面是担任教师的 HiggsAudio 制作的一条训练数据(另一句话:“Samo polako hodajte, nema potrebe da žurimo kroz ovaj mrak.”)。
用 Whisper 转写时,这句话从 第 5,000 步到最后,全部与脚本逐字一致。也就是说,“在说什么”从一开始就已经做到了。
差别在于声音的干净程度。听感上,第 5,000 步带有粗糙的噪声,到第 10,000 步已大幅减少。把同一段音频转换成频谱图(横轴为时间,纵轴为频率)后,区别就很明显了。
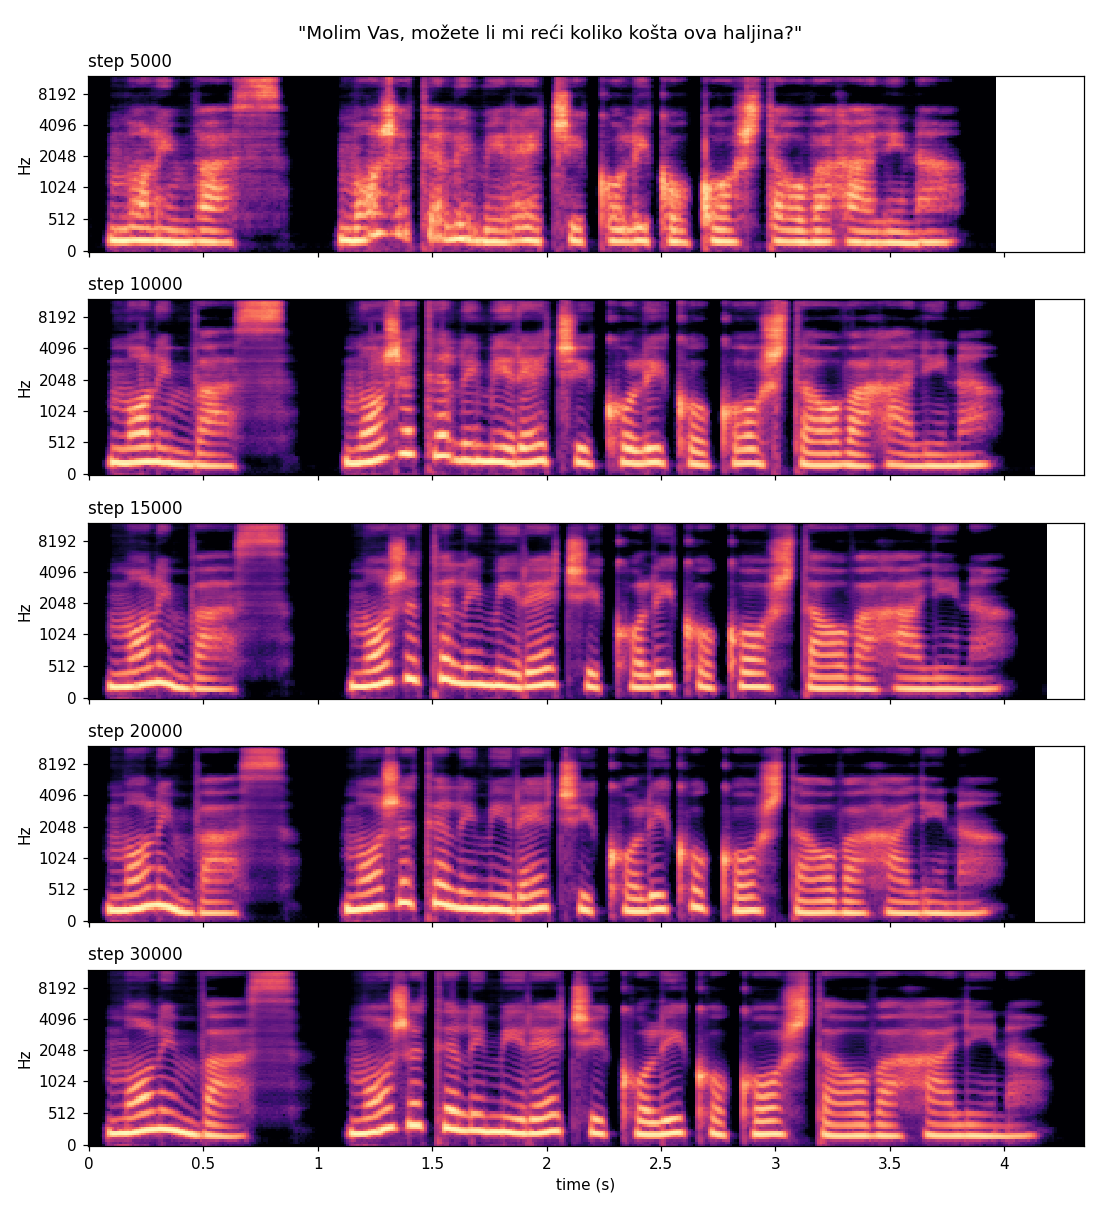
与音高相对应的横纹(谐波)在第 5,000 步时较为模糊,纹路之间的空隙也被朦胧地填满。这正是听起来像噪声的部分。第 10,000 步之后,横纹变得清晰,空隙则更暗。随着训练推进,横纹上下起伏的曲线也变得更平滑,看起来音高的变化(语调)也更清楚了。
用数字来看
我用 Whisper large-v3 转写了 14 个评估句子(全部未包含在训练数据中),并测量字符错误率(CER)。其中包含从简短问候到约 16 秒独白的内容。
| 步数 | 训练时间 | 字符错误率 | 完全一致 |
|---|---|---|---|
| 5,000 | 约 50 分钟 | 1.1% | 9 / 14 |
| 10,000 | 约 1 小时 40 分钟 | 3.4% | 8 / 14 |
| 15,000 | 约 2 小时 20 分钟 | 0.7% | 11 / 14 |
| 20,000 | 约 3 小时 10 分钟 | 0.9% | 11 / 14 |
| 30,000 | 约 5 小时 | 0.9% | 10 / 14 |
- 第 10,000 步的数值变差,几乎只是因为“Bok!(你好)”这一句被识别成了“Vok”。3 个字符中错了 1 个,仅这一句的错误率就是 33%。但用耳朵听,第 10,000 步比第 5,000 步干净得多。字符错误率只能衡量“有没有读对”,声音是否干净只能靠听来判断
- 最后仍然出错的是“Đak je pojeo džem(学生吃了果酱)”中的 đ 和 dž。即使在克罗地亚语中,这些音出现得也较少,被识别成了“Žak”和“Džak”
CPU 上的速度
我在 i7-13700K 上用原始 PyTorch(未优化)进行了测量。生成 4 句话、共 47.6 秒的音频 3 次,取平均值。RTF 是“生成所耗时间 ÷ 音频时长”,越小越快。
| 线程数 | 步数 | Matcha | Vocos | 总 RTF |
|---|---|---|---|---|
| 1 | 2 | 0.042 | 0.025 | 0.067 |
| 1 | 4 | 0.067 | 0.025 | 0.092 |
| 4 | 4 | 0.032 | 0.010 | 0.042 |
| 8 | 4 | 0.028 | 0.007 | 0.036 |
“步数”是合成时从噪声生成声音所进行的迭代次数,上面的试听对比使用了 4 步。即使只有一个线程,也能在 0.09 秒内生成 1 秒音频。智能手机 CPU 会比这更慢,但应该仍能满足实时要求(尚未在真机上测量,因此这只是预测)。
TTS 需要多少小时的数据?
既然用 7.5 小时就做到这个程度,我查了一下一般的参考标准。
- 常用于单人声 TTS 的英语 LJSpeech 数据集约有 24 小时。Matcha-TTS 的官方模型也是用它训练的
- 日语 JSUT 和中文 CSMSC 约有 10 小时,都很常见地被用作单人声语料库
- 从头训练时,约 1 小时大致是下限;视模型而定,发音错误会增加
- 如果在预训练模型上继续训练,有报告称 30 分钟的数据达到的效果,大致相当于从头训练 27 小时
还有一项仅用合成语音训练 Matcha-TTS 的研究(上海交通大学,2025 年 12 月)。研究指出,文本类型越丰富、音频越干净无噪、说话方式越一致,训练效果就越好。合成数据没有噪声,且说话方式也一致,因此相同时长下,可能比实际录音更容易学习。这次用 7.5 小时就达到这个结果,似乎也符合这一点。
踩过的坑
- 电脑卡死了:用于生成脚本的 31B 模型不小心同时加载了两个到 GPU,导致显存溢出。从那以后,我规定“GPU 上始终只能加载一个模型”
- Gemma 4 想得太多:约三分之二的输出都是“思考”内容。关闭思考后,速度约提高了 3 倍
- HiggsAudio 的幻听:最初测试时,有一段音频在句子后的静音部分自顾自接着说“Hvala što pratite kanal(感谢观看频道)”,最后变成了 81 秒。看起来像是记住了 YouTube 的结束语。后来会剔除时长与预期严重不符的音频
- Matcha-TTS 无法在 Windows 上运行:部分 C 扩展无法构建,因此我用 Python(numba)重写了那部分