我从零训练了一个用于克罗地亚语 RAG 的 3 亿参数 LLM,可在 CPU 上运行
继上次的 GPT-2 之后,这次我用一张 RTX 4090 从零开始训练了一个克罗地亚语 LLM。目标是用于 RAG:模型从提供的文本中寻找答案,并引用一句依据来作答。而且正式环境假定只在 CPU 上运行。
先说结论。
- 从零到完成,GPU 总计约 68 小时(含试错)。 其中预训练耗时 51 小时
- 3.2 亿参数。段落问答正确率 71%,3,000 token 级长文本正确率 44%
- 仅用 CPU,每题可在 3~16 秒内作答。文字逐行出现的速度肉眼都能跟上
训练耗时
| 阶段 | 时间 | 内容 |
|---|---|---|
| 训练数据生成 | 约 4.5 小时 | 用 EuroLLM-9B(vLLM)生成 4.5 万条 Wikipedia QA 和 5 万条对话翻译 |
| 分词器与分词 | 约 2.5 小时(CPU) | 自制了一个包含 3.2 万词条的克罗地亚语词表 |
| 预训练 | 50 小时 46 分 | 70 亿 token;最后 10% 的训练将上下文长度扩展到 4,096 |
| SFT | 约 35 分钟 | 教会模型带引用回答;没有答案时则拒答 |
| 强化学习(GRPO) | 约 11 小时 | 400 步加上调优后的 300 步 |
自制分词器表示克罗地亚语所需的 token 数约为 GPT-2 分词器的一半。按此计算,4,096 token 可以读取约 1.7 万个字符。
训练出的模型
| 项目 | 内容 |
|---|---|
| 参数量 | 3.2 亿(24 层、1,024 维) |
| 架构 | Llama / Qwen3 系(GQA、SwiGLU、RoPE、RMSNorm+QK-Norm) |
| 上下文长度 | 4,096 token |
| 输出格式 | 答案+Izvor: „从上下文原样摘取的一句话“。若无答案则输出「U tekstu nema odgovora na ovo pitanje.(正文中没有这个问题的答案)」 |
| 运行方式 | 以 CPU 为前提(fp32 约 1.3GB) |
此外,我还在模型外部加了一套机制:用程序核对生成的引用是否确实存在于上下文中,若不存在就替换为“无答案”。关键在于不完全信任模型,而是让依据能够被验证。
实际制作中发现的问题
1. 即使没有答案,也会每次都编造。 一开始我只是普通地教它问答。正确率虽然提高了,但给它没有答案的文章时,100% 都会编出看似合理的答案。这正是 RAG 最棘手的问题。后来教它引用和“拒答”后,编造的比例降到了几个百分点。
2. 拒答过头。 我把强化学习的评分设为“答错 −0.5,拒答 0”,结果它学会了在困难的长文本中拒答逃避更划算,于是有七成问题都拒答。它精准钻了评分规则的空子。把拒答分数改成 −0.3 后,它又转向另一端,几乎不再拒答,编造比例升至四成。来回摆动,像跷跷板一样。
3. 抄错引用。 在长文本中,答案虽然正确,却会调换引用的词序,或引用文章的第一句话。长上下文里连引用都正确的比例大约只有一半。
4. 能绕过核对的错误。 它准确引用了混入上下文的另一篇文章中“出生于〇〇”这句话,却回答了另一个人的出生地。引用本身是真的,因此核对机制无法拦住它。
5. 评测数据本身的漏洞。 某些本应“没有答案的上下文”中残留了部分答案,模型其实答对了,却被判定为“编造”。
最终性能
每项评测各 300 题。使用的是经过调优的强化学习第 100 步模型(拒答与作答的平衡最佳)。
| 上下文 | 正确 | 错误 | 拒答 |
|---|---|---|---|
| 段落(约 100~400 token) | 71.3% | 16.7% | 12.0% |
| 长上下文(1,500~3,500 token) | 44.0% | 20.3% | 35.7% |
| 无答案的上下文 | 正确拒答 | 编造 |
|---|---|---|
| 段落 | 97.7% | 2.3% |
| 长上下文 | 92.3% | 7.7% |
经过核对后,“已作答内容中答对的比例”为 73.8%,距离 90% 的目标仍然很远。
顺带一提,如果让模型每题作答 8 次、只要有一次答对就算通过,段落能达到 91%,长文本能达到 74%(在最后一个检查点测得)。强化学习前后这个数字几乎没变;改变的是“能否每次都答对”。数据清楚显示,强化学习与其说是在增加新能力,不如说是让偶尔能解出的题目变成每次都能解出。
在 CPU 上运行
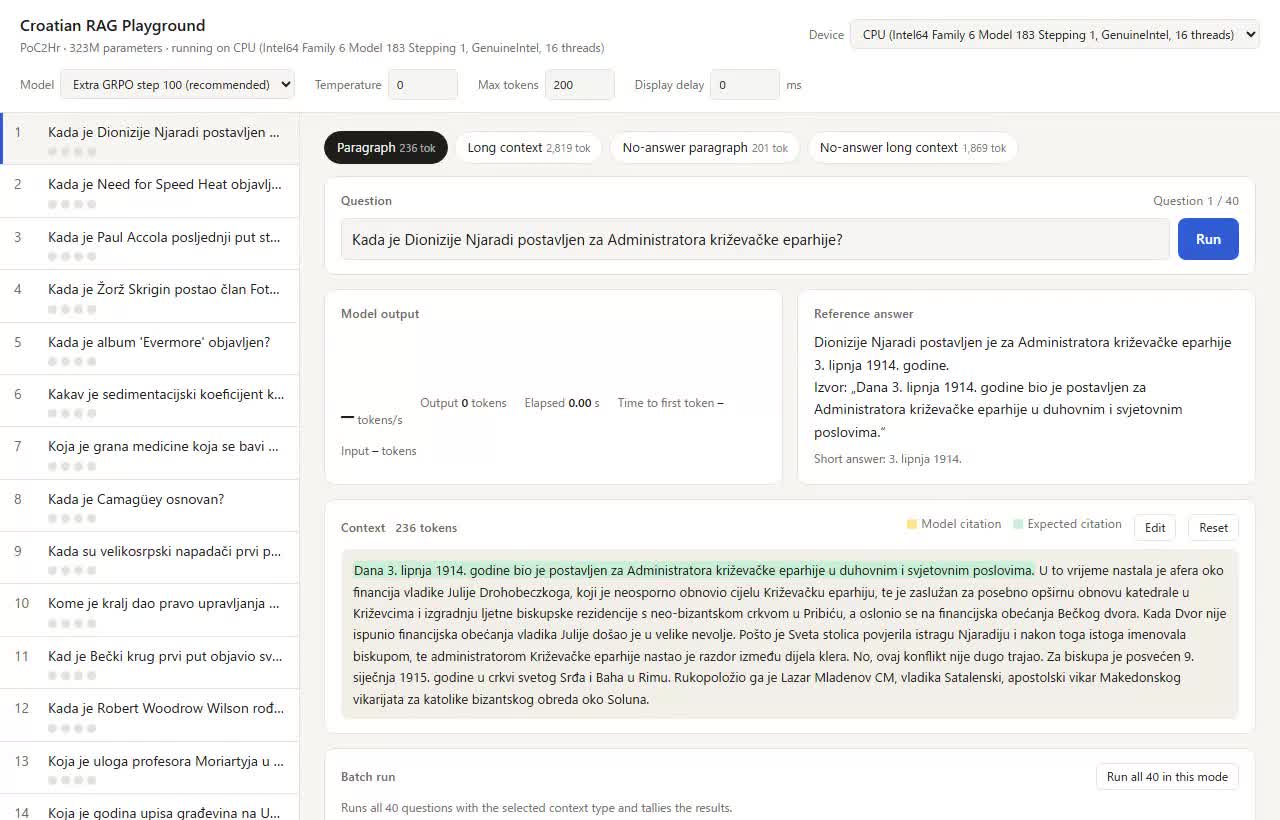
我做了一个测试用 Web UI,只用 CPU(i7-13700K)运行。文字显示的速度就是实际生成速度。
段落(263 token):首字出现前 0.3 秒,约 11 token/秒,总计 7 秒
长上下文(3,215 token):读取文章约需 5 秒,约 5 token/秒,总计 19 秒。黄色部分是引用的句子;模型确实从 3,000 token 的内容中找到了正确的一句话
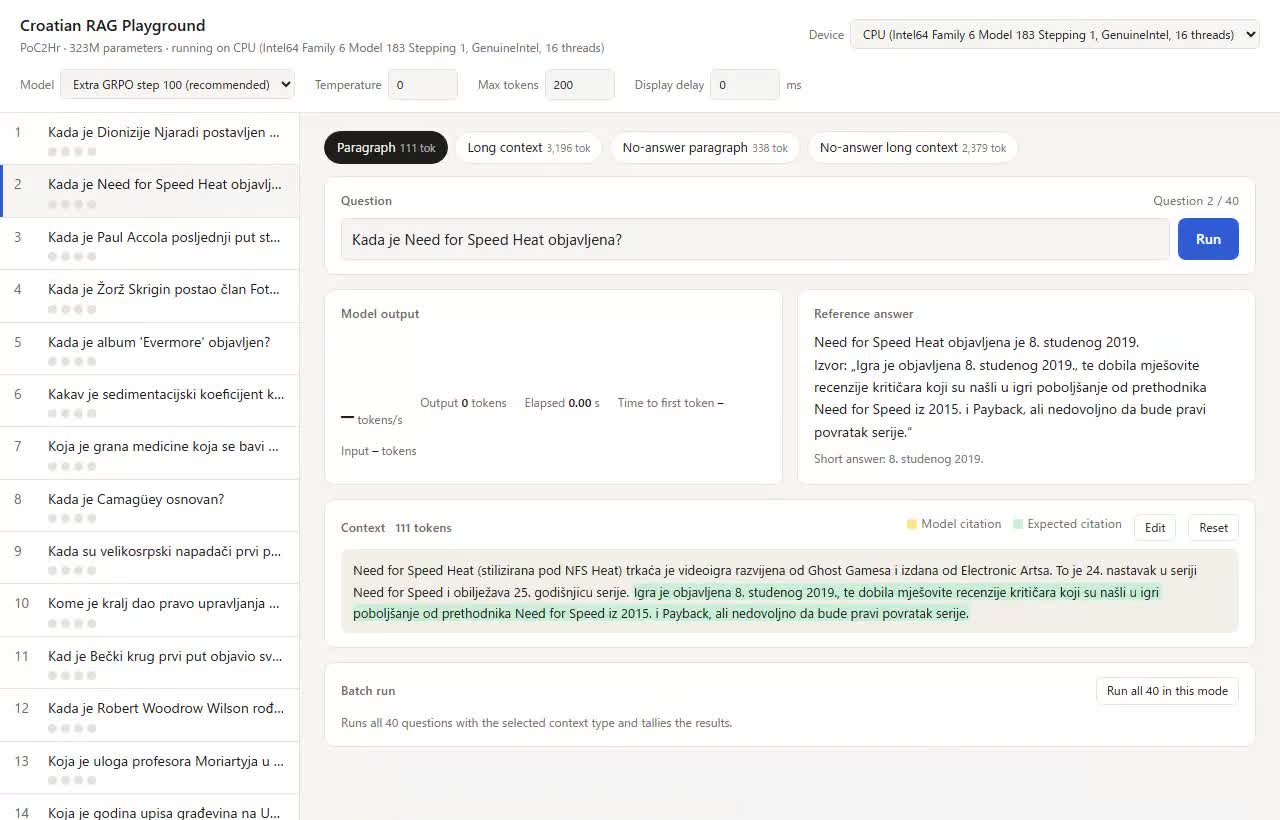
视频是在录制时拍的,因此稍慢一些。不录制时各测 20 题,段落为 15 token/秒、每题 3.4 秒;长上下文为 7 token/秒、每题 16 秒。答案很短,约 50 token,因此即使用 CPU,速度似乎也足以实用。
思考
- 小模型最重要的是让它能够说“我不知道自己不知道的事”。 对 RAG 而言,减少编造比提高正确率更有效。引用+拒答+外部核对的组合相当有效
- 3 亿参数面对长文本已到极限。 即便作答 8 次,长文本也只能达到 74%。若想在长文本上达到九成,可能需要约 10 亿参数
- 核对不能只检查“引用是否真实存在”。 还需要确认引用中是否包含答案的数字或姓名,以及主语是否与问题中的人物一致
- 能在 CPU 上运行的 3 亿参数模型,很适合用于无法上传到网络的文档问答。 没有 GPU 的笔记本或服务器,也可以只依据本地文档回答。每题耗时数秒到十几秒,量化后应该还能更快(尚未验证)
下一步想尝试 10 亿参数版本,目标是让长上下文达到九成正确率。