将自制的 3 亿参数 LLM 量化,比较 CPU 上的速度与准确性
我在上一篇文章中制作了一个用于克罗地亚语 RAG 的 3.2 亿参数模型。既然目标是在 CPU 上运行,这次就对它进行了量化,测试它能缩小和加速到什么程度,以及准确性会下降多少。
先说结论。
- Q6_K 正合适。 体积缩至 1/5(254MB),生成速度约提升 4 倍,准确性与原模型相同
- Q2_K 会失效。 虽然很快,但即使问题有答案,它也会回答“没有答案”
- 出乎意料的是,Q3_K_M 比 Q4_K_M 更准确
做了什么
我将用 PyTorch 制作的模型转换为可在 CPU 推理中常用的 llama.cpp 上运行的格式(GGUF),并以 8 种不同精度保存。
- 将模型导出为与 Qwen3 相同的格式,再转换为 GGUF
- 由于分词器是自制的,llama.cpp 将其识别为“未知分词器”而拒绝转换。对比分词规则后发现它与 Qwen2 完全一致,于是将其注册为 Qwen2 后通过了转换
- 确认转换是否正确。 160 篇文本的分词结果与 PyTorch 版全部一致。在 20 道题中,每次都选择概率最高的词进行生成,20 道题的输出也完全一致
- 使用
llama-quantize制作 F16~Q2_K 版本
因此,表中的 F32 与 PyTorch 版的内容相同,是本次比较的基准。
测量方法
- CPU 为 i7-13700K,未使用 GPU
- llama.cpp 设置为:生成使用 8 线程,文本读取使用 16 线程(测试后这是最快的组合)
- 对评估用的 100 道题 × 4 种上下文,让每个模型各回答 400 次
- 段落:包含答案、约 100 个 token 的段落
- 长文:包含答案、约 3,000 个 token 的文本(也混入了无关文章)
- 无答案(段落/长文):不含答案的文本;能够拒答即为正确
- 上一篇文章用 300 道题测试,因此数字会略有不同
结果:准确性
| 格式 | 大小 | 段落正确 | 长文正确 | 长文拒答 | 编造(无答案 段落/长文) | 核验后的准确率 |
|---|---|---|---|---|---|---|
| F32(基准) | 1,233MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| F16 | 617MB | 77% | 53% | 30% | 1% / 9% | 80.9% |
| Q8_0 | 329MB | 76% | 53% | 30% | 1% / 8% | 81.9% |
| Q6_K | 254MB | 79% | 54% | 30% | 2% / 9% | 81.3% |
| Q5_K_M | 223MB | 72% | 45% | 41% | 1% / 6% | 84.4% |
| Q4_K_M | 193MB | 68% | 37% | 46% | 1% / 7% | 75.9% |
| Q3_K_M | 160MB | 72% | 48% | 38% | 1% / 8% | 80.4% |
| Q2_K | 129MB | 39% | 11% | 78% | 4% / 7% | 72.2% |
“核验后的准确率”是指:用程序确认模型引用的内容是否确实存在于文本中;若不存在,就替换为“无答案”后,在实际作答中回答正确的比例。
- F16、Q8_0、Q6_K 与基准几乎相同。 差距仅有 1~2 题
- 从 Q5_K_M 往下,与其说错误变多,不如说“拒答”变多。 看起来是此前训练出的“没把握就拒答”的特性原样保留了下来,编造并没有增加
- Q4_K_M 比 Q3_K_M 更差。 长文分别为 37% 和 48%。虽然只有 100 道题,存在一定波动,但 11 个百分点的差距很大,原因尚未调查
- Q2_K 会拒答 78% 的长文。 它已经像是另一个模型了
结果:速度
| 格式 | 生成速度 | 单次平均时间 |
|---|---|---|
| PyTorch fp32(参考) | 段落 14.6・长文 6.7 tok/s | — |
| F32 | 18.7 tok/s | 2.76 秒 |
| F16 | 35.9 tok/s | 2.08 秒 |
| Q8_0 | 59.0 tok/s | 1.93 秒 |
| Q6_K | 73.1 tok/s | 1.33 秒 |
| Q5_K_M | 81.2 tok/s | 1.26 秒 |
| Q4_K_M | 89.1 tok/s | 1.10 秒 |
| Q3_K_M | 103.4 tok/s | 1.12 秒 |
| Q2_K | 119.9 tok/s | 1.07 秒 |
llama.cpp 的数据为 400 次的平均值(汇总了段落、长文和无答案情形)。PyTorch 的数据来自上一篇文章的测量。
- 生成速度与体积几乎成反比。在 CPU 上,决定速度的是从内存读取权重的速度,而不是计算速度,因此越小越快
- 即使同为 F32,llama.cpp 也比 PyTorch 快
- 不过从 Q6_K 往下,单次耗时缩短得不多。在这个长度下,初始读取文本的时间占比更大
视频:让它在 CPU 上回答同一个长文问题
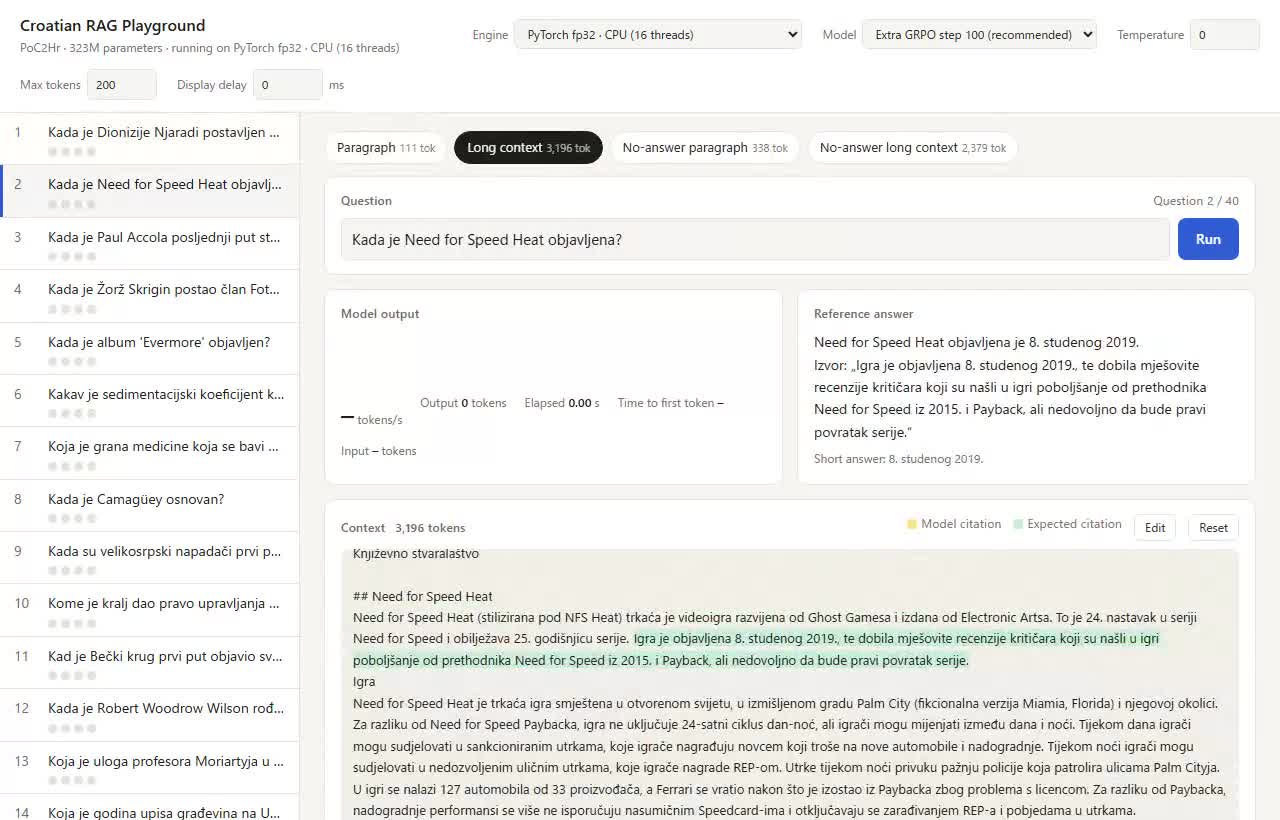
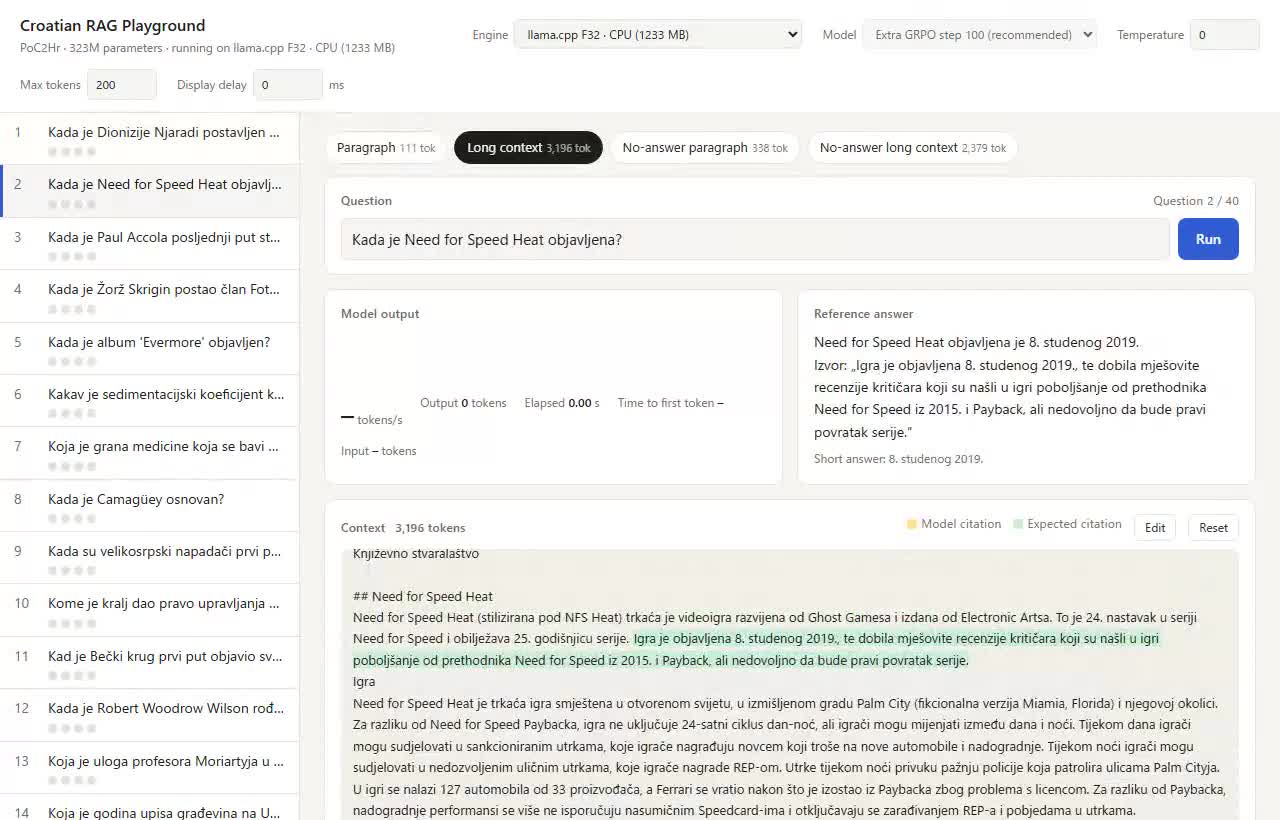
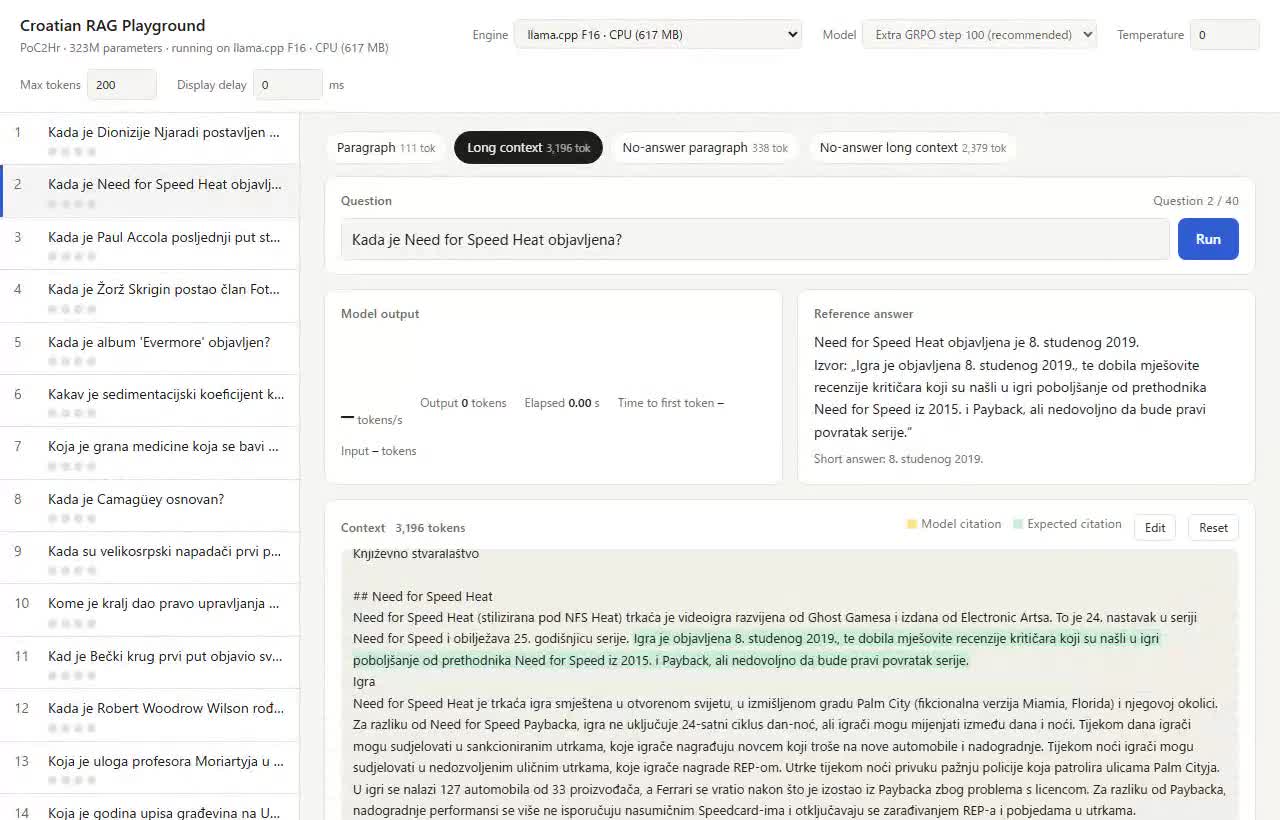
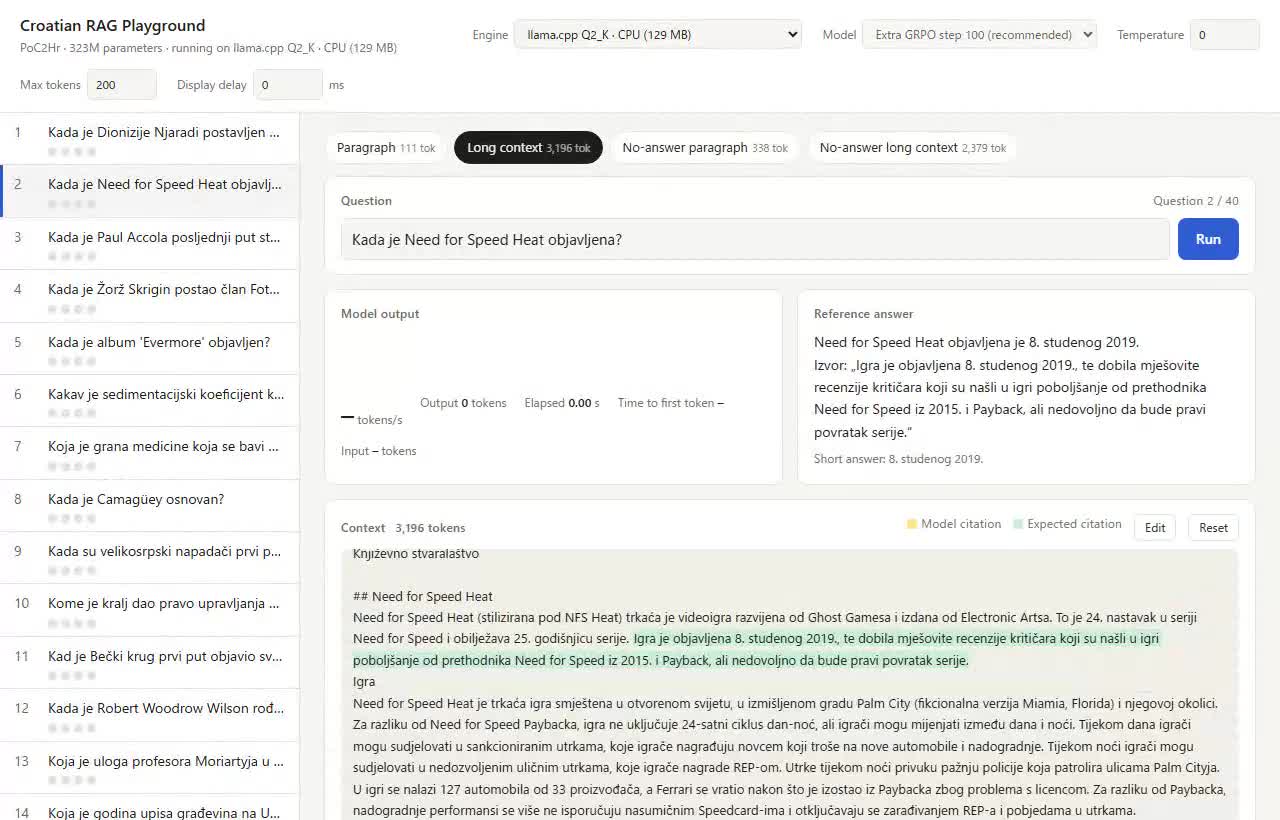
我给了模型一篇约 3,200 个 token 的文本,并问:“Need for Speed Heat 是何时发售的?”正确答案是 2019 年 11 月 8 日。
由于录制时还要在浏览器中渲染画面,视频中的速度比上表更慢。请将其视为便于并排比较的参考。
| 格式 | 视频中的生成速度 | 首字符出现前 | 总计 | 结果 |
|---|---|---|---|---|
| PyTorch fp32 | 5.5 tok/s | 4.8 秒 | 18.5 秒 | 正确 |
| F32 | 14.2 tok/s | 2.8 秒 | 8.1 秒 | 正确 |
| F16 | 25.9 tok/s | 3.5 秒 | 6.4 秒 | 正确 |
| Q8_0 | 38.2 tok/s | 4.0 秒 | 5.9 秒 | 正确 |
| Q6_K | 41.6 tok/s | 2.6 秒 | 4.4 秒 | 正确 |
| Q5_K_M | 46.3 tok/s | 2.6 秒 | 4.3 秒 | 正确 |
| Q4_K_M | 47.2 tok/s | 2.3 秒 | 4.7 秒 | 正确(答案较长) |
| Q3_K_M | 56.7 tok/s | 2.5 秒 | 4.5 秒 | 正确(答案较长) |
| Q2_K | 61.3 tok/s | 2.7 秒 | 2.8 秒 | 拒答 |
从 F32 到 Q5_K_M,答案和引用都与 PyTorch 版一字不差。Q4_K_M 和 Q3_K_M 的回答变长了,但引用是正确的。Q2_K 明明有答案,却拒答称“正文中没有答案”。
PyTorch fp32(原始模型)
llama.cpp F32(1,233MB)
llama.cpp F16(617MB)
llama.cpp Q8_0(329MB)
llama.cpp Q6_K(254MB)
llama.cpp Q5_K_M(223MB)
llama.cpp Q4_K_M(193MB)
llama.cpp Q3_K_M(160MB)
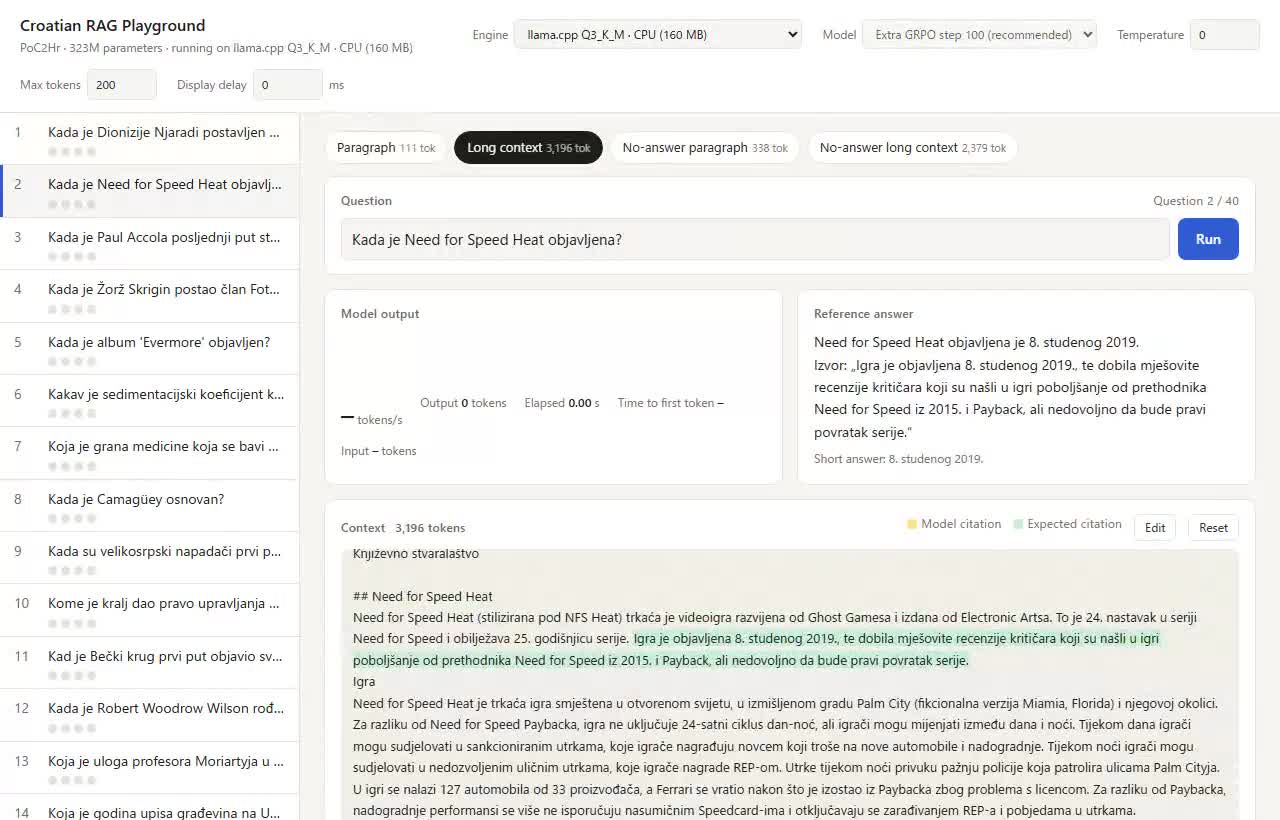
llama.cpp Q2_K(129MB)
思考
- 如果要在 CPU 上运行这个模型,就选 Q6_K。 准确性保持原样,体积降至 1/5,生成速度约为 PyTorch 的 5 倍,没有犹豫的理由
- 若想更稳妥,就选 Q8_0。 与原版几乎相同,只有 329MB,即使如此也足够小
- 3 亿参数的小模型不耐量化。 据说大模型即使使用 Q4 也几乎不会退化,但这次从 Q5 开始就出现了明显下降。模型本身余量不大,因此被压缩后影响明显
- 以“拒答”的方式失效是件好事。 对 RAG 而言,拒答比编造更安全。上次通过强化学习训练的拒答方式,在这里也发挥了作用
- 在小模型上,速度差距会缩小。 从 Q6_K 往下,即使生成更快,读取文本的时间仍然存在,体感变化不大。视频中 Q6_K~Q3_K_M 也都在 4 秒多
- Q4_K_M 为什么输给 Q3_K_M 仍然没有答案。希望通过增加题目数量,或查看各层如何被量化来进一步调查