图像与视频生成 AI 新闻 — 2026-09-20
开源阵营(尤其是来自中国的 Qwen、Wan、MiniMax-H3 等模型)正迅速成为闭源服务免费额度耗尽后的替代选择;但 X 阶段因搜索词无关而未能获取有效数据,因此本期实质上仅有 5 个平台的佐证。
图像与视频生成 AI 新闻汇总 ~闭源 vs 开源~ — 2026-09-20
嗨!这次我火速查看了 Reddit、X、YouTube、Bluesky、Lemmy 和 Pinterest 六个平台🔥🔥 先说结论:闭源阵营(Google Veo/Nano Banana、Sora 2、Midjourney、Kling、Seedance 等)依旧是新闻主角,“音画同步”正逐步成为标准功能;但开源阵营(尤其是中国的 Qwen、Wan、MiniMax-H3)正在以惊人的速度追赶,已明显成为免费额度用尽后用户的“避风港”🚀 另外一个不太显眼但很重要的发现是:对 AI 生成内容的反弹,在普通人聚集的社区里比在 AI 爱好者社区更强烈😤。不过坦白说,X 阶段完全扑空,因此这份报告实际上是建立在 5 个平台的数据之上🙏
跨平台观察
- 开源阵营的势头完全停不下来:Reddit(Wan、Minimax H3、Krea2 在多个帖子中被提及,是闭源免费额度耗尽后的替代方案)、Lemmy(
!stable_diffusion社区仅 9 月就密集发布了超过 15 个 MiniMax-H3 的 ComfyUI 工具)、YouTube(Qwen-Image→Qwen-Image-2512→Z-Image,Wan 2.5→2.6→2.7 几乎按月更新)都呈现出高度一致的趋势。开源几乎已成为“免费且高质量”的代名词💪 - 闭源视频生成,“带声音”正成为标配:Bluesky(Replicate 宣布的 Kling 3.0 同步音频、Seedance 2.0 音视频一体化)和 YouTube(Grok Imagine 1.5 同时生成对白与环境音)均证实了这一方向🎬🔊
- Google 的 Veo/Nano Banana 系列已成为闭源阵营的门面:Pinterest(Veo 温暖的皮克斯风格画面反复作为爆款图像出现)、YouTube(Theo - t3.gg 断言“Google 赢下了图像生成”)、Reddit(Google Flow 扩充免费额度引发讨论),三重印证很有分量👀
- 对 AI 生成内容的反弹正在“AI 圈外”爆发:Reddit(ArtPrize 接纳 AI 作品引发 354 分的愤怒、职场 AI 图片量产指标引发 63 分的哀号)、Lemmy(反 AI 社区
!fuck_ai月活 9,179 人,是 Lemmy 最大社区之一)、Pinterest(“真实还是 AI”的辨伪竞猜已成为独立类型)都传递出同样的氛围😨 - 一手信息更多经由“个人”而非企业官方传播:Bluesky 上企业官方账号几乎沉默,信息来源主要是 Simon Willison 等独立研究者和 Replicate 这样的托管服务商。YouTube 也由个人频道的每周汇总(AIPOD-CAST、Lev Selector)承担新闻来源角色。企业官方作为一手发布渠道不足,似乎是共同趋势📢
按平台观察
Reddit:从 9 个 subreddit 收集到 12 个帖子(未达到 20 条目标)。多个帖子反复提到开源方案(Wan、Minimax H3、Krea2)正在成为闭源免费额度耗尽后的替代选择;与此同时,GPT Image 2.5 Flare 的评价则在“incredible”派和“这不就和 Krea2 一样吗”派之间严重两极分化😂 最意外的是,最热烈的讨论不在 AI 技术社区,而是在普通社区(ArtPrize 反弹 354 分)和实务社区(设计师哀号 63 分)。
X:坦白说,这一阶段完全翻车了🙈 收集的 40 条内容只是在搜索“Greenland”“#Bitcoin”“Chelsea”等与连接来源地(克罗地亚周边)相关的通用趋势词,关于图像或视频生成 AI 的帖子为零。因此本期无法从 X 得出任何关于闭源或开源的发现。这是简报明确指定平台中的一个显著空缺🕳️
YouTube:查看了 12 支视频。闭源阵营(Theo、Astrovah、Woollyfern=专做 Midjourney 月度更新、FixNode)与开源阵营(Bijan Bowen、HitPaw、MaxonShire、Promptus AI)分工清晰:开源侧强调“ComfyUI”“本地运行”“免费”,闭源侧则主打品质与功能。不过搜索结果页面过度依赖 JS,几乎无法获取播放量和订阅数,确实很可惜😅
Bluesky:官方搜索 API 不断被 403 拦截,因此改为追踪独立研究者(Simon Willison、Max Woolf、Ethan Mollick)和 Replicate 官方的帖子。结果发现,收集到的内容几乎全部围绕闭源模型(GPT Image 2、Runway Gen-4.5、Kling 3.0、Seedance 2.0、Vidu Q3);没有发现活跃的开源社区账号(唯一看似相关的账号也在 2025 年 2 月停止活动)。另外,“鹈鹕骑自行车”的图像居然成了模型比较的固定梗,也颇有意思🐦🚲
Lemmy:开源和闭源的界线最清晰,整体也最均衡。开源侧包括 !stable_diffusion 社区的 MiniMax-H3 热潮与新模型 Boogu-Image-0.1(Apache-2.0、100 亿参数);闭源侧则有 Google Nano Banana 2 Lite、Microsoft MAI-Image-2.5、Sora 2 长篇故事实验,以及 Midjourney “转向医疗水疗”的惊人新闻😲 反 AI 社区 !fuck_ai(8,252 人)的存在感也是 Lemmy 特有的发现。
Pinterest:以查看预收集的 50 个 Pin 中 30 个、并包含图像确认的方式完成。闭源工具推荐清单和可重复利用的“AI NEWS”缩略图模板被大量生产,几乎看不到开源痕迹(仅发现一个本地工具 Amuse 3.0)。Google Veo 的画面被异常频繁地复用,“这是 AI 吗?是真实的吗?”的辨伪竞猜也已形成独立品类🎨
值得关注
- 面向 MiniMax-H3 的 ComfyUI 工具快速增加(Lemmy
!stable_diffusion,例如:https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS)— 有望成为开源视频生成的新主角🔥 - Sora 2 的“production memory”问题(Lemmy 经由 Reddit,https://lemmy.durstig.online/post/59922)— 相比单个片段,长篇内容的一致性维持可能成为下一道难关
- Google Nano Banana Pro 一骑绝尘的说法(YouTube、Theo - t3.gg,https://www.youtube.com/watch?v=UV9GqinedQ8)— 真到了“不需要 Photoshop”的水平?等待后续消息
- GPT Image 2.5 Flare 与开源 Krea2 的争议(Reddit,https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/)— 付费版的优势本身已开始受到质疑
- ArtPrize 接纳 AI 作品的问题(Reddit r/grandrapids,https://www.reddit.com/r/grandrapids/comments/1wi4ub0/)— 可能成为衡量社会接受边界的指标
- Midjourney 转向医疗水疗,以及好莱坞披露要求(Lemmy,https://lemmy.zip/post/66397234 、https://lemmy.today/post/56011946)— 企业可信度风险正在浮现
建议
- X 阶段应使用与主题直接相关的搜索词重新收集,例如 "Sora 2""Midjourney""Stable Diffusion""Runway Gen""Kling AI""open source image generation"。
- 将 MiniMax-H3、Qwen、Wan、Z-Image 等中国开源阵营的发布频率纳入每期观察清单。
- 持续追踪普通社区和实务社区的反应,而非只关注 AI 专业社区(因为反弹信号更强)。
- 在下次之前验证绕过 Bluesky 官方搜索 API 403 问题的方案。
- 下次运行时继续追踪 Sora 2 的“production memory”问题,以及 Midjourney 转向医疗水疗的后续发展。
- Pinterest 收集应加入类型标签,以便机械化区分开源/闭源内容。
数据质量
X 阶段的搜索词与主题无关(地缘政治、加密货币、足球等),因此收集的 40 条帖子中主题相关内容为 0,实际没有可用数据。Reddit(12 条)和 Bluesky(因搜索 API 被阻断,经由个人账号提取约 12 条)均未达到简报中“每个平台约 20 条”的完成标准。Pinterest 和 YouTube 也存在部分限制(Pinterest 未标注类型标签且没有实时浏览,YouTube 的播放量和订阅数因 JS 依赖无法获取),但总体而言仍获得了足够的信息。Lemmy 和 YouTube 相对稳妥,均能为开源/闭源两方提供具体发现。
按平台汇总
Reddit — 图像与视频生成 AI 新闻
来源
收集到的 12 个帖子来自 9 个 subreddit。
| subreddit | 成员数 | 收集帖子数 |
|---|---|---|
| r/generativeAI | 154,961 | 4 |
| r/graphic_design | 2,929,382 | 1 |
| r/GeminiAI | 375,783 | 1 |
| r/grandrapids | 161,719 | 1 |
| r/aitubers | 28,785 | 1 |
| r/ImagineAiArt | 19,335 | 1 |
| r/AIToolTalks | 6,757 | 1 |
| r/aifilmmaking | 8,200 | 1 |
| r/aivideomaking | 7,267 | 1 |
r/generativeAI 是讨论 AI 图像与视频生成本身的核心枢纽(4 条)。r/GeminiAI 和 r/ImagineAiArt 主要讨论闭源模型的使用体验;r/aifilmmaking 和 r/aivideomaking 关注视频制作实务;r/grandrapids 和 r/graphic_design 展现 AI 生成内容碰撞现实社会(艺术竞赛、职场)时的反应;r/AIToolTalks 则承接人们对 AI 整体的焦虑。
用户怎么说
- 帖子 1“Which AI video generator can still be used for free?”(r/generativeAI・18 分・57 条评论・2026-09-16)https://www.reddit.com/r/generativeAI/comments/1whtesl/ — 开源/本地生成(Wan、Minimax)已成为闭源免费额度耗尽后的替代方案。u/RioMetal:“如果你能在本地运行,可选的就很多,比如 Wan 或 Minimax。”
- 帖子 2“GPT Image 2.5 Flare — is this actually the best AI image generating model right now?”(r/ImagineAiArt・84 分・60 条评论・2026-09-16)https://www.reddit.com/r/ImagineAiArt/comments/1wi79wi/ — 评价严重分化。u/oldboi777 盛赞其为“惊人的升级”,而 u/SeaworthinessFresh16 则指出“ComfyUI 里用 Krea2 的结果看起来一样”。
- 帖子 12“Need a good video generation AI for image to video of people”(r/generativeAI・0 分・22 条评论・2026-09-15)https://www.reddit.com/r/generativeAI/comments/1wh1y9d/ — 帖子核心是不满闭源产品(Google Flow / Nano Banana Pro)的审查过滤。u/f5alcon 说“Minimax H3 是最好的本地生成器”,u/jworm0624 则推荐“图片用 Krea 2 turbo,视频用 minimax h3,全都在 comfyui 中运行”,均将开源阵营作为替代方案。
- 帖子 7“Google Flow is giving creators a surprisingly generous amount of free AI video generation right now”(r/aifilmmaking・8 分・7 条评论・2026-09-14)https://www.reddit.com/r/aifilmmaking/comments/1wg7izt/ — 闭源的 Google Flow/Veo 扩充免费积分,正从单纯的文本生成视频进化为可进行场景构建、镜头控制和素材引用的创作工作区。不过 u/MrBoondoggles 也冷淡表示:“Google 此时免费赠送 Veo 并不让我意外……他们是在努力维持人们对产品的兴趣。”
- 帖子 8“Did Anyone Notice Sudden Quality Drop of Image Generation? From 2 MB to 500 KB”(r/GeminiAI・10 分・25 条评论・2026-09-17)https://www.reddit.com/r/GeminiAI/comments/1wj02p4/ — 有人报告闭源 Gemini 的图像质量下降(PNG→JPEG、8MB→2MB→500KB),连付费方案用户也在抱怨。u/Well_HellooF:“免费版和付费版质量根本没差别。真糟。”
- 帖子 5“ArtPrize Allows Generative AI”(r/grandrapids・354 分・176 条评论・2026-09-16)https://www.reddit.com/r/grandrapids/comments/1wi4ub0/ — 艺术竞赛接纳 AI 生成作品引发强烈反弹。u/Chirotera(319 分)称:“令人作呕。这不是 AI ‘艺术’,而是偷窃。”普通社区的愤怒明显强于技术类 subreddit。
- 帖子 10“Company expects us to generate 500 AI images PER WEEK. Is this realistic?”(r/graphic_design・63 分・133 条评论・2026-09-17)https://www.reddit.com/r/graphic_design/comments/1wieke2/ — 一线设计师为使用闭源工具(ChatGPT)完成量产指标而叫苦。u/Diligent-Educator409(123 分):“500 张 AI 图片?可以。500 张好的 AI 图片?不行。1 张好的 AI 图片?也不行。”
- 帖子 9“best apps for generating AI videos”(r/aitubers・0 分・46 条评论・2026-09-14)https://www.reddit.com/r/aitubers/comments/1wg3duk/ — 虽然有人需要从脚本全自动生成视频的闭源工具(InVideo AI、Steve AI 等),但社区反应冷淡。u/RobJames007(15 分):“YouTube 正在减少 AI 垃圾内容,不是在让更多这类内容进入平台。”
- 帖子 3“Please help me generate free ai video without subscription”(r/aivideomaking・0 分・20 条评论・2026-09-15)https://www.reddit.com/r/aivideomaking/comments/1wh80z3/ — u/Chance-Business 表示“google flow 每天有 50 个免费积分,每支视频要 6–12 个积分”,而 u/Bastisheen92 表示“如果你已有硬件,本地生成就是免费的”,再现了闭源免费额度与开源本地运行之间的典型对比。
- 帖子 11“Are all of you also anxious about recent news about AI?”(r/AIToolTalks・12 分・36 条评论・2026-09-13)https://www.reddit.com/r/AIToolTalks/comments/1wfhbnv/ — 并非专门讨论图像或视频生成,而是围绕 AI 整体的水资源消耗、失业与监管焦虑展开;评论区意见针锋相对(u/Big-Pops78 弱化水资源担忧,u/UnburyingBeetle 则以讽刺“成本效率”一词作出反驳)。
信号
- 上升趋势:Wan、Minimax H3、LTX Video、Krea2 等开源/本地模型名,在多个独立帖子(1、2、12)中反复出现在相同语境:闭源免费额度耗尽后的替代选择。本地生成正成为“免费且高质量”的代名词。
- 被轻视或嘲讽:社区对宣传“免费”的闭源视频生成服务充满讽刺。多个帖子(1、4、6、12)中,机器人账号 u/Jenna_AI 反复发布大意相同的长篇讽刺评论:“号称免费,最终还是会让你付费”,体现了社区的犬儒氛围。
- 意外之处:普通社区(r/grandrapids,354 分、176 条评论)和实务类 subreddit(r/graphic_design,63 分、133 条评论)的互动量和评分,均高于 AI 技术类 subreddit(r/generativeAI 等,多数仅个位数至数十积分)。AI 生成内容撞上日常生活或工作时,反弹与讨论更大。
- 意见冲突:帖子 2 中,对 GPT Image 2.5 Flare 的评价在“惊人的升级”(u/oldboi777)与“和 Krea2 得到同样结果”(u/SeaworthinessFresh16)之间完全相反。帖子 7 对 Google Flow/Veo 也同时存在“免费积分很慷慨”的正面声音,以及“它的物理和逻辑很弱,连 Minimax 都好得多”(u/Sea-Temporary-6995)的负面评价。
限制
- 收集到的帖子仅有 12 条,未达到简报的完成标准(每个平台分析约 20 条帖子)。工作者收集的这 12 条已是 Reddit 当前可获得的全部数据;根据操作手册,本阶段无法再搜索或浏览 Reddit。
- 搜索词仅使用英文 “Image and Video Generation AI News”,没有迹象显示曾尝试日语查询,或“开源”“闭源”等按角度细分的搜索词。
- r/aitubers、r/aivideomaking、r/AIToolTalks 等部分 subreddit 仅收集到 1 条帖子,因此无法判断各自社区内部趋势的强弱。
X
X — 图像与视频生成 AI(闭源/开源)新闻
账号
本次 output/x.posts.md 收集到的 39 个账号、40 条帖子,全部与图像/视频生成 AI 无关。搜索词为 “Greenland”“Denmark”“#Bitcoin”“NATO”“Christ”“Jubjub”“Charles”“Bosnia”“Chelsea”“Belgrade” 共 10 个,直接来自 X 的 Explore 趋势(服务器连接来源被定位于克罗地亚周边),没有一个与研究简报中的图像/视频生成 AI 新闻相关。
因此,本次数据中不存在能够回答“谁在 X 上推动这一主题”的账号。仅记录实际收集到的内容:
- 政治/地缘政治集群:@RapidResponse47(30,291 个赞,格陵兰相关)、@AJENews、@Rusia_HD、@Globalsurv、@NepCorres 等,发布格陵兰、丹麦、NATO 相关突发新闻或观点。
- 加密货币集群:@aacryptoverse、@Bitcoin_Pirate_、@StackandRun、@bitcr_org 等,发布带 #Bitcoin 标签的帖子(赞数均在个位数到数十之间,规模较小)。
- 王室八卦集群:@barristerlawusa、@hernandez_64876、@thebluestshade、@Rimmesfk(“Charles”指查尔斯·斯宾塞的爆料书话题)。
- 足球集群:@icunga_、@john322226、@Cfc_Kemboi、@Pats_Aura(“Chelsea”指切尔西足球俱乐部的赛果)。
- 模因/闲聊集群:@SardineKing_O、@isellbeforeyou、@0xHeatt(关于名为 “$jubjub” 的加密模因币)、@MarquiseDeBelgr(两条塞尔维亚语闲聊帖)。
每个账号仅有 1–2 条帖子,没有明显高频连发账号。@RapidResponse47 的一条帖子(3 万赞、约 680 万浏览)在该样本中表现突出,但内容是关于格陵兰归属问题,与本主题无关。
帖子
在收集的 40 条内容中,提到图像或视频生成 AI(闭源/开源)的帖子为0 条。因此没有可作为“代表性帖子”呈现的内容。仅供参考,以下列出互动量最高的一条,用以说明收集内容的性质(明确与主题无关):
- @RapidResponse47(主题外,仅供参考)— 30,291 个赞・5,022 次转发・1,164 条回复・约 6,800,000 次浏览・2026-09-18。https://x.com/RapidResponse47/status/2101059494587285834 通过“Greenland”搜索命中。内容是围绕格陵兰归属的政治帖子,与 AI 图像或视频无关。
信号
- 本次 X 阶段中,收集数据里完全没有涉及图像/视频生成 AI(Midjourney、Sora、Runway、Stable Diffusion、Flux、Wan、Kling 等)的讨论、新闻或提及。因此也不存在判断“是否正在走红”的材料。
- 收集所用搜索词(Greenland、Denmark、#Bitcoin、NATO、Christ、Jubjub、Charles、Bosnia、Chelsea、Belgrade)与
output/x.posts.md开头的 “X's own Explore list” 标题词完全一致,显然只是搜索了该会话连接来源(克罗地亚周边)的 X 全站趋势,包括地缘政治新闻、王室八卦、足球和加密货币模因。没有一次使用主题相关的搜索词(图像生成 AI、视频生成 AI、Sora、Midjourney、Stable Diffusion、开源 AI 等)。 - 因此,无法从本阶段为“闭源趋势”或“开源趋势”抽取哪怕一条发现。
限制
- 收集本身与主题不匹配。
output/x.posts.md使用的 10 个搜索词均与图像/视频生成 AI 无关,只是在追踪地缘政治、王室八卦、足球和加密货币模因等 Explore 趋势。由于工作者从未围绕主题(闭源/开源的图像与视频生成 AI 新闻)进行搜索,X 阶段的完成标准——分析约 20 条帖子并汇总——就“主题相关帖子”而言并未达成。 - 虽然分析了 40 条帖子,但其中提及图像或视频生成 AI 的帖子为零。
output/x.posts.json也是同一批数据,没有提供额外线索。- 对本次 X 阶段,唯一能得出的结论是:从所收集的搜索词和帖子中,无法报告任何 X 上关于图像/视频生成 AI 的闭源或开源趋势。必须针对主题重新收集(例如使用 “Sora 2”“Midjourney”“Stable Diffusion”“Runway Gen”“Kling AI”“Flux”“open source image generation” 等搜索词)。
YouTube
YouTube — 图像与视频生成 AI(闭源/开源)的最新动态
频道
偏闭源
- Theo - t3.gg(@t3dotgg)— Google Nano Banana Pro 技术解析
- Astrovah(@astrovah)— Sora 2 评测与使用案例
- Woollyfern(@woollyferncreative)— 专注 Midjourney 月度更新的频道
- FixNode(@Fixnode1)— Runway Gen-4.5 教程
- Higher E-Learning(@higherelearning)— Adobe Firefly 整合模型测试
- AIPOD-CAST(@AIPOD-CAST)— 每周 AI 新闻汇总(第 220 多期)
- Lev Selector(@lev-selector)— 每周 AI 更新汇总
偏开源
- Bijan Bowen(@Bijanbowen)— Qwen Image 本地测试
- HitPaw Edimakor(@HitPawEdimakorOfficial)— Wan 系列评测与用法
- MaxonShire(@MaxonShire)— 开源视频模型对比测试
- Promptus AI(@promptusai)— Z-Image 等新模型的本地部署指南
- 黎黎原上啃 / SweetValberry(@SweetValberry)— FLUX.1 Kontext 等中文解说
所有频道页面均未能获取订阅数(见下方限制),因此无法确认其规模。
视频
-
“Google won image generation (it's not even close) NANO BANANA PRO BREAKDOWN” — Theo - t3.gg/发布日期不明(Nano Banana Pro 本身于 2025 年 11 月 20 日发布,视频在此之后)/播放量不明
https://www.youtube.com/watch?v=UV9GqinedQ8
认为基于 Gemini 3 Pro 的 Nano Banana Pro 图像生成质量已达到“不需要 Photoshop”的程度,在闭源阵营中明显领先。 -
“Sora 2 - An Honest Review As Well As 20 Creative Use Cases To Try” — Astrovah/2025 年 10 月 7 日/播放量不明
https://www.youtube.com/watch?v=pJHWIgri5vk
将 Sora 2 评价为“至今最逼真的 AI 视频”,并介绍 20 种实务使用方式。 -
“Midjourney Update | July 2026: V8.2 is HERE! Personalization, NIJI Style Creator, and More!” — Woollyfern/2026 年 7 月/播放量不明
https://www.youtube.com/watch?v=dvfH5HzCARY
说明 Midjourney V8.2 增加了个性化功能和面向 NIJI 的风格创作者,是月度系列的近期一期。 -
“I Tested Every AI Video Model in Adobe Firefly So You Don't Have To (July 2026)” — Higher E-Learning/2026 年 7 月/播放量不明
https://www.youtube.com/watch?v=nOSYufWVdq8
随着 Veo 3.1、Kling 3.0、Runway Gen-4.5、Sora 2 整合进 Adobe Firefly,视频横向测试了全部模型。 -
“Ultimate Runway Gen 4.5 Tutorial For New Users in 2026” — FixNode/2026 年 3 月 29 日/播放量不明
https://www.youtube.com/watch?v=IUge3u4ZrqQ
以教程形式介绍 Runway Gen-4.5 的图像转视频生成,并强调其电影感质感。 -
“Episode 222: Weekly AI News Summary - 6 September 2026” — AIPOD-CAST/2026 年 9 月 6 日/播放量不明
https://www.youtube.com/watch?v=8f34nSLdNtk
跨模型、智能体和商业动态的每周汇总,其中也提及图像/视频生成 AI 新闻。 -
“Exciting AI Updates Weekly - September 18, 2026” — Lev Selector/2026 年 9 月 18 日/播放量不明
https://www.youtube.com/watch?v=Utu4zIcqPtM
个人频道对最近一周 AI 更新的快速汇总,是本次研究范围内最新的帖子。 -
“Qwen Image-2512 First Test – The BEST Open Source Image Model!” — Bijan Bowen/发布日期不明(模型本身为 2025 年 12 月版)/播放量不明
https://www.youtube.com/watch?v=SBaK616nP6Q
对阿里巴巴 Qwen-Image-2512(200 亿参数)进行本地实测,并评价为“目前最强的开源图像模型”。 -
“Wan 2.6 Review | How to Use Wan 2.6 for Free | New AI Video Generator Tutorial” — HitPaw Edimakor/发布日期不明(模型于 2025 年 12 月发布)/播放量不明
https://www.youtube.com/watch?v=6FMisTHYYgA
介绍阿里巴巴 Wan 2.6 的免费使用方法和评测,涉及 T2V/I2V/R2V 等多种模式。 -
“HunyuanVideo 1.5 vs Wan 2.7 Comparison: Which is The Best Free Local Video AI Generation Model?” — MaxonShire/2026 年 6 月 25 日/播放量不明
https://www.youtube.com/watch?v=4GNT4-QYekg
直接对比腾讯 HunyuanVideo 1.5 和阿里巴巴 Wan 2.7(2026 年 4 月 22 日发布)这两大免费本地视频模型。 -
“Z-Image Open-Source Image Generator: Free Online and Local Setup” — Promptus AI/2026 年(具体日期不明)/播放量不明
https://www.youtube.com/watch?v=JF4Q5hXh-_Q
介绍阿里巴巴 Z-Image(60 亿参数、S3-DiT 架构),称其虽轻量却拥有超过 Flux 2 和 Qwen Image 的画质,并讲解 ComfyUI 集成。 -
“FLUX.1 Kontext [dev] is open source! Try image editing locally in ComfyUI” — 黎黎原上啃/2025 年(Flux Kontext Dev 发布后不久)/播放量不明
https://www.youtube.com/watch?v=v4pp3TdbWNw
在 Black Forest Labs 发布 Flux Kontext Dev 模型权重后,演示如何通过 ComfyUI 在本地进行图像编辑。虽然较早,但为理解开源图像编辑的演进脉络而收录。
信号
- 闭源阵营把“月度更新”变成了惯例:Midjourney 的 “Update” 系列(Woollyfern)每月发布更新视频,2026 年以来从 V8 到 V8.1 再到 V8.2 持续迭代。Runway 和 Adobe Firefly 也是如此,科技频道会立即评测其数月一次的大型更新。
- 音画同步正成为闭源视频生成的标准功能:Kling 3.0(5 种语言的原生对话)、Seedance 2.0(音视频一体架构,连混响也可还原)、Grok Imagine 1.5(同时生成对白和环境音)等多个搜索结果均强调“同时生成声音和影像”的设计,竞争重点正在从单一视频生成转向“带声音的短片生成”。
- 开源阵营,尤其是中国模型,发布速度已能匹敌甚至超过闭源阵营:仅阿里巴巴体系就有 Qwen-Image→Qwen-Image-2512→Z-Image、Wan 2.5→2.6→2.7 的快速更新;腾讯 HunyuanVideo 1.5、Lightricks LTX-2→2.3→2.5 也以近乎月度或季度节奏演进。视频标题中频繁出现“最强开源”“击败某某”等措辞,显示观众兴趣很高。
- 大多数开源视频内容都围绕“ComfyUI”“本地运行”“免费”展开:HitPaw Edimacor、Promptus AI、MaxonShire 等频道均将“免费使用方法”“可在本地 GPU 运行”置于突出位置,这与闭源频道(Theo、Astrovah、Woollyfern 等)侧重品质和功能评测形成对照。
- 每周 AI 新闻形式的频道(AIPOD-CAST、Lev Selector)已将图像/视频生成 AI 固定为常规栏目,说明它们不是孤立新闻,而是持续观察对象。
限制
- YouTube 搜索结果页(
https://www.youtube.com/results?search_query=…)由 JavaScript 动态渲染,使用 WebFetch 时仅获取到页脚导航链接,无法按操作手册预期从页面 HTML 读取标题、频道、播放量和发布日期。 - 因此改用常规网页搜索(
site:youtube.com查询)发现视频,并通过 YouTube 的oembed端点确认标题与频道名。该方法无法获取播放量或频道订阅数,因此上方“视频”清单均标为“播放量不明”(没有猜测或编造)。 - 同样因为上述原因,部分视频的准确发布日期无法确认(Nano Banana Pro 解析、Qwen Image-2512 测试、Wan 2.6 评测、Z-Image 介绍)。仅依据搜索引擎摘要和相关模型发布时间写出大致时期。
- 由于页面依赖 JS,也未能直接阅读视频说明栏和置顶评论。
- 优先选择 60 天内(2026 年 7 月 22 日之后)的帖子,但也纳入了 Flux Kontext、Runway Gen-4.5 教程等 1–2 支超出时段的视频,以帮助理解开源和闭源各自的演进脉络。
Bluesky
Bluesky — 图像与视频生成 AI 的最新动态
账号
- Simon Willison (@simonwillison.net) — 独立 AI 研究者。每当有新的多模态模型推出,都会用自制的“鹈鹕骑自行车”图像基准测试其图像生成能力。约 5 万关注者,发帖频繁。
- Max Woolf (@minimaxir.bsky.social) — 前 BuzzFeed 数据科学家,熟悉 AI 内容生成伦理与研发,经常发布对图像生成模型发布的反应。
- Ethan Mollick (@emollick.bsky.social) — 沃顿商学院教授。在讨论 AI 总体趋势时,也会提及 AI 视频生成品质的变化。
- Replicate (@replicate.com) — 模型托管服务官方账号。每当新的闭源图像或视频生成模型上线其平台时都会公告。
- Stability AI (@stabilityai.bsky.social) — Stable Diffusion 开发方的官方账号。但近期内容主要为 Stable Audio(音频生成)和企业图像编辑 API,自 2025 年 11 月 19 日起停止发帖。
- Stable Diffusion online AI (@stablediffusion.bsky.social) — SDXL/ComfyUI 提示词分享与 AI 艺术汇总账号(约 1,800 名关注者),自 2025 年 2 月 24 日起停止更新。
- AI Art News (@ai-art-news.bsky.social) — AI 艺术相关新闻聚合账号,自 2025 年 9 月 18 日后未再发帖。
帖子
-
Simon Willison(2026-09-19)— 在让 GPT-6 Astra 和 Claude Fable 5.1 使用地图数据生成 Blender 3D 模型的一系列帖子中,介绍了图像生成→3D 转换工作流。57 个赞・5 次转发。
https://bsky.app/profile/simonwillison.net/post/3mv4su6pfzk24 -
Simon Willison(2026-09-05)— 测试 GPT-6 Astra 让其在 Blender 中渲染鹈鹕骑自行车的场景。405 个赞・30 次转发。
https://bsky.app/profile/simonwillison.net/post/3murtmdynq22s -
Simon Willison(2026-09-04)— 将 GPT-6 Astra、GPT-5.6 Sol/Terra/Luna 并列的“鹈鹕骑自行车”图像生成基准对比网格。206 个赞・9 次转发。
https://bsky.app/profile/simonwillison.net/post/3mupxubgrls2c -
Simon Willison(2026-09-02)— 使用 Claude Fable 5.1(最高思考等级,单次 $3.30)生成迄今质量最高的 SVG 鹈鹕图像,并进一步制作动画。362 个赞・22 次转发。
https://bsky.app/profile/simonwillison.net/post/3muimzxo2sk2g -
Max Woolf(2026-09-19)— 指出让图像生成 AI 制作矢量风格的“鹈鹕骑自行车”图时,模型仍不理解腿和踏板的关系。1 个赞。
https://bsky.app/profile/minimaxir.bsky.social/post/3mvtt3uxdrk2c -
Max Woolf(2026-09-08)— 针对 OpenAI 新图像模型发布评论称:“幸好我推迟了 ChatGPT Images 2.0 的汇总文章,这个看起来更重要。”(指 ChatGPT Images 2.5 的发布)。4 个赞。
https://bsky.app/profile/minimaxir.bsky.social/post/3muzq6mcadk2n -
Ethan Mollick(2026-09-19)— 指出,在大量低质量、批量生产的“垃圾内容”洪流中,真正有趣的 AI 视频作品也开始出现。58 个赞・7 次转发。
https://bsky.app/profile/emollick.bsky.social/post/3mvuss476oc2b -
Replicate(2026-04-21)— OpenAI 的“GPT Image 2”上线 Replicate,介绍其写实性、文本渲染和版式遵循能力。5 个赞。
https://bsky.app/profile/replicate.com/post/3mjzygaefs224 -
Replicate(2026-04-09)— 字节跳动视频生成模型“Seedance 2.0”向全部用户开放。整合文本、图像、视频和音频,支持同步立体声音频和真实物理模拟。2 个赞・1 次转发。
https://bsky.app/profile/replicate.com/post/3mj3junhvnh26 -
Replicate(2026-02-18)— 公告 Runway“Gen-4.5”发布。主打物理准确性与写实感的电影化视频生成。2 个赞。
https://bsky.app/profile/replicate.com/post/3mf5fbf6u4l2c -
Replicate(2026-02-17)— Kuaishou 的“Kling 3.0”与“Kling o3”上线 Replicate。支持多镜头 4K 生成、同步音频、视频编辑和风格迁移。2 个赞。
https://bsky.app/profile/replicate.com/post/3mf35lkhoyw2q -
Replicate(2026-03-11)— Shengshu 的“Vidu Q3”上线 Replicate。支持最长 16 秒、1080p、带同步音频的文本/图像/首尾帧视频生成。1 个赞。
https://bsky.app/profile/replicate.com/post/3mgsan3ddpl2w
信号
- 闭源占优:在 Bluesky 上实际找到的相关帖子,几乎都围绕 OpenAI(GPT Image 2 / ChatGPT Images 2.5)、Runway(Gen-4.5)、Kling(3.0)、Seedance(2.0)、Vidu(Q3)等大型闭源模型。这些并非自然爆红的帖子,而主要通过 Replicate 等模型托管商的新模型公告,或 Simon Willison、Max Woolf 等个人 AI 研究者的测试帖子传播。
- 几乎没有开源踪影:没有找到活跃账号在发布 Flux、Stable Diffusion、Qwen-Image、Wan、ComfyUI 工作流等开源话题。唯一看似相关的社区账号(stablediffusion.bsky.social)在 2025 年 2 月后停止活动;Stability AI 官方也在 2025 年 11 月后沉默,且近期内容主要是 Stable Audio 和企业 API,而不是 Stable Diffusion 图像模型。
- “鹈鹕骑自行车”成为事实上的基准:每当 GPT-6 Astra、Claude Fable 5.1 等新多模态模型出现,多位独立 AI 观察者都会使用同一题目比较图像生成质量。这是 Bluesky 特有的圈内梗,正成为衡量模型能力的非官方共同指标。
- 企业官方账号缺席:OpenAI、Midjourney、Runway ML、Black Forest Labs、Hugging Face、Civitai、ComfyUI 等主要品牌的预期账号,要么不存在,要么是未使用、零发帖账号。换言之,Bluesky 并非这些公司的第一手发布渠道,新闻只能经由个人研究者或 Replicate 这样的中间平台传播。
- 对视频生成的评价正在变化:正如 Ethan Mollick 的帖子所示,人们开始认为“在批量生产的 AI 视频垃圾内容中,确实开始混入真正高质量的作品”。但这仍是总体性评价,并非针对任何特定开源视频模型。
限制
- Bluesky 官方搜索 API(
https://public.api.bsky.app/xrpc/app.bsky.feed.searchPosts)无论如何更换关键词,或通过两种 CORS 代理尝试,始终返回 HTTP 403 Forbidden,完全无法访问。https://bsky.app/search?q=...的网页界面也是客户端渲染 SPA,因此 WebFetch 无法提取内容。 - 作为替代,使用无需认证且可正常工作的
app.bsky.actor.getProfile与app.bsky.feed.getAuthorFeed端点,逐个获取通过 WebSearch 或推测发现的账号动态。因此本次结果并非“对 Bluesky 全站进行关键词横向搜索”的结果,而仅限于所发现账号的帖子。 - 主要品牌(OpenAI、Midjourney、Runway ML、Black Forest Labs、Hugging Face、Civitai、ComfyUI,以及部分 Stability AI)的官方账号未使用或保持沉默,无法直接从中获取新闻。
- 由于无法搜索,未能以明确相关的主题帖子满足简报要求的“分析约 20 条帖子”。在阅读 7 个账号、总计 100 多条帖子后,筛选出其中直接相关的 12 条列出。
- 未显示或确认实际图像和视频,仅以帖文文字说明作为信息来源。
Lemmy
Lemmy — 图像与视频生成 AI 的最新动态(闭源/开源)
社区
- !«メールアドレス» — 5,712 名订阅者(其中本地 893 人)、1,407 个帖子、1,927 条评论。讨论开放权重图像/视频生成模型。日活 10 人、月活 66 人,规模虽小但更新活跃。
- !«メールアドレス» — 2,362 名订阅者,日活 24 人/周活 114 人/月活 344 人。发布由 Stable Diffusion 开放权重模型生成的作品(大多数直接链接至 civitai 图片)。
- !«メールアドレス»(社区名
share_anime_art,显示名“Stable Diffusion Anime”)— 1,598 名订阅者(本地 206 人)。仅限 SFW 的动漫 AI 生成插画社区。 - !«メールアドレス» — 8,252 名订阅者(本地 3,027 人),月活 9,179 人,是本次观察中规模最大的社区之一。以“所有厌恶 AI 者的聚集地”为宗旨,主要讨论和讽刺 AI 整体,而不局限于图像/视频生成 AI。
- !«メールアドレス» — 订阅者仅 52 人(规模很小),但通过 RSS 镜像 r/ArtificialInteligence 等 Reddit 帖子,图像/视频生成 AI 话题出现频繁。半年活跃人数 725 人。
- !«メールアドレス»・!«メールアドレス»・!«メールアドレス» — 通用科技社区。Midjourney 相关的大型新闻出现在这些社区中。
帖子
- 面向 MiniMax-H3 的 ComfyUI 工具在 9 月迅速增加(开源)— 在
!«メールアドレス»中,仅 2026-09-01 至 09-16 期间就确认至少有超过 15 条针对 MiniMax-H3(视频生成模型)的工具帖子。代表例子:- “ComfyUI-MiniMaxH3-CLSS” — 在消费级 16GB VRAM 上生成任意时长、带音频的视频(score 0,2026-09-01)https://github.com/nazgut/ComfyUI-MiniMaxH3-CLSS
- “H3-World” — 宣称是基于 MiniMax-H3 的“世界首个交互式世界模型”(score 3,2026-09-02)https://huggingface.co/DANNY621/H3-World
- “ComfyUI-VDN-H3-24GB” — 面向 24GB GPU 的混合注意力实现(score 6,2026-09-12)https://github.com/Speach1sdef178/ComfyUI-VDN-H3-24GB
- “MiniMax-H3-Image-Training-Adapter”(Circlestone Labs,score 5,2026-09-12)https://huggingface.co/circlestone-labs/MiniMax-H3-Image-Training-Adapter
- Boogu-Image-0.1 — 华为系实验室的新开源图像基础模型(开源)—
!«メールアドレス»,score 5,2026-06-17。采用 Apache-2.0 许可证,100 亿参数,提供 Base/Turbo(3–4 步)/FP8/Edit 等 5 个变体;主打中英双语文字绘制。https://boogu.org/ - Seedream 5.0 Pro(字节跳动系闭源模型)的技术评测文章(闭源)— 经由
!«メールアドレス»,score 1,2026-07-10。标题为“诚实对比与技术拆解”的评测帖子。https://www.reddit.com/gallery/1usc03q - Google 发布“Nano Banana 2 Lite”(闭源)— Hacker News 镜像,score 1,2026-06-30,链接至 DeepMind 官方页面。瑞士科技媒体以德语报道的帖子也同步出现(score 0,swisstechnews,2026-07-02)。https://deepmind.google/models/gemini-image/flash-lite/
- Microsoft MAI-Image-2.5 在基准测试中逼近 Nano Banana 2(闭源)—
!«メールアドレス»,score 1,2026-05-28。围绕 Google 与 Microsoft 图像生成模型竞争的帖子。https://www.reddit.com/r/ArtificialInteligence/comments/1tpu2cd/ - 用 Sora 2 制作长篇故事的实验记录(闭源)—
!«メールアドレス»,score 1,2026-09-13。在“Sora 2 发布约一个月”时开始使用,记录制作 7 支一小时视频的过程。其发现是:“制作漂亮的单一片段本身并不难;真正困难的是 ‘production memory’(一致性的维持)。”https://lemmy.durstig.online/post/59922(原 Reddit:https://www.reddit.com/r/ArtificialInteligence/comments/1wfabp9/) - Midjourney 从“AI 图像生成”大胆转向“医疗水疗”的真实新闻(闭源/公司动态)—
!«メールアドレス»(The Register 文章,在 lemmy.zip 交叉发布,score 58–66,2026-06-18)。报道其转向全身扫描“Golden Light”水疗业务,且底层技术来自合作方授权;评论区充满将其比作 Theranos 的讽刺。https://lemmy.zip/post/66397234 - Midjourney 要求好莱坞制片厂披露 AI 使用情况(闭源)—
!«メールアドレス»,score 73,2026-07-05。作为版权诉讼相关动态报道。https://lemmy.today/post/56011946 - InterleaveThinker 论文介绍(开源/研究)—
!«メールアドレス»,score 0,2026-06-12。链接至题为“Reinforcing Agentic Interleaved Generation”的 arXiv 论文。https://arxiv.org/abs/2606.13679 - 对 AI 生成内容反弹的温度(社会信号)—
!«メールアドレス»,score 923,2026-09-13。虽非直接讨论图像/视频生成,而是讨论 AI 智能眼镜(Ray-Ban Meta),但该社区的规模(月活 9,179 人)和强烈反应可作为图像/视频 AI 所面临“逆风”的旁证。https://lemmy.world/post/51874921
信号
- 开源侧几乎被“MiniMax-H3”占据。lemmy.dbzer0.com 的
!stable_diffusion社区在 9 月前半连续发布 MiniMax-H3 的 ComfyUI 节点、LoRA、量化和 VAE 加速工具;Wan/Flux/HunyuanVideo 等旧一代模型名几乎已不再出现在搜索结果中。大量一手发布者为 GitHub 个人账号,也显示出以 Hugging Face/civitai 为中心的草根生态。 - 闭源侧则有 Google(Nano Banana 系列)、Microsoft(MAI-Image)、ByteDance(Seedream)、OpenAI(Sora 2)、Midjourney 五家公司并行,但 Lemmy 上的提及量不高(评分普遍个位数),话题主流仅通过 Reddit 镜像(
!ai_reddit)流入。Lemmy 原生的一手讨论更偏向 Midjourney “转向医疗水疗”这样的公司动态新闻。 - civitai 直链作品帖(stable_diffusion_art / share_anime_art)很活跃,但较少提及模型名或提示词细节,从新闻性而言仍只是“素材”。
- 反 AI 情绪社区(
!fuck_ai)在 Lemmy 整体中规模很大,图像/视频生成 AI 相关帖子一旦流入,反对评论往往压过中立或赞同意见。
限制
- Lemmy 用户基数较小,搜索 API 还会返回大量旧帖(如 2025 年 3 月的 HunyuanVideo-I2V)或无关结果(仅搜索“Flux”时会大量命中 Fluxnium 公司核燃料创业报道等),因此需按关键词手动去除噪音。
- 曾分别搜索
Runway Gen、Kling AI、Wan 2.5,但没有发现与图像/视频生成 AI 直接相关的帖子(Kling 为零、Runway 为零、Wan 仅有无关帖子)。本次未能确认 Lemmy 上围绕这些模型的独立热度。 !«メールアドレス»是 Reddit RSS 转发机器人,并非 Lemmy 原生讨论;应注意它只是把 Reddit 热门内容原样流入(本报告已注明来源,并只采用不与 Reddit 阶段重复的独特发现)。- Midjourney 转向医疗水疗和要求好莱坞披露 AI 使用的新闻,发布日期分别为 2026-06-18 和 2026-07-05,并非最近一周的事件(未发现 Lemmy 上较新的后续报道)。
- 虽按约 20 条帖子的目标进行筛选,但评分超过两位数的“爆款”帖子只有 Midjourney 转向医疗水疗的新闻和
!fuck_ai的智能眼镜帖子;本次未能确认 Lemmy 社区内单独围绕图像/视频生成 AI 的话题大规模走红。
Pinterest — 图像与视频生成 AI 新闻
直接打开并阅读了收集到的 50 个 Pin 中的 30 个(均使用 Read,包含图片)后撰写本汇总;其余 20 个标题(大多是通用“AI 内容创作概念”图库条目以及重复的工具汇总图)因其标题已符合下文确认的主题而未打开。
视觉主题
- “AI 新闻”YouTube 缩略图模板占据主导:黑色/深蓝背景、一张带有惊讶眉毛或大笑表情的人脸、醒目的白色/红色 “AI NEWS” 文字,以及一排发光的品牌徽标(OpenAI、Google、Anthropic 橙色标志、Meta、Microsoft、Notion)。在不相关主题间反复出现,有时标题与图片内容并不相符——图片是可复用频道模板,而非定制艺术。
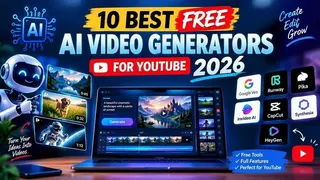
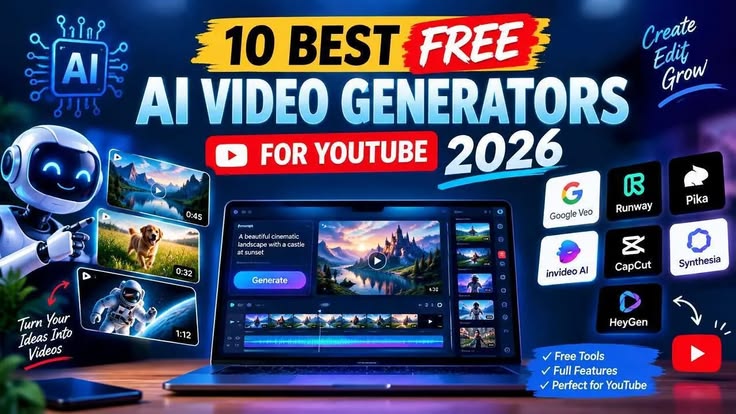
[6, 14, 41, 43, 47] - 工具汇总列表使用同样的暗色霓虹信息图语言:编号徽章(紫色/橙色/青绿色)、带生成界面的笔记本模拟图、以及竞争应用标志网格——Runway、Pika、Kling AI、Luma/Dream Machine、Canva、Hailuo、invideo AI、CapCut、Synthesia、HeyGen。所列工具全部是闭源 SaaS。
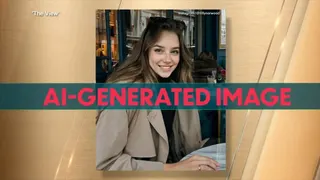
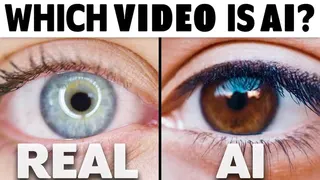
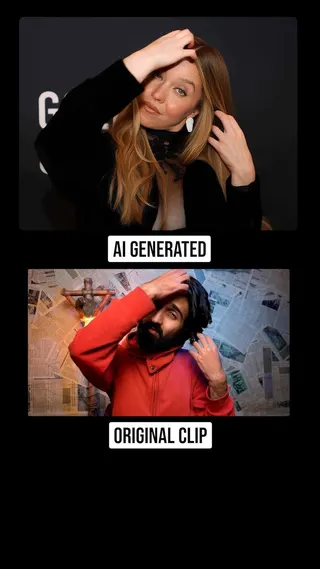
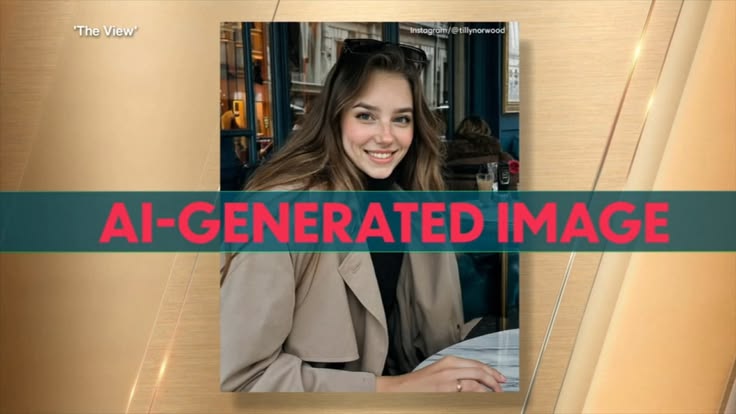
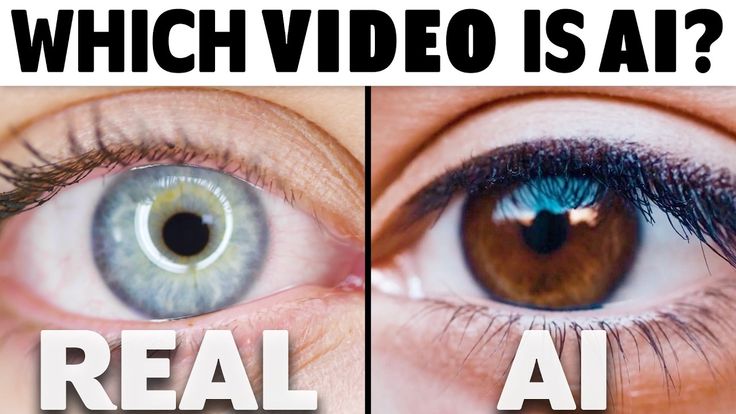
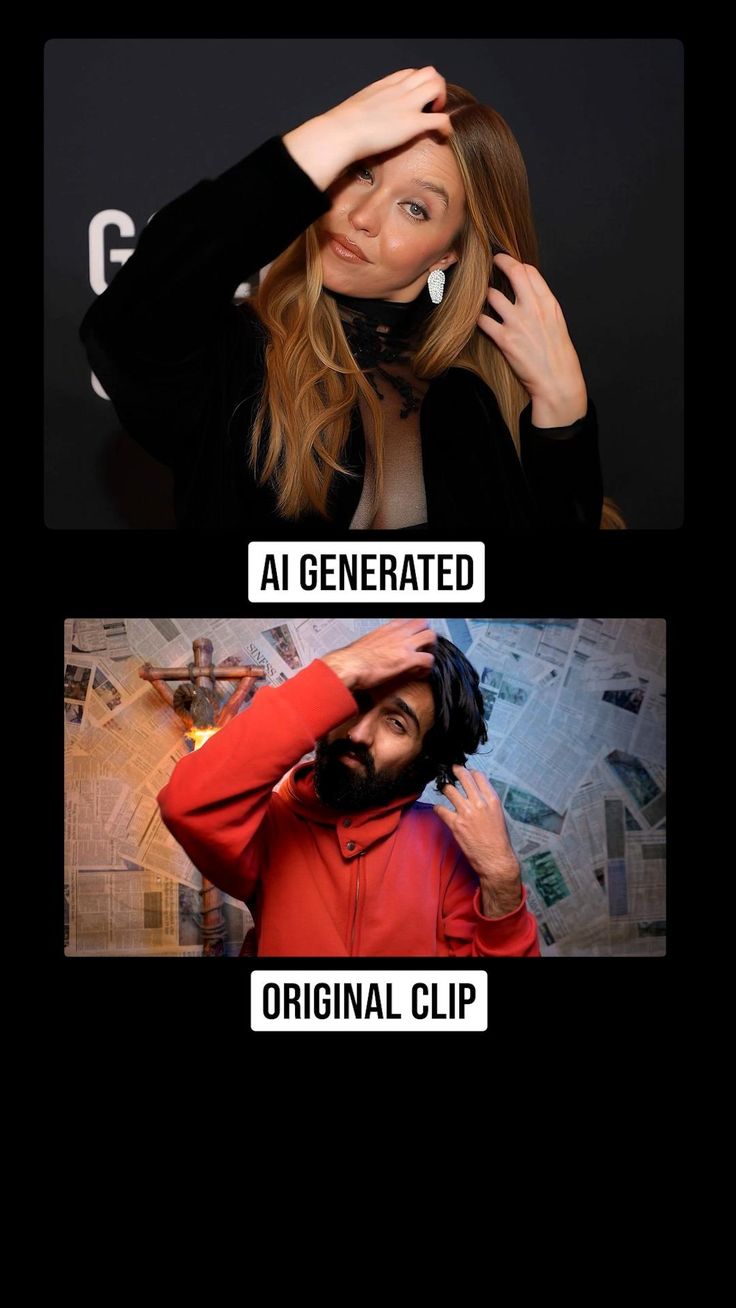
[2, 29] - “真实 vs AI”的真实性焦虑已成为独立的重复内容形式:并排竞猜图(“哪个是 AI?”)、盖在照片上的红色 “AI-GENERATED” 标签,以及模因式的 “AI GENERATED / ORIGINAL CLIP” 对比。这一类型的普遍程度不亚于新闻缩略图本身。
[3, 21, 32] - Google Veo 提供了默认的“电影感 AI 视频”视觉语言:同样的温暖皮克斯风静帧(厨房中的女孩、火烈鸟、星空下的舞者、游泳者、显微镜前的科学家)在多个独立 Pin 中重复出现,另有一张 Veo 3 毛绒怪物图生视频演示。没有其他竞争者的演示片段出现得如此频繁。
[8, 9, 13, 27] - 超写实 AI 肖像被当作通用诱饵图使用,无论文章实际主题为何——工具公告配满脸皱纹的渔夫、新闻汇总卡配闪亮皮肤的女性侧脸、新奇应用配人脸变形三联图。皮肤毛孔、高光和浅景深表明它们本身就是 AI 生成的。
[33, 45, 48, 20] - 当没有真实产品截图时,通用科幻/电路板图库图会填补空白:发光线框大脑、镀铬人形机器人、面对全息 AI 仪表盘的西装商人。这些没有新闻价值,只负责营造氛围。
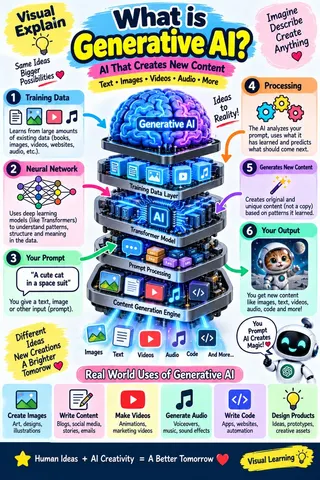
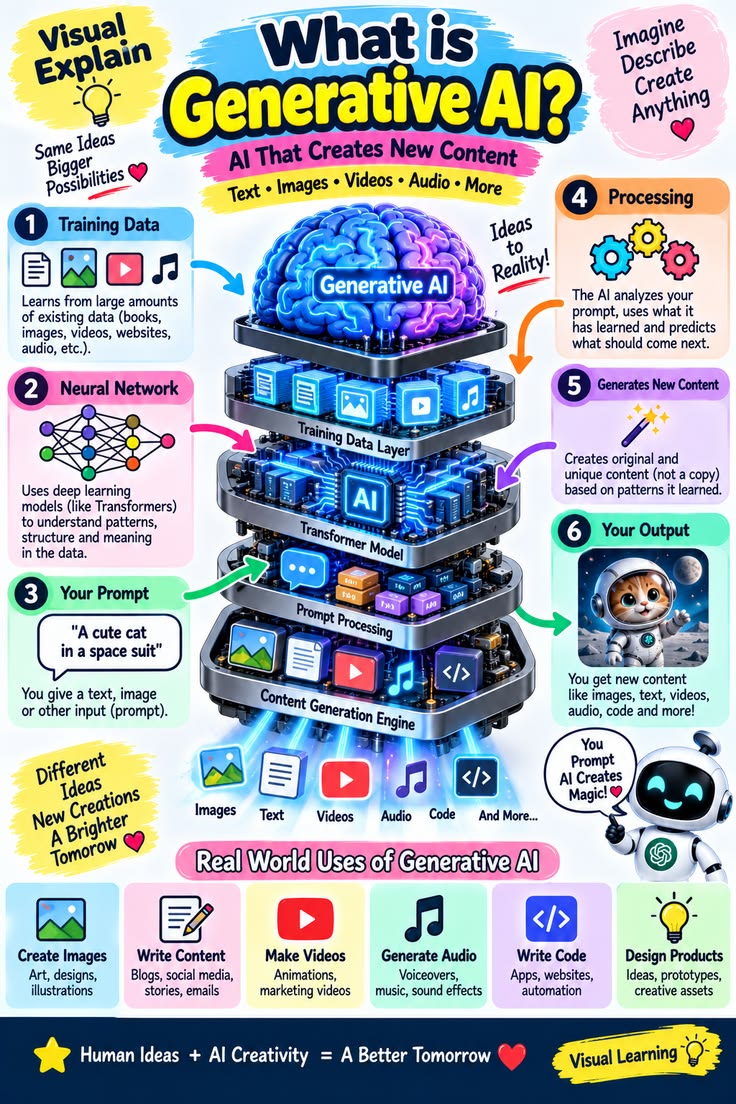
[1, 37, 50] - 面向初学者的教育信息图采用柔和的粉彩和卡通风格(黄/粉色、微笑机器人吉祥物、手绘箭头)——与新闻缩略图类型明显不同、更柔和,目标读者是还不了解“生成式 AI”含义的人。
[7] - 真正的技术图表非常罕见:样本中只有一个 Pin 展示了实际的模型架构图(文本嵌入 → 扩散 → 超分辨率阶段),即便如此也被包装成光鲜的杂志图形,而非研究插图。
[34]
值得注意的 Pin
- #48 — “Amuse 3.0”,一款 AI 艺术创作工具(pin)— 通过一张超写实肖像展示的 AMD 品牌本地运行图像生成器;在充斥闭源 SaaS 清单的样本中,它是唯一明确的本地/近似开源工具。
- #27 — Google 宣布视频生成 AI“Veo 3”(pin)— 展示一个毛绒怪物输入静帧,以及三个不同场景中的生成视频输出;也就是说,Veo 3 的图生视频一致性才是真正卖点。
- #46 — 字节跳动与好莱坞达成全球 AI 版权协议(pin)— 一张 Cointelegraph 风格新闻卡,报道 ByteDance–MPA 覆盖其图像/视频工具的知识产权协议,配图为皮克斯风格的生成男孩。
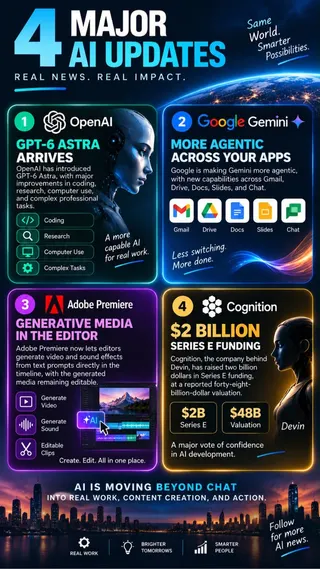
- #10 — “4 项重大 AI 更新”(pin)— 一张信息图同时提到 GPT-6 Astra、更具智能体特征的 Gemini、Adobe Premiere 内的生成媒体,以及 Cognition 的 20 亿美元 E 轮融资(估值 480 亿美元)。
- #49 — “今日 AI 新闻,2026 年 5 月 20 日”(pin)— Google I/O 回顾:Gemini 3.5 Flash、Gemini Omni、Gemini Spark,以及 AI 智能眼镜推进计划。
- #3 — Hollywood Reporter 采访首位 AI 女演员(pin)— 关于 AI 生成女演员 “Tilly Norwood” 的电视新闻字幕画面,图像本身盖有 “AI-GENERATED IMAGE” 标记。
- #41 — “超过 20% 的 YouTube 内容如今由 AI 生成”(pin)— 只有统计标题、没有支持图表的 Pin,作为事实呈现。
- #29 — “2026 年 10 款最佳免费 YouTube AI 视频生成器”(pin)— 样本中最广泛的单一工具汇总:Google Veo、Runway、Pika、invideo AI、CapCut、Synthesia、HeyGen,全部定位为免费且适合 YouTube。
- #34 — OpenAI 的秘密图像生成工具即将推出(pin)— 关于尚未发布的闭源工具的标题,配图是一张真正的(尽管杂志化)扩散管线图,而不是产品截图。
- #32 — “AI GENERATED” 与 “ORIGINAL CLIP” 的对比模因(pin)— AI 重现的人脸/手势与真实源视频并排,是平台持续存在的真实性辨认内容的一部分。
信号
- 当前趋势:Google Veo(2 和 3)是该看板上视觉重复率最高的视频模型,超过任何其他具名工具。多张 Pin 明确采用“AI 正从聊天走向真实工作”的叙事(Adobe Premiere 生成式时间线、Cognition 的 Devin 融资、Gemini 在 Gmail/Drive/Docs 中转向智能体化)。知识产权与版权协议(ByteDance × MPA)已是主流新闻题材,而非小众法律故事。“找出 AI”/真实性标签内容已形成独立类型,反映受众对虚假图像和 AI 演员(Tilly Norwood)的真实焦虑。不同标题下反复复用通用缩略图,也表明许多“新闻”内容是低成本内容农场产物,而非原创报道。
- 缺失内容:开源模型文化几乎不可见——没有出现 Stable Diffusion、Flux、ComfyUI、LoRA 或 GitHub 仓库截图;Amuse 3.0(#48)是样本中唯一接近本地/开源的工具,而且仍被包装为精致的消费级应用,而非开源项目。没有出现非英语 Pin。样本没有任何内容以视频形式播放——全部为静态缩略图,因此无法根据图像本身判断实际模型输出质量,只能判断其宣称的品质。
限制
- 根据操作手册,未直接浏览 Pinterest;本汇总完全基于工作者预收集的
output/pinterest.pins.md表格和images/pinterest/manifest.json/图像。它们均来自单一的未命名查询(“Image and Video Generation AI News”),而非按类型细分的检索——manifest 中每个 Pin 的genre字段均为空,因此无法撰写按类型比较。 - 50 个收集到的 Pin 中只打开了 30 个;其余 20 个因标题重复了已覆盖的形式(通用“AI 内容创作概念”图库条目、重复工具汇总图)而跳过——这是抽样检查,不是全量覆盖。
- 源表中有数个 Pin 标题为空(“(untitled)”);遇到这种情况时,上述描述基于图像本身可见的文字。
- 个别 Pin 的图中内容与标题并不完全对应(例如 #47 的图片是通用“AI NEWS”频道卡,并非具体的 Grok 5 内容),这本身支持上文的“重复通用缩略图”发现,但也意味着标题应被视为方向性信息,而不是经过确认的报道。
- 没有 Pin 显示可见发布日期;仅凭图像无法验证“新闻”主张的新鲜度(例如“20% 的 YouTube 内容由 AI 生成”的统计)。
建议行动
- 使用 “Sora 2”“Midjourney”“Stable Diffusion”“Runway Gen”“Kling AI”“open source image generation” 等主题直连搜索词重新收集 X 阶段数据
- 持续观察 MiniMax-H3、Qwen、Wan、Z-Image 等中国开源阵营的发布频率
- 除 AI 专业社区外,也追踪普通社区和实务社区的反应,监测对 AI 生成内容反弹的扩散
- 验证可解决 Bluesky 官方搜索 API 403 问题的替代访问方法
- 在下次运行中追踪 Sora 2 的“production memory”问题及 Midjourney 转向医疗水疗的后续消息
- 为 Pinterest 收集添加类型标签,以便自动区分开源/闭源内容
收集图片























数据质量说明
由于 X 的搜索词与主题无关,40 条内容中仅 0 条可用;Reddit(12 条)和 Bluesky(因搜索 API 被阻断、通过个人账号获取约 12 条)也未达到约 20 条的目标。Pinterest 基于未带类型标签的预收集数据,YouTube 则未能获取播放量和订阅数。